PDFium Component 通过 ExtractTables(针对单页)和 ExtractDocumentTables(针对整份文档)检测 PDF 页面上的表格,并把它们作为带行合并、列合并、表头行和置信度数值的单元格网格返回。每张表格都可以一次调用转换成 CSV 或 JSON,跨页延续的表格还能被链接成一条延续链
PDF 中没有表格这种对象。PDF 里的一张表格,是一组文本行的位置排布,使人类读起来像一个网格,有时四周画了线,很多时候并没有。恢复出这个网格,意味着重建一份文件从未记录过的意图,这也是为什么每一个表格提取工具产出的结果都略有差异,也是为什么一个会告诉你置信度的工具比不会的更有用
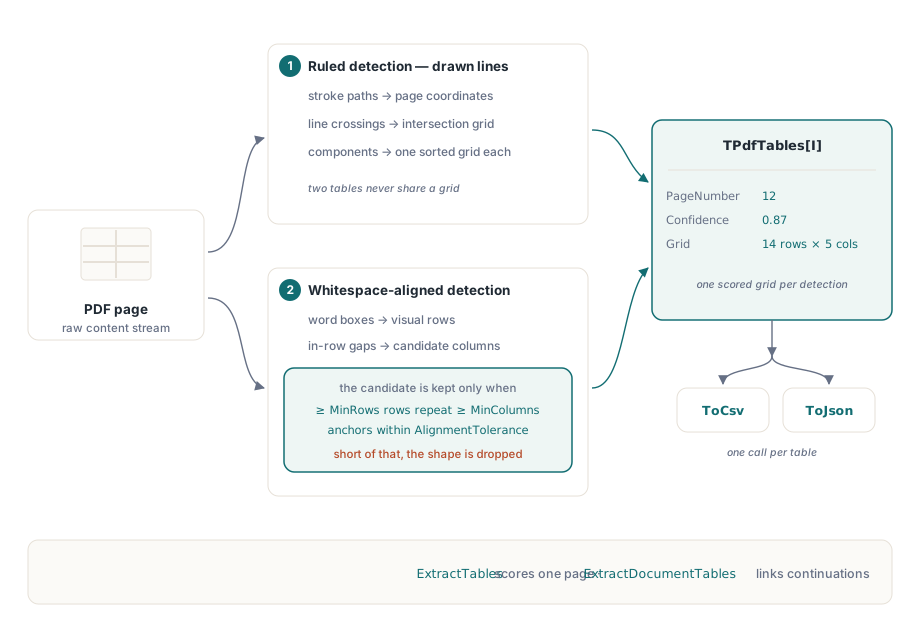
针对两类表格的两种检测模式
线框检测使用绘制出来的线条。每一段描边路径都通过页面对象的矩阵变换到页面坐标系中,水平线与垂直线求交,交点构成连通分量。每个连通分量都会形成一套各自独立、按 X、Y 位置排序的网格,这正是防止同一页上两张独立表格被合并成一张无意义网格的关键
空白对齐检测处理那些靠对齐而不是靠线条绘制的表格。词框被归并成视觉行,行内的间隙把它切分成候选列,只有当至少 MinRows 行在 AlignmentTolerance 容差范围内重复出现至少 MinColumns 个左对齐锚点时,才会被判定为一张表格。行间距因子默认为 3,这个值覆盖了 12 号字体典型的约 30 点基线间距,同时又不会让一行里包含好几段文本就被误判成一张表格
uses
  PDFium;

var
  Pdf: TPdf;
  Options: TPdfTableExtractionOptions;
  Tables: TPdfTables;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'annual-report.pdf';
    Pdf.LoadDocument;
    Pdf.PageNumber := 12;                    // 从 1 开始

    Options := TPdfTableExtractionOptions.Default;
    Options.DetectRuledTables := True;
    Options.DetectWhitespaceTables := True;
    Options.MinConfidence := 0.6;            // 默认值为 0.5
    Options.HeaderRowCount := 1;

    Tables := Pdf.ExtractTables(Options);
    for I := 0 to High(Tables) do
      Writeln(Format('table %d: %dx%d cells, confidence %.2f, mode %d',
        [I, Tables[I].RowCount, Tables[I].ColumnCount,
         Tables[I].Confidence, Ord(Tables[I].DetectionMode)]));

    if Length(Tables) > 0 then
      SaveText('page12-table0.csv', Tables[0].ToCsv);
  finally
    Pdf.Free;
  end;
end;完整工程随组件一同发布:Demo/Delphi/TableExtractionLab/TableExtractionLab.dpr,C++Builder 和 Lazarus 的对应版本分别位于 Demo/CBuilder/TableExtractionLab 和 Demo/Lazarus/TableExtractionLab。这个实验工程会构造一份样例文档,里面有一张带合并表头单元格的线框表格、一张完全没有线框、全靠空白对齐的表格,还有一张跨页断开的长表格;随后逐一提取,把单元格、跨度、置信度、延续组以及 CSV / JSON 输出展示出来——想观察这些选项如何相互影响,这是最快的办法。表格检测是 3.36.0 才加入的,所以如果 TPdfTableExtractionOptions 或 TPdfTables 编译时报未知标识符错误,说明你项目里那份库早于这个版本,需要先更新,这段代码才能编译通过
合并单元格是如何恢复出来的?
这正是朴素提取器容易做错的地方。仅凭全局网格无法识别出一个合并单元格,因为这张网格是根据页面上所有线条推导出来的,而一个合并区域恰恰缺少那条本该把它分隔开的内部线
这里采用的规则是局部性的:当两个相邻的基础单元格之间的区间没有任何边界线覆盖时,它们就会被判定为合并。并查集把它们连接起来,得到的矩形连通分量转化为 RowSpan 和 ColumnSpan 数值,文本则先按中心点归属到某个基础单元格,再跟随该单元格归并到其合并根节点。这样处理还能把开销保持在与词数加单元格数呈线性关系,而不是逐词与逐单元格比对所带来的平方级扫描
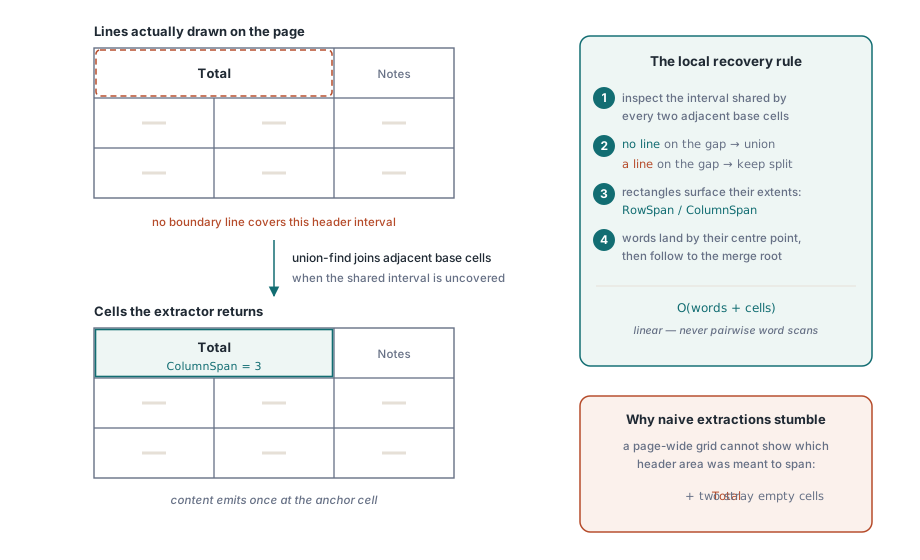
实际效果是,一张带有横跨三列的合并"合计"表头的财务表格,提取出来的是一个跨度为 3 的单元格,而不是一个有内容的单元格加两个莫名其妙的空单元格
跨页延续
长表格会跨页断开,如果把每一页上的片段当作独立的表格处理,就会迫使调用方自己去拼接。ExtractDocumentTables 可以代为链接它们,但条件很严格:前一页上的片段必须是该页最靠下的表格,下一个片段必须是下一页最靠上的表格,页码必须相邻,而且列边界必须一致
正是这四个条件同时满足,才能防止一个显而易见的错误——仅仅因为列数相同,就把文档里每一张四列表格都串成一张想象出来的超级大表。当条件满足时,这些表格会共享一个延续组标识符,并携带延续元数据;条件不满足时,你会得到各自独立的表格,可以自行决定如何处理
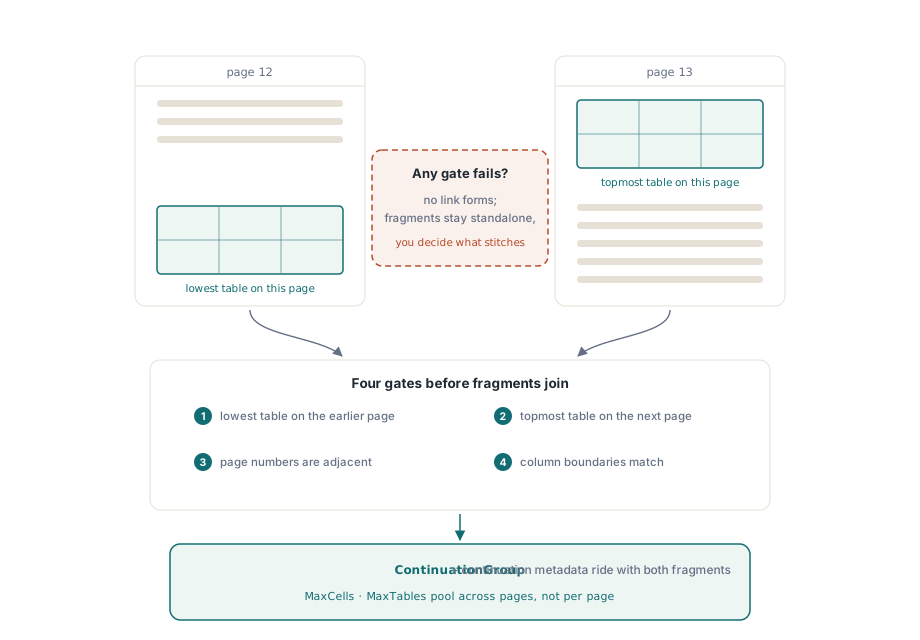
文档级提取会让 MaxCells 和 MaxTables 预算在各页之间共享,而不是逐页重置,并且会在一个 finally 代码块中恢复原来的当前页,因此在查看器中运行一次提取,不会让用户离开他们原本所在的那一页
导出而不破坏数据
两个导出器在转义处理上都很讲究。CSV 始终给字段加引号,并把字段内部的引号加倍,这避免了一个经典失败:一个包含逗号的单元格悄悄变成了两列。对于合并单元格,内容只在左上角锚点位置输出,因此一次 CSV 往返不会把一个跨列表头在它覆盖的每一列上都重复一遍
JSON 保留 Unicode 而不是把它转义成 ASCII,会转义控制字符,并且包含消费方判断质量所需的元数据:检测模式、置信度、边界、跨度数值、表头标记和延续信息。如果你要把提取出的表格喂给下游系统,优先选择 JSON,因为一行 CSV 无法告诉你它所在的那张表置信度只有 0.51:
// 全文档提取,只保留值得信任的表格
Tables := Pdf.ExtractDocumentTables(Options);
for I := 0 to High(Tables) do
begin
  if Tables[I].Confidence < 0.75 then
  begin
    Log(Format('page %d table needs review (%.2f)',
      [Tables[I].PageNumber, Tables[I].Confidence]));
    Continue;
  end;
  if Tables[I].ContinuationGroup > 0 then
    AppendToGroup(Tables[I].ContinuationGroup, Tables[I].ToJson)
  else
    EmitStandalone(Tables[I].ToJson);
end;
调优,以及知道该在哪里止步
有三项设置比其余的更重要。MinConfidence 是质量关卡,0.5 这个默认值是刻意宽松的;面向自动化摄入时应该调高,面向由人工确认每条结果的审核界面时则应该调低。MinColumnGap 决定在空白模式下什么算作一条列边界,密集报表中排得很紧的表格可能需要把它从默认的 12 点调小。MaxRowGapFactor 决定垂直方向多大距离算作一张表格的结束,这对偶尔出现空行的表格很重要
要对局限性保持诚实。带线框的表格提取效果可靠。排列整齐的空白对齐表格提取效果也不错。带旋转文字的表格、嵌套表格,或者内容会换行而看起来像另一行的单元格,无论参数怎么调都需要人工复核。对于这些情形,结构化文本模型能给你构建一个针对特定领域的读取器所需的原始素材,见 结构化文本块与阅读顺序
一个有用的组合:当一份扫描文档完全没有文本时,表格检测在文本层出现之前无从下手。应先按 为扫描 PDF 添加可搜索文本层 中所述加上一层文本,再进行提取。OCR 提供者返回的词框,正是空白检测所需要的输入
表格提取、结构化文本和重排版,在 Delphi、C++Builder 和 Lazarus 中都读取自同一套页面模型;完整 API 说明见 PDFium Component for Delphi 页面