Word 导出里跨三页的表格,离纸的底边永远不会小于 72 点。一英寸页边距就是 72 点,文字处理器到页边就停着不放行了。只在片段落在页缘 36 点之内才拼接的链接器,看到的是三张列完全相同的互不相干表格。管用的问题是另一个:在上一片段的结尾与下一片段的开头之间,除了页眉页脚,还有没有别的东西?
这个问题自带两个陷阱。表单可以在第 1 页底部结束一张表,再在第 2 页顶部开出一张列宽相同的另一张表。带线的网格还可能把单独一行挤过分页点——对想先看到两行才肯认表的检测器来说,它太短了
ExtractDocumentTables 里的两个边缘测试
PDFium Component 在 TPdf.ExtractDocumentTables 里标记延续——表格检测与提取一文所讲逐页 ExtractTables 的文档级对应物。设了 DetectContinuations——TPdfTableExtractionOptions.Default 里默认就设了——方法会提取每一页,按页码、再按每页内自上而下的顺序给表格排序,然后检查列表里每一对相邻项。只比较相邻项。因此延续候选永远是第 N 页最靠下的表配第 N+1 页最靠上的表,第 N 页放在长表下面的小表会在配对中顶替长表。短便签表在长表下面时,请在自己的代码里按页码和 ColumnCount 把那些片段接起来
第一个测试纯几何。前一片段的底边必须落在距页底 ContinuationMargin 点之内,后一片段的顶边必须落在距下页页顶同样距离之内。默认 36 点,半英寸。排版引擎填固定内容框产出的报告轻松通过。一英寸页边距的 Word 导出两边都至少差 36 点,而把边距放宽到能通过又会出事,因为同一个数字还定着第二个测试的页眉页脚带
第二个测试——内容感知的那个——就是处理文字处理器输出的。两者按 OR 组合:任一个开门
两个片段之间什么算文本?
页面上每个词都算正文文本,除非它完全落在页眉带或页脚带内——两条带都是 ContinuationMargin 点深。每页,ExtractDocumentTables 记录“顶部高于页脚带的词”中最低的底边,以及“底部低于页眉带的词”中最高的顶边——表格自己的单元格文本也计入。表格是第 N 页最后一段正文内容时,它的底边位于最低词的下方或同一位置,测试在 AlignmentTolerance——默认 3 点——内通过。后一片段得在下页页顶满足镜像条件
无视这两条带在规范里有依据。ISO 32000-1 第 14.8.2.2 节把页眉、页脚和页码当成分页产物——只因文档被切成页才存在的内容。带标签的文件可以用 /Artifact 声明它们,如标记内容一文所讲,但最需要拼表的导出物很少带标签,所以位置代替标签。默认带宽下,字形顶到页底之上 30 点的页码会被无视。够到 40 点的免责声明行是正文,它挡住拼接
没有文本层的页面上,记录的极值回退到页面边界,内容感知测试平凡通过,剩下的闸门说了算。以图像或矢量轮廓画的页脚出于同样原因不可见,从不挡拼接
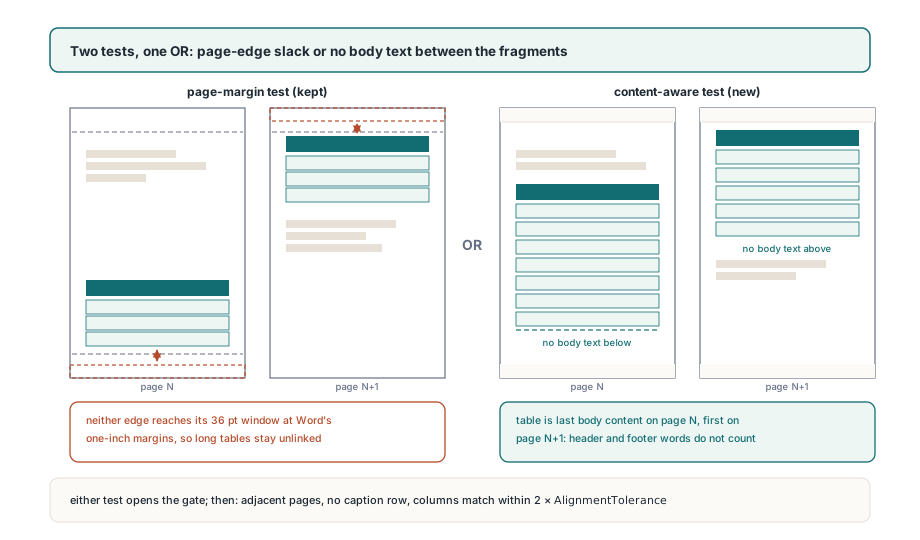
通过边缘测试只是开门。页码必须相邻,后一片段不能以标题行开场,列边界必须在两倍 AlignmentTolerance——默认 6 点——内对齐。全部成立时,前一片段成为带新组号的 ptcStart,或从 ptcEnd 挪到 ptcMiddle(若它已收过一条链),后一片段成为同组的 ptcEnd。铺三页的表读出来是 start、middle、end。组号从 1 起;ptcNone 的组 0 表示表格独来独往。ToJson 把同样的数据写成 "continuationGroup" 和 "continuation"(none、start、middle 或 end),收 JSON 的服务可以自己拼
下面的清单假设 Word 导出带约 50 点深的两行页脚,所以边距提到 54,让两行都落在带内
uses
  System.SysUtils, PDFium;

var
  Pdf: TPdf;
  Options: TPdfTableExtractionOptions;
  Tables: TPdfTables;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'itinerary-from-word.pdf';
    Pdf.LoadDocument;

    Options := TPdfTableExtractionOptions.Default;  // DetectContinuations = True
    Options.ContinuationMargin := 54;               // 假设页脚约 50 点深

    Tables := Pdf.ExtractDocumentTables(Options);
    for I := 0 to High(Tables) do
      case Tables[I].Continuation of
        ptcStart:
          Writeln(Format('group %d starts on page %d, %d rows',
            [Tables[I].ContinuationGroup, Tables[I].PageNumber,
             Tables[I].RowCount]));
        ptcMiddle, ptcEnd:
          Writeln(Format('group %d continues on page %d, %d rows',
            [Tables[I].ContinuationGroup, Tables[I].PageNumber,
             Tables[I].RowCount]));
      else
        Writeln(Format('standalone table on page %d, %d x %d',
          [Tables[I].PageNumber, Tables[I].RowCount,
           Tables[I].ColumnCount]));
      end;
  finally
    Pdf.Free;
  end;
end.
通栏首行怎么把两张表分开
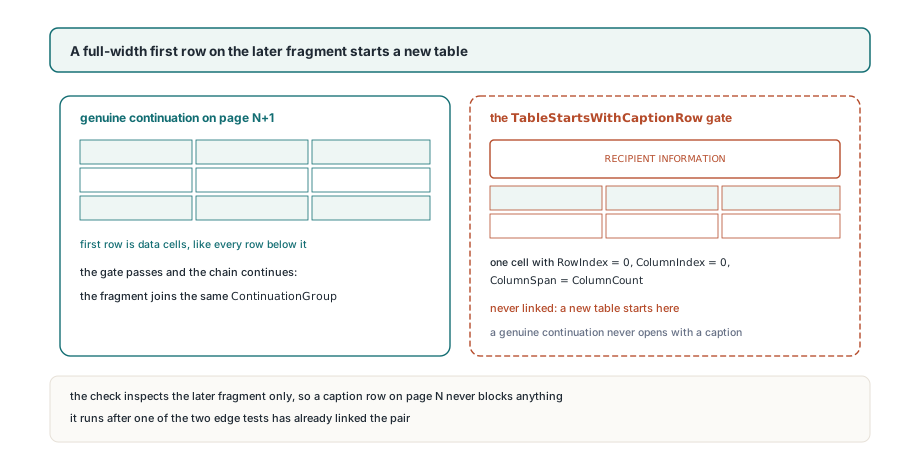
首行是横跨所有列的单一单元格的后一片段,会被报成新表——哪怕边缘测试通过、列也吻合。表单正是内容感知测试会越界的地方:一张表在第 1 页底部附近结束,下一节在第 2 页以完全相同的列宽开场,每项几何检查都过。差别在第二张表的开场行——一条像 RECIPIENT INFORMATION 这样的节标题,摆成通栏合并单元格。真正的延续不会这样开场,因为表格的标题留在表格开始的那一页
这条规则只读后一片段的单元格。该片段至少两列,且有一个 RowIndex = 0、ColumnIndex = 0、ColumnSpan = ColumnCount 的单元格。前一片段从不检查,所以自己的标题坐在第 N 页顶部的表,能正常接到第 N+1 页的延续
接下来的列比较比“列数相等”更严。每个片段的边界位置由它的单元格矩形重建;藏在合并单元格下的边界,按两侧最近已知边界等距补齐。然后每一对边界都比较,差超过 6 点拒绝接链。两张比例不同的四列表保持分开。真正的延续但生成器在两页之间把某列挪了 8 点的也一样;把 AlignmentTolerance 调大来收它,检测期用的聚类也会跟着松
分页点上的单行画线表格
把单独一行挤到下页的画线网格,接进链时保住那行,没接上就丢掉。默认 MinRows 为 2,拦住两条游离线被报成表格。被挤过分页点的那行不同:它是真实数据,丢掉它,拼好的表就少一行,又没有片段能解释这个缺口
文档扫描分三步处理。DetectContinuations 和 DetectRuledTables 都开时,画线检测器在每页运行,行数下限降到 1。接着在整个结果上标记延续。最后,行数少于调用方 MinRows、又没进任何链的表全部删除。普通页面中间的单行网格过这道滤网消失——这正是 MinRows 的用途
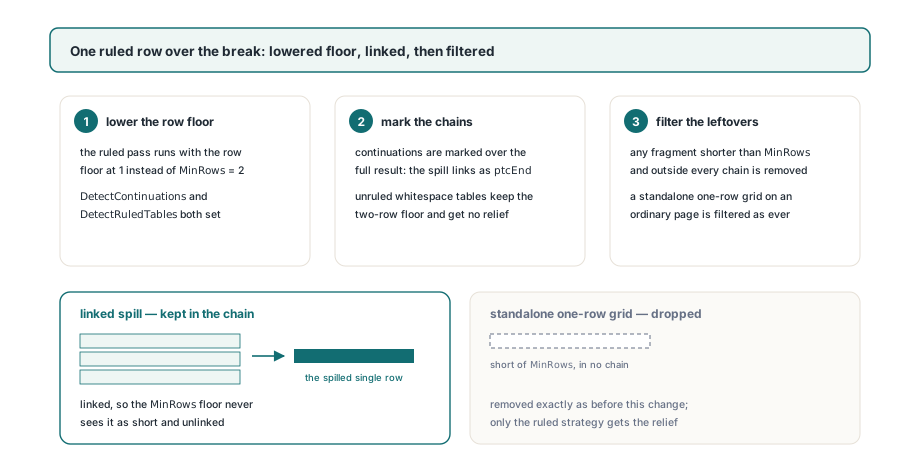
MinRows 保持 2。自己设成 1 会关掉最后的滤网,每页每个单行画线网格都回来
豁免只给画线网格。空白策略至少要两行对齐才认表,所以不管 MinRows 说什么,它内部都守着 2 的下限;ExtractTables 接受 MinRows = 1,但只有画线检测兑现它。不带线又溢出一行的表,页面词框或结构化文本块与阅读顺序所讲的块,给你自己找回那行的位置
把一条链拼回一张表
链回来时是连续的。接链只在排序数组的相邻项之间发生,所以 ptcStart 片段后面紧跟着它的 ptcMiddle 和 ptcEnd 片段,一个在 ptcNone 或 ptcStart 上重置、在 ptcNone 或 ptcEnd 上写出的循环,永远不必按组号查任何东西
重复的表头行是麻烦所在:Word 会在每页重复它,别的生成器不会。TPdfTableCell 的 IsHeader 标志定不了这事,因为它按位置指派——RowIndex < HeaderRowCount——且对每个片段单独算。延续的第 0 行不管是重复表头还是带数据都打着表头标志,上一节那行被挤出去的行也打着。下面的例程把每个延续的首行文本与链的首行比较,仅在完全一致时丢弃
它还从 Cells 构建行,而不是把 ToCsv 输出按行拆开。文本在单元格内折行的单元格回来时视觉行之间带着 CR LF,ToCsv 把这个换行留在带引号的字段里,删掉 CSV 文本的第一行会把两行的表头单元格拦腰斩断
// 读取侧辅助函数(不是库的一部分):把每条链
// 重建成一个制表符分隔文件,丢弃后续页上重复的表头
function RowText(const T: TPdfTable; Row: Integer): string;
var
  Parts: array of string;
  I: Integer;
begin
  SetLength(Parts, T.ColumnCount);
  for I := 0 to High(T.Cells) do
    if (T.Cells[I].RowIndex = Row) and (T.Cells[I].ColumnIndex >= 0) and
       (T.Cells[I].ColumnIndex < T.ColumnCount) then
      Parts[T.Cells[I].ColumnIndex] :=
        StringReplace(string(T.Cells[I].Text), #13#10, ' ', [rfReplaceAll]);
  Result := '';
  for I := 0 to High(Parts) do
  begin
    if I > 0 then
      Result := Result + #9;
    Result := Result + Parts[I];
  end;
end;

procedure ExportChains(const Tables: TPdfTables; const Folder: string);
var
  I, R, FirstRow: Integer;
  Header: string;
  Lines: TStringList;
begin
  Lines := TStringList.Create;
  try
    for I := 0 to High(Tables) do
    begin
      FirstRow := 0;
      if Tables[I].Continuation in [ptcNone, ptcStart] then
      begin
        Lines.Clear;
        Header := RowText(Tables[I], 0);
      end
      else if (Trim(Header) <> '') and (RowText(Tables[I], 0) = Header) then
        FirstRow := 1;                     // 本页重复了表头
      for R := FirstRow to Tables[I].RowCount - 1 do
        Lines.Add(RowText(Tables[I], R));
      if Tables[I].Continuation in [ptcNone, ptcEnd] then
        Lines.SaveToFile(Format('%s\table%d-page%d.tsv',
          [Folder, I, Tables[I].PageNumber]));
    end;
  finally
    Lines.Free;
  end;
end;
精确比较是对的。文字处理器重复的表头逐字符一致,而模糊匹配迟早会吞掉一行长得像表头的数据行。输出里多出来的表头一眼可见;少掉的数据行无声无息
量出页脚带,而不是猜
ContinuationMargin 用一个数干三件事:第一个测试的页缘余量、第二个测试的页脚带深和页眉带深。页脚比带深,它的上一条线就留在正文区,前一片段看着像后面还有文本,链在那个页面断掉。带设太深则开始吞真内容:底边距上方一点点的短结语行落进带内,那行上面的表就可能接到下一页开场的任何东西上
文档自己能供这个数。TPdf.PageWordBoxes 返回当前页每个词,页面空间 Rect 的 Top 大于 Bottom,所以正文边距之下的词里最高的 Top 就是页脚深度。下面的探测取比排版底边距略小的值——一英寸页取 70——并给没有页脚的文档保底 36 点
// 读取侧辅助函数(不是库的一部分):任何页面上
// BodyMargin 之下找到的最高词顶,即页脚区深度
function MeasureFooterDepth(Pdf: TPdf; BodyMargin: Double): Double;
var
  P, I: Integer;
  Words: TPdfWordBoxes;
begin
  Result := 0;
  for P := 1 to Pdf.PageCount do
  begin
    Pdf.PageNumber := P;
    Words := Pdf.PageWordBoxes;
    for I := 0 to High(Words) do
      if (Words[I].Rect.Bottom < BodyMargin) and
         (Words[I].Rect.Top > Result) then
        Result := Words[I].Rect.Top;
  end;
end;

// 用 System.Math 的 Max
Options := TPdfTableExtractionOptions.Default;
Options.ContinuationMargin := Max(36.0, MeasureFooterDepth(Pdf, 70) + 2);
Tables := Pdf.ExtractDocumentTables(Options);
两条带在两缘同深,所以页顶方向的深页眉也要量,取较大值。余量留两三点就够;每多一点,都是内容感知测试少看一点正文
有一种排版天生让标题规则失效:生成器把合并的“continued”横幅写成每个延续片段的首行。每个这样的片段都被报成新表,请在自己的代码里按连续页码、相同 ColumnCount 和行 0 里的横幅文本把它们接起来
延续标记、标题规则和单行豁免都在 ExtractDocumentTables 内部运行,Delphi、C++Builder 和 Lazarus 版行为一致。表格提取选项全表见 PDFium Component for Delphi 页面