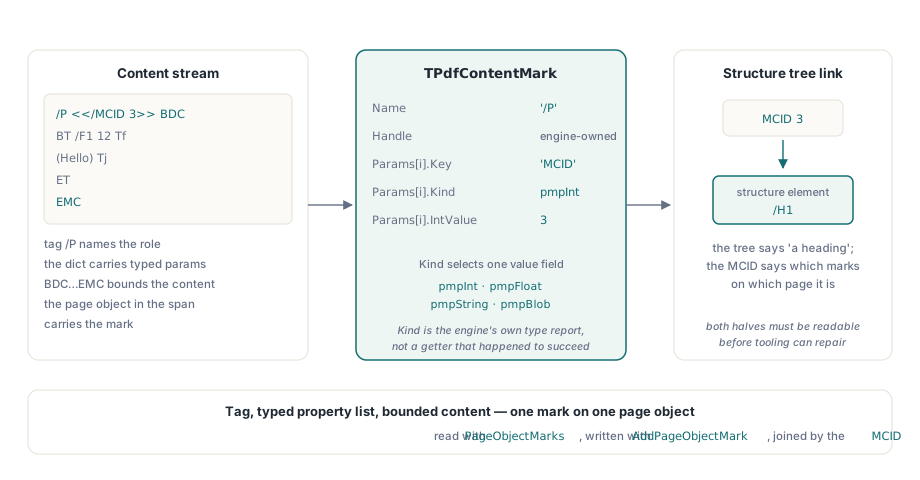
在标签化 PDF 里,每页顶部的页眉通常包在 /Artifact <</Type /Pagination>> BDC … EMC 之中,而它下面的第一段则包在 /P <</MCID 0>> BDC … EMC 之中。按 ISO 32000-1 §14.6 的定义,两者都是标记内容。只有段落能从结构树到达,因为只有段落携带标记内容标识符,正是这个整数把绘制出来的字形和 /H1、/P 这样的结构元素绑在一起。因此,审计或修复标签化的代码要从每个页面对象上读出三样东西(标签、属性列表和 MCID),再把数字与该页结构元素实际认领的 MCID 对照
从 Delphi 读取 BDC 标记与属性列表
在 PDFium Component 中,TPdf.PageObjectMarks(Index) 返回包围 Index 处页面对象的所有标记,形式是 TPdfContentMark 记录数组。每条记录在 Name 里携带标签,带一个装着属性列表的 Params 数组,还有一个 Handle。名字返回时不含前导斜杠:/P 序列报告 P,工件报告 Artifact。标记内容序列可以嵌套——/Sect 里再套 /P、再套 /Span 的一段字形,会在同一对象上报告三条记录,最外层在前
ISO 32000-1 §14.6.2 允许 BDC 的属性列表操作数取两种形式:内联字典,如 /P <</MCID 3>> BDC;或者一个名字,如 /OC /oc1 BDC,指向页面资源的 /Properties 子字典。可选内容(§8.11.3.2)就以后一种形式书写。PDFium 在解析页面时会解析名字形式,所以两种情况下 Params 列出的都是作用于该序列的字典条目
TPdf.PageObjectMarkedContentID(Index) 回答的是结构树关心的那个问题。它返回对象标记中找到的 MCID,当没有任何标记携带整数 /MCID 时返回 -1。开头例子里的页眉返回 -1,这是正确的:§14.8.2.2 把工件留在逻辑结构之外,工件没有任何东西可供关联
var
  Marks: TPdfContentMarks;
  M: TPdfContentMark;
  P: TPdfContentMarkParam;
  I: Integer;
begin
  Pdf.PageNumber := 1;                    // PageNumber 从 1 开始
  for I := 0 to Pdf.ObjectCount - 1 do    // 页面对象索引从 0 开始
  begin
    Marks := Pdf.PageObjectMarks(I);
    if Length(Marks) = 0 then
      Continue;
    Memo1.Lines.Add(Format('object %d, MCID %d',
      [I, Pdf.PageObjectMarkedContentID(I)]));
    for M in Marks do                     // 最外层标记在前
    begin
      Memo1.Lines.Add('  mark ' + M.Name);
      for P in M.Params do
        case P.Kind of
          pmpInt:     Memo1.Lines.Add('    ' + P.Key + ' = ' + IntToStr(P.IntValue));
          pmpFloat:   Memo1.Lines.Add('    ' + P.Key + ' = ' + FloatToStr(P.FloatValue));
          pmpString:  Memo1.Lines.Add('    ' + P.Key + ' = ' + P.StringValue);
          pmpBlob:    Memo1.Lines.Add('    ' + P.Key + ' = ' +
                        IntToStr(Length(P.BlobValue)) + ' bytes');
          pmpUnknown: Memo1.Lines.Add('    ' + P.Key + ' = (no readable value)');
        end;
    end;
  end;
end;
pmpUnknown 能告诉你什么、不能告诉你什么
每个 TPdfContentMarkParam 有一个 Key、一个 Kind,以及一个由该 kind 选定的值字段。这组对应关系短小,可以记在脑子里:
- 整数值的数变成
pmpInt,IntValue被设置,FloatValue填入同一个数,所以/MCID 3和混进来的3.0都按整数读取 - 带小数部分的数变成
pmpFloat - PDF 字符串和 PDF 名字都变成
pmpString;以 UTF-16 字节序标记(FE FF或FF FE)开头的文本字符串会解码进StringValue,所以/ActualText到手就是可读文本 - 其他值类型在 PDFium 交出原始字节时以
pmpBlob返回,否则保持pmpUnknown
pmpUnknown 覆盖两种无法区分的情形。一种是 PDFium 报告为 FPDF_OBJECT_UNKNOWN 且不交出任何字节的值;另一种是列在表中却读不回来的键:受损文件里以非 ASCII 字节拼出的键可能出现在列表里,却仍以 pmpUnknown 返回。无论哪种,记录看上去都一样
把 pmpUnknown 当作"没有可用值",报告该标记而不是默默接受。如果你的工作流依赖 /Lang 或 /ActualText 存在,就用一个你认识的 kind 去找那个键;永远不要从一个未知 kind 推断属性不存在
Handle 标识的是当前已加载页面内的一个标记,一旦标记被移除、页面对象被销毁或页面被卸载,它就失效。切换页面前,先把 Name 和 Params 拷进你自己的结构。需要跨页面存活的数据——比如列表视图或后台审计——用 ReadPageObjectsSnapshot,它返回的 TPdfContentMarkSnapshot 记录只装名字和参数,完全没有句柄。这条规则对页面对象句柄普遍适用,变换之后失效的页面对象句柄笔记里有详细说明
添加、更新与移除标记
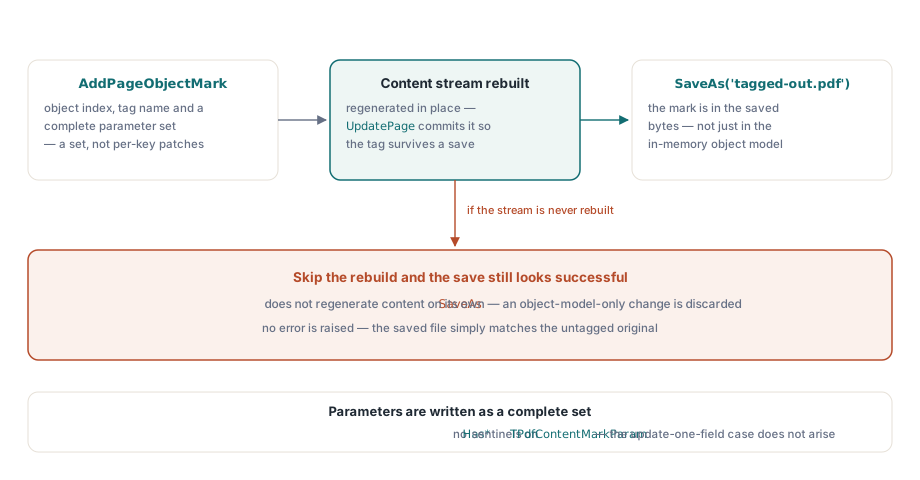
四个调用覆盖编辑。AddPageObjectMark(Index, Name, Params) 在对象上创建一个新标记,按顺序应用参数,返回新标记在该对象上的索引,其余三个调用把它当作 MarkIndex 传入。名字不带斜杠写入:'P'、'Span'。要改一个键,SetPageObjectMarkParam(Index, MarkIndex, Param) 会插入或替换它,标记上其余参数原样不动。移除类调用更直接:RemovePageObjectMarkParam(Index, MarkIndex, Key) 丢掉一个键;RemovePageObjectMark(Index, MarkIndex) 丢掉整个标记
AddPageObjectMark 把标记和它的参数当作一步处理。某个参数被拒绝(pmpUnknown kind、空键、空 blob)时,刚创建的标记会在异常向上传播之前被删掉,对象上绝不会留下一个只带半份属性列表的标签
这些调用每一个都会在返回前重建页面内容流。这一点很关键,因为 SaveAs 按内容流的现状写出,不会从 PDFium 的对象模型重新生成。只存在于内存对象上的标记,会让保存出的文件里一个 BDC 算子都没有。如果你还通过原始 PDFium 导入函数在 ObjectHandle 上编辑页面对象,保存前请自己调用 UpdatePage
每次调用都重建整个流,改几处没问题,改几百处就是浪费。把一份未标签化的报告逐页打标签是另一类活儿,这类编辑应该放进 BeginPageObjectEditTransaction 和 CommitPageObjectEditTransaction。事务内每次编辑只把页面标为已更改;提交时内容流只生成一次,RollbackPageObjectEditTransaction 则把页面放回原样。事务绑定一个页面,事务开着时把 PageNumber 设到另一页会抛异常。已签名文档上,begin 调用会拒绝开始,除非你传入 AllowSignedDocument = True——反正编辑页面内容就会破坏签名
字符串参数还牵涉一个决定。pmpString 值按字节字符串写出,对 /Lang (en-US) 这类 ASCII 值恰好合适。带重音、连字或 CJK 字符的替换文本应放进按 UTF-16BE 编码、带 FE FF 前缀(§7.9.2.2)的 PDF 文本字符串。那些字节按 pmpBlob 传入:PDFium 把它们存成字符串对象,上面的读取端再把它解码回 StringValue,得到 pmpString
// 你自己的辅助函数,不属于库:带 BOM 的 UTF-16BE PDF 文本字符串
function Utf16TextString(const S: string): TBytes;
var
  I: Integer;
begin
  SetLength(Result, 2 + Length(S) * 2);
  Result[0] := $FE;
  Result[1] := $FF;
  for I := 1 to Length(S) do
  begin
    Result[I * 2] := Byte(Ord(S[I]) shr 8);
    Result[I * 2 + 1] := Byte(Ord(S[I]));
  end;
end;

procedure TagWord(Pdf: TPdf; ObjectIndex, Mcid: Integer; const Spoken: string);
var
  Params: TPdfContentMarkParams;
  Lang: TPdfContentMarkParam;
  MarkIndex: Integer;
begin
  Pdf.BeginPageObjectEditTransaction;
  try
    SetLength(Params, 2);
    Params[0].Key := 'MCID';
    Params[0].Kind := pmpInt;
    Params[0].IntValue := Mcid;
    Params[1].Key := 'ActualText';
    Params[1].Kind := pmpBlob;            // 以文本字符串存储,读回为 pmpString
    Params[1].BlobValue := Utf16TextString(Spoken);
    MarkIndex := Pdf.AddPageObjectMark(ObjectIndex, 'Span', Params);

    Lang := Default(TPdfContentMarkParam);
    Lang.Key := 'Lang';
    Lang.Kind := pmpString;               // ASCII 值,普通字节字符串即可
    Lang.StringValue := 'de-DE';
    Pdf.SetPageObjectMarkParam(ObjectIndex, MarkIndex, Lang);
  except
    Pdf.RollbackPageObjectEditTransaction;
    raise;
  end;
  Pdf.CommitPageObjectEditTransaction;    // 整批编辑只重建一次内容流
end;
提交特意放在 try 块之外。内容生成失败时,CommitPageObjectEditTransaction 会先自行恢复页面再重新抛出,此时再调一次 rollback 只会拿"没有活动的页面对象编辑事务"盖住真正的错误
为什么一个段落会落进三条 MCID 5 序列?
因为每个 AddPageObjectMark 调用都会创建一个新的、独立的标记字典,即使值完全相同。一个段落排版成三个文本对象、每行一个,用三次调用各传 /MCID 5 打标签,就带上三条彼此独立的标记。PDFium 重新生成内容流时,只有共享同一标记的相邻对象才会被收进同一个 BDC/EMC 对;比较的是标记的身份,值相等不算数。保存出的页面里就有三条 /P <</MCID 5>> BDC … EMC 连在一起
ISO 32000-1 §14.7.4.2 规定 MCID 在其内容流内唯一标识一个标记内容序列。三条序列共用一个标识符不满足这一点,经由页面父树条目解析 MCID 的工具只能去猜结构元素指的是三条中的哪一条
SharePageObjectMark(TargetIndex, SourceIndex, SourceMarkIndex) 把源标记自己的属性字典挂到目标对象上,而不是复制一份。把标记加到第一行,共享给其余各行,并让对象在绘制顺序上保持相邻;重新生成的流就会把三行包进同一条序列
procedure TagParagraph(Pdf: TPdf; const LineObjects: array of Integer; Mcid: Integer);
// LineObjects:段落各行的对象索引,按绘制顺序相邻
var
  Params: TPdfContentMarkParams;
  MarkIndex, I: Integer;
begin
  SetLength(Params, 1);
  Params[0].Key := 'MCID';
  Params[0].Kind := pmpInt;
  Params[0].IntValue := Mcid;

  Pdf.BeginPageObjectEditTransaction;
  try
    MarkIndex := Pdf.AddPageObjectMark(LineObjects[0], 'P', Params);
    for I := 1 to High(LineObjects) do
      Pdf.SharePageObjectMark(LineObjects[I], LineObjects[0], MarkIndex);
  except
    Pdf.RollbackPageObjectEditTransaction;
    raise;
  end;
  Pdf.CommitPageObjectEditTransaction;
end;
把既有标记复制到新内容上时——比如把工件延伸到一条重绘的页脚线上——共享还有第二个好处。PDFium 能写出的参数 kind 是整数、浮点、字符串和字节 blob,没有名字 kind。一条按 pmpString 读出的 /Artifact <</Type /Pagination>>,经 AddPageObjectMark 重建后会变成字符串 (Pagination),而 §14.8.2.2 期待的是名字 /Pagination。共享的标记就是原字典,名字还是名字。只要源标记在页面上已存在,就共享;只有写一个从未存在过的标记时才从 Params 重建
把 MCID 与结构树对照
页面对象上的 MCID 只有在同行某个结构元素认领它时才有意义。StructureElementsForPage[PageNumber] 以 TPdfStructureElement 记录返回页面元素,三个字段携带 MCID:MarkedContentID(元素没有时为 -1)、MarkedContentIDs(拥有多条序列的元素)、ChildMarkedContentIDs(子项是元素而非标记内容的槽位填 -1)。审计必须三个都查,因为结构元素的 /K 条目可以在一个数组里混装子元素和标记内容引用
下面的审计报告两类发现。MCID 没有任何元素认领、或根本没有 MCID 的文本和图像,是辅助技术会跳过的内容;MCID 被认领的 Artifact 则直接违反 §14.8.2.2。页面对象来自 ReadPageObjectsSnapshot,结果里不含句柄,可以安然度过页面切换
// 你自己的辅助函数,不属于库
function McidClaimed(const Elements: TPdfStructureElements; Mcid: Integer): Boolean;
var
  E: TPdfStructureElement;
  Id: Integer;
begin
  for E in Elements do
  begin
    if E.MarkedContentID = Mcid then
      Exit(True);
    for Id in E.MarkedContentIDs do
      if Id = Mcid then
        Exit(True);
    for Id in E.ChildMarkedContentIDs do
      if Id = Mcid then
        Exit(True);
  end;
  Result := False;
end;

procedure AuditPage(Pdf: TPdf; PageNo: Integer; Log: TStrings);
var
  Snap: TPdfPageObjectsSnapshot;
  Status: TPdfPageObjectSnapshotStatus;
  Elements: TPdfStructureElements;
  Obj: TPdfPageObjectSnapshot;
  IsArtifact: Boolean;
  J: Integer;
begin
  Snap := Pdf.ReadPageObjectsSnapshot(PageNo,
    TPdfPageObjectSnapshotOptions.Full, Status);
  if not Status.Completed then
    Log.Add(Format('page %d: snapshot hit a limit, results are partial', [PageNo]));
  Elements := Pdf.StructureElementsForPage[PageNo];
  for Obj in Snap.Objects do
  begin
    IsArtifact := False;
    for J := 0 to High(Obj.Marks) do
      if Obj.Marks[J].Name = 'Artifact' then
        IsArtifact := True;
    if IsArtifact then
    begin
      if (Obj.MarkedContentID >= 0) and McidClaimed(Elements, Obj.MarkedContentID) then
        Log.Add(Format('object %d: artifact claimed by the structure tree', [Obj.Index]));
    end
    else if Obj.ObjectType in [otText, otImage] then
      if (Obj.MarkedContentID < 0) or not McidClaimed(Elements, Obj.MarkedContentID) then
        Log.Add(Format('object %d: content with no structure owner', [Obj.Index]));
  end;
end;
路径是有意不放进去的。装饰线和表格边框往往没有标签,把每一条都报出来会淹没文本类发现。Form XObject 则需要反向的谨慎:表单内部的 MCID 属于该表单自己的 /StructParents 命名空间,页面上的 MCID 0 和表单里的 MCID 0 是两条不同的序列。标签化 Form XObject 中的 MCID 命名空间这篇详解讲了如何正确读取它们
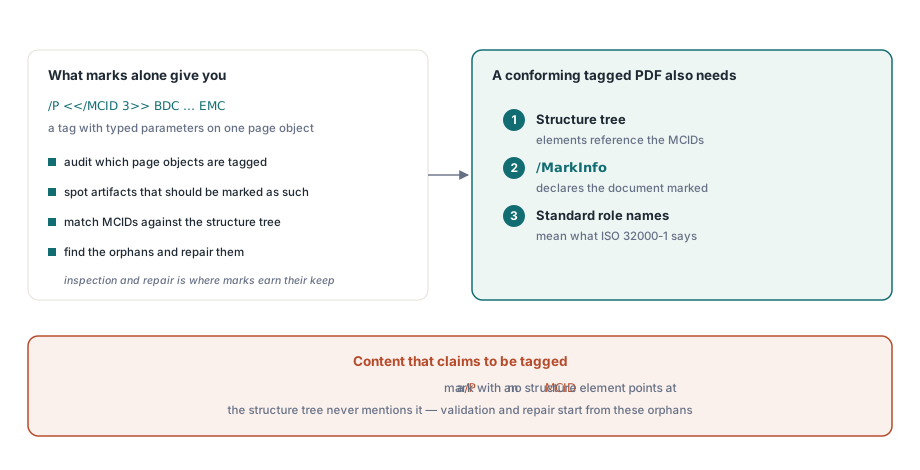
标记仍只是标签化文档的一半。ISO 32000-1 §14.7 要求一棵结构树,其元素引用这些 MCID;要求目录里有带 /Marked true 的 /MarkInfo 字典;还要求结构类型要么是标准类型,要么经角色映射对应到标准类型。Pdf.IsTagged 会告诉你目录是否声明文档已标签化。一条 MCID 没有任何元素指向的 /P 标记,产出的是自称已标签化的内容,而结构树从不提及那个页面
要做这项工作的结构树那一半,PDF/UA 结构树校验的详解会从 MCID 审计停下的地方接着走。这些标签最终为之服务的阅读体验,则是构建 Delphi 无障碍 PDF 阅读器笔记的主题
这里用到的调用(标记读取、编辑事务、共享标记、页面对象快照和结构元素)都属于 PDFium Component 在 PDFium 引擎之上提供给 Delphi、C++Builder 和 Lazarus 项目的同一套 VCL API。PDFium Component 产品页涵盖了无障碍与页面编辑 API 的其余部分