你的预检报告指出文件符合 PDF/UA 标准。veraPDF 打开同一个文件时,却在条款 7.3 下标示出一个没有替代文字的图形 (Figure)。这两个工具都是对的,而它们之间的落差,正是透过扫描字节来检查无障碍访问 (accessibility) 的整体问题所在。字节等级的扫描只能确认文件宣告其具有标记 (tagged):它找到了 /StructTreeRoot、/MarkInfo /Marked true、XMP 封包中的 pdfuaid:part、文件标题以及语言。这些是格式标记,而且是必要的。但它们无法告诉你,位于第四页的实际图形是否带有屏幕阅读器可以朗读出来的描述。该答案存在于标签树 (tag tree) 中,而要获得该答案,你必须走访这棵树
PDFium 组件 (PDFium Component) 是一个适用于 Delphi 和 C++Builder 的原生 VCL PDF 函数库,其 ValidatePdfUa 会执行上述两项扫描。字节等级的扫描处理格式标记。在此之上,还有一个结构树 (structure-tree) 扫描,它会加载即时的标记树 (tagged tree),走访每个元素,并检查一小组具备高信赖度的内容规则;在这些规则中,缺失属性意味著真正的无障碍缺陷,而不仅仅是风格偏好。本文将探讨这第二项扫描:它检查什么、为何其规则逻辑是一个底层没有 DLL 的纯函数 (pure function),以及它刻意在哪里停下脚步
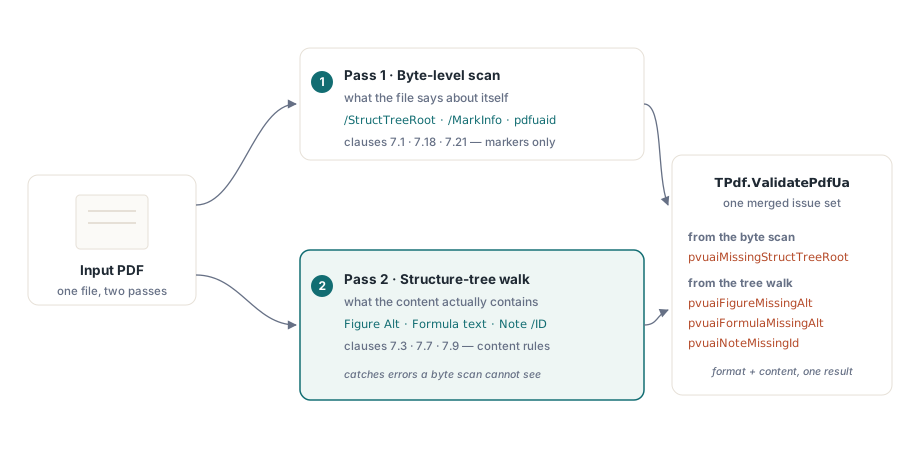
为什么字节扫描看不到遗失的 Alt
ISO 14289-1 (PDF/UA-1) 是一层附加在 ISO 32000 之上的需求。这些需求中有部分是结构性的,而且在原始文件中可见:目录必须宣告一个结构树、查看器偏好设置必须设置 DisplayDocTitle,字体必须内嵌。一个会剥离流主体 (stream bodies) 并将名称标记 (name tokens) 与分隔符号边界匹配的标记扫描器,可以验证所有这些项目,而 PDFium 的 ValidatePdfUaCompliance 正是针对 7.1、7.18 和 7.21 等条款执行这项工作
但是,“每个图形 (Figure) 都有替代文字”并不是文件语法的属性。它是逻辑结构 (logical structure) 的属性——将内容映射到意义的标记元素树。一个图形的 Alt 项目可以位在结构元素字典中、透过 /ActualText 跨度 (span) 提供,或来自于一个扮演特定角色的自订类型 (role-mapped custom type)。你无法透过在字节流中 grep 搜寻 /Alt 来可靠地找到它,因为该字符串会出现在不相关的上下文中,可能在对象流中被压缩,且完全无法告诉你它属于哪个结构元素。回答这个问题最诚实的方法,是逐个元素地询问文件本身的结构树,这也是 veraPDF 和 PAC 进行评估的层面。这就是 PDFium 的 Tier-1 检查所围绕的界线:字节扫描用于格式,树状走访用于内容
读取即时标签树 (live tag tree)
原始素材是 TPdf.GetStructureElements (也作为 StructureElements 属性呈现),它会返回一个 TPdfStructureElements — 这是 TPdfStructureElement 记录 (records) 按照文件顺序排列的平面数组 (flat array)。每笔记录都是一个结构元素透过 PDFium 的存取函数所投射出的结果,其中包含无障碍规则实际需要的字段:
type
  TPdfStructureElement = record
    Level: Integer;            // 标签树中的深度
    ParentIndex: Integer;      // 父元素的索引,或 -1
    TypeName: WString;         // standard /S name: Figure, Formula, Note...
    Title: WString;            // /T
    AlternateText: WString;    // /Alt   (FPDF_StructElement_GetAltText)
    ActualText: WString;       // /ActualText
    Expansion: WString;        // /E
    ID: WString;               // /ID    (FPDF_StructElement_GetID)
    Language: WString;         // /Lang
    MarkedContentIDs: TPdfIntegerArray;
    // ... 子项管理字段
  end;
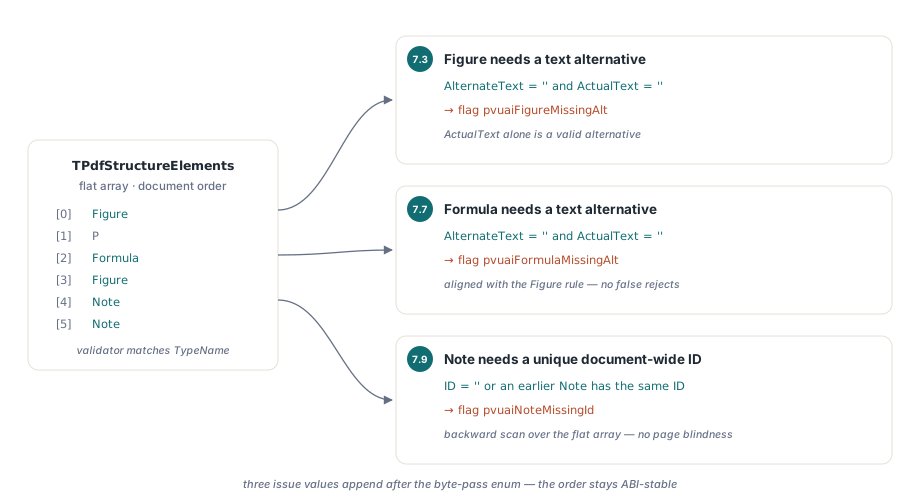
TypeName 字段是验证器运作的枢纽。它来自 FPDF_StructElement_GetType,该函数在 PDFium 解析角色映射 (role map) 后,返回元素的标准结构类型 (它的 /S 名称)。AlternateText 来自 FPDF_StructElement_GetAltText,ActualText 来自 FPDF_StructElement_GetActualText,而 ID 来自 FPDF_StructElement_GetID。由于该数组是扁平 (flat) 且有顺序的,验证器可以一次性地推论整份文件,而无须使用递回 (recursing) ——这对于那唯一一个全域性而非针对个别元素的规则来说非常重要
检查器是一个纯函数 (pure function),而且这是刻意设计的
规则逻辑并不存在于与 DLL 沟通的方法内部。它是一个独立的、公开的纯函数:
function ValidatePdfUaStructureElements(
  const Elements: TPdfStructureElements): TPdfUaValidationIssues;
它接收一个扁平的元素数组并返回一个问题集合 (issue set)。它不呼叫任何 PDFium 函数,不打开任何文件,也不会触碰全域状态 (global state)。这种分离是刻意为之的,且带来了双重好处。首先,可测试性 (testability):你可以在单元测试中构建一个合成的 TPdfStructureElements 数组——一个没有 Alt 的图形、一个唯一可存取文字位于 ActualText 中的公式、两个共用同一个 ID 的注释——并对结果集进行断言 (assert),完全不需要 pdfium.dll 存在。规则逻辑是离线验证的;而 DLL 的遍历 (traversal) 则由即时文件冒烟测试 (live-document smoke test) 分开验证,该测试在缺少函数库时会跳过
其次,职责的清晰度 (clarity of responsibility)。TPdf.ValidatePdfUa 负责处理繁杂的部分——加载每一页,提取其元素,将它们累积起来——然后将干净的数组交给纯检查器。“取得数据”(DLL、副作用、生命周期) 和“评判规则”(纯粹、确定性) 永远不会纠缠在一起。当规则需要改变时,你只需修改一个没有包含任何 I/O 的函数
这三条规则实际上检查了什么
结构树扫描会提出三个问题值,并将其附加在 TPdfUaValidationIssues 的末尾,以确保现有呼叫端 (callers) 的列举 (enum) 维持 ABI 稳定性:pvuaiFigureMissingAlt、pvuaiFormulaMissingAlt 和 pvuaiNoteMissingId。程序码主体够小,足以完全理解:
for I := 0 to High(Elements) do
begin
  T := string(Elements[I].TypeName);
  if T = 'Figure' then
  begin
    // §7.3——Figure 需要替代表示:
    // Alt 条目或 ActualText。仅在两者都为空时标记
    if (Elements[I].AlternateText = '') and (Elements[I].ActualText = '') then
      Include(Result, pvuaiFigureMissingAlt);
  end
  else if T = 'Formula' then
  begin
    // §7.7——规则与 Figure 相同:Alt 或 ActualText
    if (Elements[I].AlternateText = '') and (Elements[I].ActualText = '') then
      Include(Result, pvuaiFormulaMissingAlt);
  end
  else if T = 'Note' then
  begin
    // §7.9——每个 Note 必须有唯一 ID
    NoteId := string(Elements[I].ID);
    if NoteId = '' then
      Include(Result, pvuaiNoteMissingId)
    else
      for J := 0 to I - 1 do
        if (string(Elements[J].TypeName) = 'Note') and
           (string(Elements[J].ID) = NoteId) then
        begin
          Include(Result, pvuaiNoteMissingId);
          Break;
        end;
  end;
end;
条款 7.3 管图形:Figure 元素必须提供文字替代。最直觉的实现只看 Alt 条目,这会让检查比参考验证器还要严格。PDF/UA 同样接受可访问文本经由 ActualText 提供的图形——替换文本是一种有效的替代表示——所以规则只在 Alt 和 ActualText 两者都为空时才标记 Figure。条款 7.7 管公式,Formula 分支用的是完全相同的 Alt-or-ActualText 测试,因为仅靠 ActualText 携带可访问文本的 Formula 同样合规,只查 Alt 的检查会误拒它
条款 7.9 本质上有所不同。一个 Note 必须拥有一个 /ID,且该 ID 在整份文件中必须是独一无二的。遗失 ID 是单一元素的失败。而重复的 ID 则是两个元素之间的关系,这就是扁平数组如此重要的原因:对于每个 Note,检查器会向后扫描已经看过的元素,并标示出与任何带有相同 ID 之较早 Note 发生的冲突。这会产生明显的 O(n²) 成本 (相对于 Note 数量),但这对任何真实文件来说都无关紧要,且能保持函数为一个单一的、易读的循环,无需同步维护任何辅助索引 (auxiliary index)
跨页累积以确保唯一性是全域的 (global)
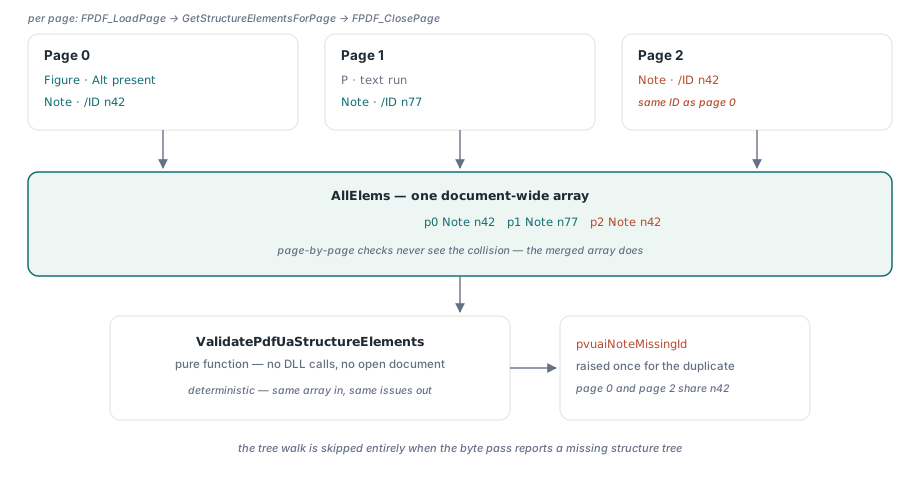
PDFium 是按页 (per page) 揭露结构元素,而不是按文件 (per document),所以在 ValidatePdfUa 中的编排工作必须在规则执行之前将它们收集起来。它使用 FPDF_LoadPage / GetStructureElementsForPage / FPDF_ClosePage 走访每一页 (独立于组件目前打开的任何页面),并将每一页的元素附加到同一个数组中。只有在那之后,它才会呼叫该纯检查器:
// 在 TPdf.ValidatePdfUa 内部,字节级遍历之后
if (FDocument <> nil) and
   (not (pvuaiMissingStructTreeRoot in Result.Issues)) then
begin
  AllElems := nil;
  PageTotal := FPDF_GetPageCount(FDocument);
  for I := 0 to PageTotal - 1 do
  begin
    Page := FPDF_LoadPage(FDocument, I);
    if Page = nil then Continue;
    try
      PageElems := GetStructureElementsForPage(Page);
    finally
      FPDF_ClosePage(Page);
    end;
    // 将 PageElems 追加到 AllElems ...
  end;
  Result.Issues := Result.Issues + ValidatePdfUaStructureElements(AllElems);
end;
这种累积正是 7.9 唯一性检查正确运作的基础。不同页面上的两个注释可以共用一个 ID;如果你逐页验证,永远都不会看到冲突,因为每一页的元素集合在内部看起来都是一致的。建立一个全文件范围的数组是让重复项目现形的唯一方法。最前方的防护机制也值得注意:只有在字节等级扫描没有回报 pvuaiMissingStructTreeRoot 时,树状走访才会执行。一个没有标记的文件没有树可以走访,且已经被标示为遗失结构根节点 (structure root),因此每页的加载工作会被完全跳过。深入扫描在无法从中受益的文件上不会耗费任何成本
在设计上趋于保守:宁可错失,绝不虚报警报 (miss quietly, never cry wolf)
此验证器最重要的一个特性在于它拒绝做什么。它只比对 /S 直接返回的标准 FPDF_StructElement_GetType 类型名称——Figure、Formula、Note。如果一份文件定义了自订类型并将其角色映射到 Figure,根据 PDFium 解析类型的方式,它会回报自己的名称。当这种情况发生时,检查器不会识别它并保持沉默。这是一个伪阴性 (false negative),而且这是预期的行为。设计准则为宁可少报,也绝不产生伪阳性 (false positive),因为一个在合规文件上频频发出假警报的预检工具,只会训练使用者去忽略它——而一个被忽略的验证器比没有更糟。装饰性图片存在于假影流 (artifact stream) 而非结构树中,因此它们一开始就绝不会作为图形出现;你不会收到关于正确标记为假影的背景线条“遗失 Alt”的抱怨
这也是为什么范围限制在三条规则的原因。标题层级的巢状结构 (条款 7.4)、表格表头范围 (7.5) 以及角色映射循环侦测 (7.1) 都是合理的 PDF/UA 需求,但要把它们检查好需要真正的图形和属性分析,而单纯的检查则会产生设计所禁止的伪阳性结果——PDF/UA 允许像 H1, H2, H3, H3 这样的标题模式,而一个简单的“必须严格递增”规则却会错误地拒绝它。那些检查就留给专门的合规工具吧。Tier-1 集合指的是缺失属性会带来明确错误的子集
界线,说清楚讲明白
在把它接进发布关卡之前,有两个限制值得知道。第一,检查器的优劣取决于 PDFium 能从结构元素里读到什么。有些参考验证器放行的文件,其替代文本经由 PDFium 访问器暴露不出来的机制提供,因此即使文件合规,FPDF_StructElement_GetAltText 也返回空。纯检查器随后会在不完整的数据上标记缺失 Alt——判定来自引擎暴露的内容,而非规则逻辑本身。放宽规则去吞掉这些情况,也会让它对本该抓到的真实失败视而不见,所以规则保持严格;这也是让完整验证器对被标记文件拥有最终决定权的又一个理由
第二,这是一个预检,而不是一个认证。Tier-1 捕捉了字节扫描在结构上无法捕捉的高信赖度内容错误,且没有错误警报——但是完整的 PDF/UA 合规性,包括标题语意 (heading semantics)、表格结构和阅读顺序的正确性,仍然属于完整验证器并最终交由人类审阅者来处理的工作。在你自己的管线中使用 ValidatePdfUa 来快速且低成本地使明显缺陷失败,然后让 veraPDF 或 PAC 来做最终决定。在构建Delphi 中的无障碍 PDF 阅读器时,相同的结构树遍历提供了基础支持,在该阅读器中,标签树驱动了阅读顺序和朗读文字,且这也与从 Delphi 审阅 PDF 注释的中继数据等级工作相辅相成
这里展示的结构树 API 和 ValidatePdfUa 验证器,包含在适用于 Delphi 和 C++Builder (VCL) 以及 Lazarus/FPC (LCL) 的 PDFium Component 之中。产品页面连结了完整的 API 参考数据,包含完整的 TPdfStructureElement 记录配置以及这些检查背后的问题列举