一份双栏会议论文按垂直位置排序,回来的第一行像 Abstract We measure the 2 Related work Earlier studies:左栏的开头几个词和右栏的开头几个词粘在一起,因为两者坐在同一条基线上。解析器没有出错。一份 PDF 页面为它的文本提供两种都说得通的顺序——内容流绘制它的顺序,以及每个字形在页面上的位置——而对很多版式来说这两个顺序并不一致。一个返回定位区块而不是单个字符串的提取器,让你看清拿到的是哪种顺序,并在它对眼前这页是错的顺序时切换
GetStructuredText 返回什么
PDFium Component 的 TPdf.GetStructuredText 为当前页返回一个 TPdfStructuredTextPage:区块数组,每个区块是行数组,每行是带样式 span 的数组。每一层都携带自己的 Text 和以 PDF 磅为单位的页面空间 Bounds 矩形,于是标题、单行或加粗短语都能直接定位在页面上,无须二次查找。页面记录还带 Width、Height、CharacterCount 和两个质量计数器,后文细说
拍平的 Page.Text 从区块构建,而不是从原始字符流。区块内的行用单个 CRLF 连接,区块之间隔一个空行,也就是说把 Page.Text 按纯文本打印出来,就能看到提取器把区块边界画在了哪里。当一页读起来很怪时,这是最快的排查手段
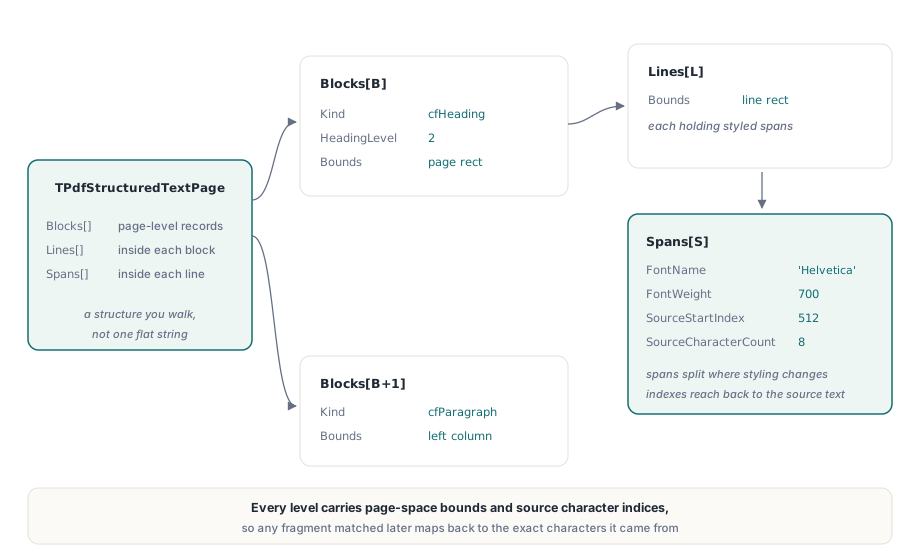
这一切由一个小小的选项记录驱动。TPdfStructuredTextOptions.Default 把 ReadingOrder 设为 roPhysicalLayout,打开 IncludeFontInfo 和 IncludeSemantics,并把 MaxCharacters 设为 1,000,000。阅读顺序字段是给输出形状带来最大变化的那一个
两种阅读顺序如何构建行与区块
roContentOrder 保留生成器的绘制序列,roPhysicalLayout 从字形位置重建顺序,差别首先体现在行怎么形成。内容顺序里,字符按页面绘制的次序取用。显式换行处、或下一个字符在垂直方向不再与当前行重叠时,开新行。一行只有在与前一个区块水平重叠至少窄边宽度的五分之一、且垂直间距不超过约 2.25 个行高时,才并入前一个区块;否则开新块。区块保持绘制顺序
物理布局把绘制序列扔掉。每个有已知盒子的字符按盒子的垂直中心排序,页面顶部优先,再按左边缘。垂直范围重叠足够的字符共占一行,这个测试只看高度,水平距离不参与。然后每行按同一套重叠加间距规则,加入页面上任何位置最适合它的既有区块,完成的区块按顶边排序,半磅以内由左边缘破平局
开篇的例子正来自第二条规则。当论文的两栏共享基线网格,左栏第一行与右栏第一行垂直重叠,物理布局就把它们放进同一行。栏间距处的空隙比四分之一字号宽,所以提取器插入一个空格继续。正文的每一行都如此,合并后的行彼此水平重叠,整个双栏正文变成一个横跨栏间隙直读的宽区块
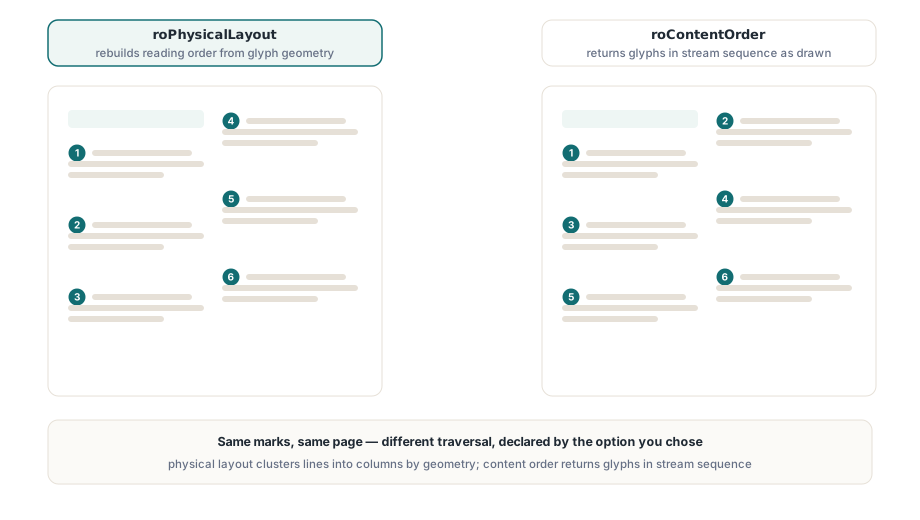
只要生成器先写第一栏再写第二栏——文字处理软件和排版系统通常如此——内容顺序就能把那页处理得很好。左栏的行堆成区块,右栏第一行与它们没有水平重叠、开出新块,区块按作者写作的顺序出来。物理布局则在另一类页面上找到自己的位置:发票、对账单、表单和幻灯片,标签和值坐在同一条基线上,从左到右读一行正是你想要的。绘制序列毫无意义时——比如逐字体绘制的文本,或由许多小覆盖层拼装的页面——也该用它
对混合的文档集,按文档类型分流。来自已知创作工具的文章、报告和手册走 roContentOrder;表单和交易类文档保持 roPhysicalLayout 默认值。下面的例程按内容顺序打印一页的区块,文件带标签时会标出标题
uses
  SysUtils, PDFium;

procedure DumpBlocks(Pdf: TPdf; PageNumber: Integer);
var
  Options: TPdfStructuredTextOptions;
  Page: TPdfStructuredTextPage;
  B, L: Integer;
begin
  Pdf.PageNumber := PageNumber;                 // 从 1 起数
  Options := TPdfStructuredTextOptions.Default;
  Options.ReadingOrder := roContentOrder;      // 先栏后栏的生成器

  Page := Pdf.GetStructuredText(Options);
  if Page.Source = rosStructure then
    Writeln('block kinds come from the structure tree')
  else
    Writeln('block kinds are inferred from layout');

  for B := 0 to High(Page.Blocks) do
  begin
    if Page.Blocks[B].Kind = cfHeading then
      Writeln(Format('[%d] H%d  %s',
        [B, Page.Blocks[B].HeadingLevel, Page.Blocks[B].Text]))
    else
    begin
      Writeln(Format('[%d] x=%.0f..%.0f, %d line(s)',
        [B, Page.Blocks[B].Bounds.Left, Page.Blocks[B].Bounds.Right,
         Length(Page.Blocks[B].Lines)]));
      for L := 0 to High(Page.Blocks[B].Lines) do
        Writeln('      ', Page.Blocks[B].Lines[L].Text);
    end;
  end;
end;
怎么检测一行横跨了栏间隙?
合并的行会通过 span 暴露自己。除下文覆盖的样式变化之外,只要下一个字符在页面原始字符序列里不是前一个的直接后继,GetStructuredText 就开一个新 span。在同一栏内,相邻的词在源序列里通常也相邻。在合并行的栏间隙处,源索引跳过几百个字符,两个 span 之间的水平间隙远比任何词间空格宽
两个信号合在一起构成可靠的测试,而且可以在决定这页是否需要内容顺序之前,先对默认输出跑一遍。GetStructuredText 读取的字符数据快照按页缓存,默认八页,所以带着不同的 ReadingOrder 第二次请求同一页时,重组的是内存里已有的数据,不再重新提取
// LineCrossesGutter 是你自己加的辅助函数:它标记这样一行——两个相邻 span
// 在页面上相距很远、
// 且在源字符序列里不相邻
function LineCrossesGutter(const Line: TPdfStructuredTextLine;
  MinGap: Double): Boolean;
var
  S: Integer;
  Prev, Cur: TPdfStructuredTextSpan;
begin
  Result := False;
  for S := 1 to High(Line.Spans) do
  begin
    Prev := Line.Spans[S - 1];
    Cur := Line.Spans[S];
    if (Prev.SourceStartIndex < 0) or (Cur.SourceStartIndex < 0) then
      Continue;                                 // 替代文本区块
    if (Cur.Bounds.Left - Prev.Bounds.Right > MinGap) and
       (Cur.SourceStartIndex <>
        Prev.SourceStartIndex + Prev.SourceCharacterCount) then
      Exit(True);
  end;
end;

function ExtractWithFallback(Pdf: TPdf): TPdfStructuredTextPage;
var
  Options: TPdfStructuredTextOptions;
  B, L, Lines, Crossing: Integer;
begin
  Options := TPdfStructuredTextOptions.Default;   // roPhysicalLayout
  Result := Pdf.GetStructuredText(Options);

  Lines := 0;
  Crossing := 0;
  for B := 0 to High(Result.Blocks) do
    for L := 0 to High(Result.Blocks[B].Lines) do
    begin
      Inc(Lines);
      if LineCrossesGutter(Result.Blocks[B].Lines[L], 18) then
        Inc(Crossing);
    end;

  // 四分之一的行跨过间隙,看着像分栏,不像表单行
  if (Lines > 0) and (Crossing * 4 >= Lines) then
  begin
    Options.ReadingOrder := roContentOrder;
    Result := Pdf.GetStructuredText(Options);
  end;
end;
18 磅是四分之一英寸,稳稳宽于正文的词间空格,又窄于大多数栏间隙。四分之一阈值让一张只有几行标签加金额的发票留在物理布局,而真正的双栏正文——几乎每行都跨——切换过去。如果生成器按行横跨两栏地写页面,源索引保持连续,测试永不触发,哪种顺序都不会替你分开两栏;那种页面需要 readable-content API 的分栏模式,见阅读带跨栏标题的双栏文本
IncludeSemantics 改变什么、不碰什么?
IncludeSemantics 给区块贴标签,不重排。选项打开时,GetStructuredText 读取页面的可读内容,把重叠面积最大的片段的种类给每个区块。可用的种类有 cfParagraph、带 HeadingLevel 的 cfHeading、cfListItem、cfTableCell、cfCaption、cfFigure、cfLink、用于其他任何标签的 cfOther,以及什么都没匹配上时的 cfPlain。每个区块还会拿到一个 Language 和一个把它系到结构树某个元素的 StructElementIndex
Source 字段说明标签从哪来:页面有 ISO 32000-1 §14.7 意义上可用的结构树时是 rosStructure,种类是推断出来的时是 rosHeuristic。Page.Source 对整页给出同样的答案。以 rosStructure 报告的标题是标题,因为作者打了标签;以 rosHeuristic 报告的是有依据的猜测,给标题加权的索引管道应当区别对待。两种情况下,区块顺序仍然来自 ReadingOrder。语义这道工序使用 readable-content 默认值,所以经 ReadableContentOptions 应用的分栏设置到不了 GetStructuredText
图有一条例外规则。在带标签的页面上,未匹配到任何文本块的 Figure 元素或替代文本会作为一个独立区块追加,以替代描述为文本。这种区块只有一行一个 span,SourceStartIndex 为 -1,因为页面上没有任何字形产出它。把 span 映射回字符的代码必须跳过该值,这正是上面的栏间隙测试要检查它的原因。结构树检查本身见PDF/UA 结构树校验
span、边界框与回到字符的路
每个 TPdfStructuredTextSpan 携带文本、边界框、FontName、FontSize、FontWeight 和 Angle,外加 SourceStartIndex 和 SourceCharacterCount。IncludeFontInfo 打开时,四个样式值任何一个变化处 span 就结束,于是中间带三个加粗词的句子会来成三个 span,强调可以从 FontWeight 重建,而不是靠字体名猜。IncludeFontInfo 关闭时,样式字段留空,span 只在源序列被打断处断开
角度在有印章的页面上很重要。斜着的 DRAFT 水印与正文共享同一坐标空间,物理布局里它的字母可能垂直穿过正文行、落在上面。拼接索引用文本之前,先按非零 Angle 丢弃 span 很省事
两个源字段把一次搜索命中变成可以画出来的东西。它们索引页面的字符序列,所以区块里找到的短语直接换算成高亮用的字符盒,做法见基于字符盒的可视文本行选择。目标若是页面的重排或 HTML 形态,同样的区块喂给重排模型及其 HTML 导出
一个字符预算和两个质量计数器
MaxCharacters 在页面字符数超限时整页拒收。GetStructuredText 在分配任何工作数组之前检查计数,超大页面抛出消息为 Structured text character budget exceeded 的 EPdfError,从不返回半页。值必须为正。方法读取的每页字符快照有自己的默认上限——1,000,000 字符和 100,000 个文本对象——超限报 Text snapshot budget exceeded,所以把 MaxCharacters 设到一百万以上也放不进更大的页面
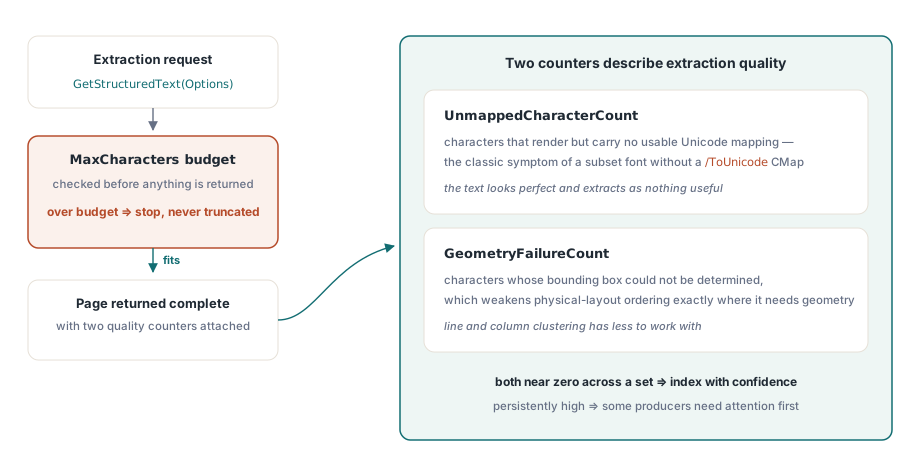
UnmappedCharacterCount 统计 PDFium 完全产不出 Unicode 值的字符。这些字符在每个 Text 字段里以 U+FFFD 出现。常见原因是带自定义编码、又没有 /ToUnicode CMap 的子集字体——ISO 32000-1 §9.10.2 描述的情形,文本渲染正常、却无法可靠提取。计数器只量缺失的映射:一个 /ToUnicode 条目指错码点的字形算已映射,所以一页看起来像模像样的乱码仍可能报零
GeometryFailureCount 统计没有可用盒子的字符,换行除外。内容顺序里这种字符跟着邻居走。物理布局里它们没有可排序的位置,被放在所有已定位字符之后,最终挂在页面最后一行上。几何计数非零、最后一行又有奇怪碎片的页面,展示的正是这个
// LogRejected 和 LogQuality 是你自己的日志例程
function ExtractForIndex(Pdf: TPdf; PageNumber: Integer;
  out Page: TPdfStructuredTextPage): Boolean;
var
  Options: TPdfStructuredTextOptions;
begin
  Result := False;
  Pdf.PageNumber := PageNumber;
  Options := TPdfStructuredTextOptions.Default;
  Options.MaxCharacters := 200000;              // 这条管线的入口上限
  try
    Page := Pdf.GetStructuredText(Options);
  except
    on E: EPdfError do
    begin
      LogRejected(PageNumber, E.Message);       // 字符或快照预算
      Exit;
    end;
  end;

  if Page.UnmappedCharacterCount * 20 > Page.CharacterCount then
    LogQuality(PageNumber, Format('%d of %d characters have no Unicode value',
      [Page.UnmappedCharacterCount, Page.CharacterCount]));
  if (Options.ReadingOrder = roPhysicalLayout) and
     (Page.GeometryFailureCount > 0) then
    LogQuality(PageNumber, Format('%d characters without a box; check the last line',
      [Page.GeometryFailureCount]));
  Result := True;
end;只要字符串就够的页面,从 PDF 文档提取文本覆盖更简单的调用,读写 BDC 与 MCID 标记内容则下到结构树下一层。结构化页面模型、readable-content 读取器和重排导出都随 PDFium Component 产品页所述的 Delphi 与 Lazarus 组件交付