从 3.117.0 起,PDFium Component 的表格提取会把细长的填充矩形当成一根表格线。启用 DetectFilledRulings(这是默认值)时,一个厚度不超过 MaxRulingThickness(3 点)、坐标轴对齐的填充盒,会沿它的长轴变成一根表格线;更大的填充盒贡献它的四条边;而在拼装网格之前,每一条表格线坐标都会在 RulingSnapTolerance(4 点)内被吸附。于是从 Word、Google Docs 和浏览器导出的表格,能以完整网格的身份抵达线框检测器,而不是作为碎片掉进空白对齐检测
早先那篇表格检测与提取说,线框检测用的是绘制出来的线条,每一段描边路径都会被变换到页面坐标。这句话是对的,但不完整。在一组 13 份真实样本文档上清点路径对象后发现,其中 9 份根本不包含任何描边路径,可它们的每一页都带着几百个 0.5 到 1 点厚的填充矩形。只看描边的检测器什么也看不见,每一页都掉到空白对齐检测,输出是一堆散落的小碎片而不是表格。3.116.4 加入的 compact-columns 预设只在碎片层面缓解了这个问题;根因是检测器读错了绘制算子
为什么 Word 导出的表格没有描边线条?
文字处理器不把边框当成一条线,而是当成一个有宽度的盒子,并用填充把它画出来。ISO 32000-1 §8.5.2.1 把 re 算子定义为追加一个矩形子路径,§8.5.3 则把绘制算子分开:S 按当前线宽描边路径,f 填充它的内部。0.5 点的单元格边框出来就是 x y w 0.5 re f,描边那一整套机制——线宽、连接和虚线样式——根本不会跑。单元格底纹是同一种构造,只是盒子更大。用 m、l 和 S 画出来的描边网格才是原检测器期待的东西,也几乎是办公软件导出时从不产生的东西:
% 来自文字处理器导出的一个单元格边框:0.5 点高的填充盒
72 700 468 0.5 re f
% 单元格底纹:与单元格同样大小的填充盒
72 676 117 24 re f
% 原检测器当初为之编写的那条描边网格线
72 700 m 540 700 l S
对一个只通过 FPDFPath_GetDrawMode 问「描边标志有没有置位」的检测器来说,这两种填充盒都是隐形的。单元格里的文字于是落到空白对齐检测手里,而那里被 6 点栏间距分开的列,低于默认的 MinColumnGap 12 点,回来的就只有恰好对齐得足以通过 MinRows 的那部分行。这就是碎片的由来,而再怎么调参数也变不出作者画的那个网格
PDFium Component 怎么把填充盒变成表格线?
TableCollectObjectRulings 逐个路径对象、逐个子路径地检查。绘制模式取自 FPDFPath_GetDrawMode;当 DetectFilledRulings 打开且填充模式不是 none 时,这条路径就算作被填充。每个点都会经过对象矩阵变换后被收集,每个子路径最多收集 MaxSubpathPoints(8)个,任何曲线段都会把该子路径标记为曲线。子路径闭合或者新的 MoveTo 开始时,FlushSubpath 判断它原本是什么:曲线子路径被丢弃;任何闭合多边形,只要它的点不能全部落在至少一个轴上、距包围盒边缘 PointTolerance(0.05 点)以内的位置,也一并丢弃。三角形、尖角或者圆角标签永远不会变成表格线,这正是把装饰性图形挡在网格之外的原因
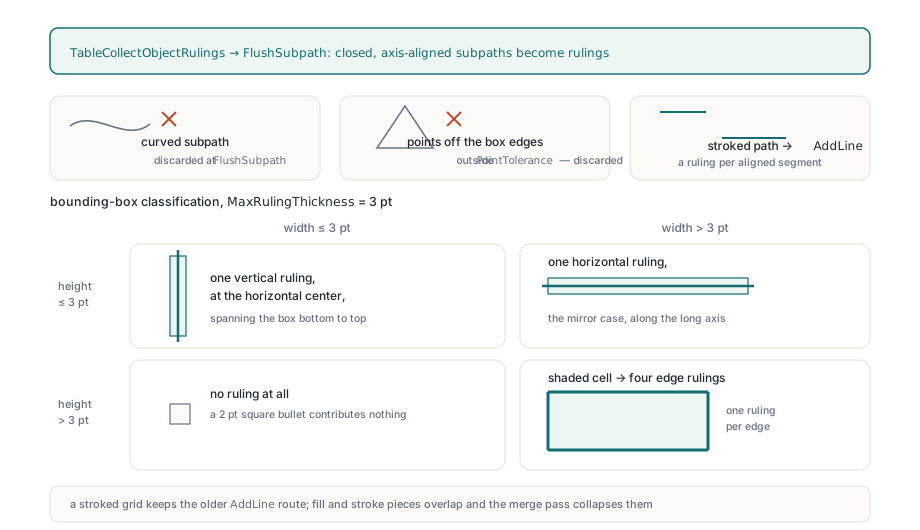
活下来的是一个坐标轴对齐的矩形,由它的包围盒来分类。宽度不超过 MaxRulingThickness 而高度超过它,就在水平中心产生一根纵向表格线,从盒底贯穿到盒顶;镜像的情形产生一根横向表格线。两个维度都超过阈值意味着这是一个带底纹的单元格,该盒贡献四根表格线,每边一根。两个维度都不超过阈值则什么都不贡献,所以一个 2 点的方形项目符号不会被误当成线。描边路径走 AddLine 那条老路,每个坐标轴对齐的线段一根表格线,所以用 S 画的网格处理方式与从前完全一样;而既填色又描边的路径会产生重叠片段,由合并那一趟把它们收拢:
uses
  PDFium;

var
  Pdf: TPdf;
  Options: TPdfTableExtractionOptions;
  Tables: TPdfTables;
  Mode: string;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'itinerary-from-word.pdf';
    Pdf.LoadDocument;
    Pdf.PageNumber := 1;                     // 从 1 开始

    Options := TPdfTableExtractionOptions.Default;
    // 这些是 3.117.0 的默认值,此处为清晰起见写出
    Options.DetectFilledRulings := True;     // 细长的填充盒变成表格线
    Options.MaxRulingThickness := 3.0;       // 点;更厚的盒算作底纹
    Options.RulingSnapTolerance := 4.0;      // 点;0 表示关闭吸附
    Options.IncludeFormXObjects := True;

    Tables := Pdf.ExtractTables(Options);
    for I := 0 to High(Tables) do
    begin
      if Tables[I].DetectionMode = ptdmRuled then
        Mode := 'ruled'
      else
        Mode := 'whitespace';
      Writeln(Format('%dx%d %s, confidence %.2f',
        [Tables[I].RowCount, Tables[I].ColumnCount, Mode,
         Tables[I].Confidence]));
    end;
  finally
    Pdf.Free;
  end;
end;
RulingSnapTolerance 对带底纹的表格做了什么?
RulingSnapTolerance 才是让一张纯靠底纹搭出来的表格连成一个网格的东西。有些导出根本不画边框:每个单元格都是一个自己颜色的填充盒,相邻盒子之间隔着 1 到 3 点的白色栏间距。每个盒子产生四根边缘线,但一个单元格的右边缘和下一个的左边缘相距 2 点,而连通性测试用的是 RulingTolerance,默认 1 点。不吸附的话,每个单元格各自形成由四根表格线组成的连通分量,没有一个分量够到 MinRows,这一页什么都报不出来。TableSnapRulings 会收集所有参与其中的 X 坐标(每根纵向表格线的位置,加上每根横向表格线的起点与终点)和所有 Y 坐标,各自排序,然后按「相邻值之差不超过容差就串起来」的方式聚类,把每个簇换成它的均值,再把每一个位置、起点和终点移到最近的簇中心。栏间距两侧变成同一条线,连通性就成立了
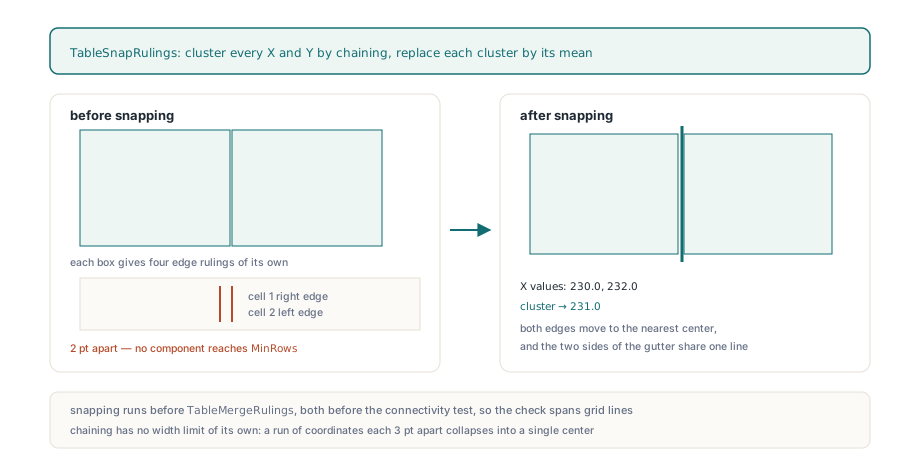
吸附在 TableMergeRulings 之前运行,后者会对表格线排序、并把在 RulingTolerance 内相接或重叠的共线片段接起来;这两趟都在 TableDetectRuled 看到数据之前跑完,所以两两连通性检查的开销与网格线条数成正比,而不是与每个单元格碎片数成正比。在描边网格上这两趟是无害的,因为本来就相同的坐标会吸附到它们自己身上。唯一要放在心上的是:链式聚类本身没有宽度限制,一串彼此相距 3 点的坐标会塌成一个中心。在 4 点的默认值下,这只影响比一个字符还窄的列;但如果某份文档确实有必须保持分开的 3 点栏间距,就把容差调低,或者设成 0 关掉吸附:
// 单独隔离线框策略,比较每种设置在同一个页面上看到什么
function CountRuledTables(Pdf: TPdf; FilledRulings: Boolean;
  SnapTolerance: Double): Integer;
var
  Options: TPdfTableExtractionOptions;
begin
  Options := TPdfTableExtractionOptions.Default;
  Options.DetectWhitespaceTables := False;
  Options.DetectFilledRulings := FilledRulings;
  Options.RulingSnapTolerance := SnapTolerance;
  Result := Length(Pdf.ExtractTables(Options));
end;

// 一份 Word 导出通常依次报出 0、N 和小于 N:
// 只看描边什么都看不见,吸附把带底纹的单元格连起来,
// 而关掉吸附会让每个带底纹的单元格自成一岛
Writeln(CountRuledTables(Pdf, False, 4.0));
Writeln(CountRuledTables(Pdf, True, 4.0));
Writeln(CountRuledTables(Pdf, True, 0.0));
form XObject 里的表格线
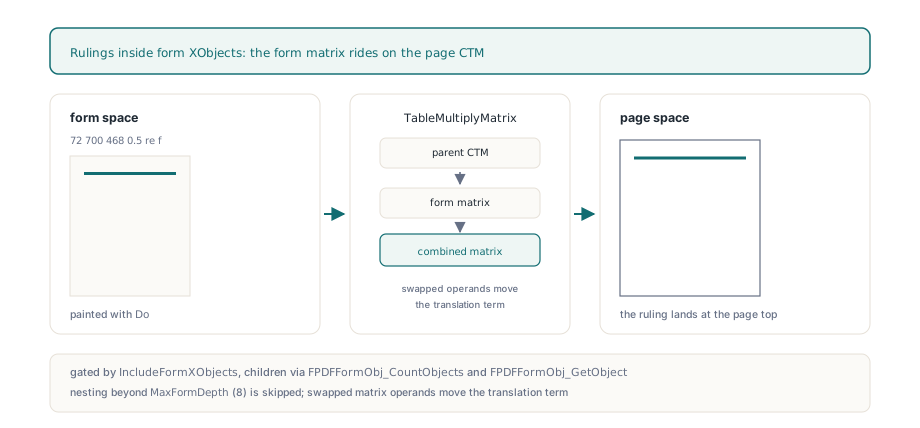
排版工具经常把一张表格甚至整个页面主体包进 form XObject,然后用 Do 把它画出来。ISO 32000-1 §8.10.1 规定,绘制 form 时它的矩阵会与当前变换矩阵相乘,所以 form 里的一个矩形住在 form 空间,要经过两次或更多变换才落到页面上。TableCollectObjectRulings 在 IncludeFormXObjects 打开时会递归进 form 对象:读取对象矩阵,通过 TableMultiplyMatrix 与父矩阵合并——它的参数顺序意味着「先经第一个矩阵映射,再经第二个」——再用 FPDFFormObj_CountObjects 和 FPDFFormObj_GetObject 枚举子对象,把合并后的矩阵一路传下去。嵌套深度超过 MaxFormDepth(8)的会被静默跳过,这是针对病态文件的防护,而不是任何真实导出会逼近的极限。乘法顺序之所以重要,原因和矩阵前置与后置那篇讨论的一样:交换操作数会移动平移项,本该落在页面顶部的一根表格线,就落到了原点
表格线预算为什么翻了四倍?
默认的 MaxRulingSegments 在 3.117.0 里从 4096 涨到 16384,因为逐单元格的边框数量远多于描边网格线。一张描边的 30 行 6 列表格是 38 条线段。同一张表格以填充盒导出,每个单元格最多四条边框,合并前就是 720 个片段,而带底纹的表格还要翻倍。一页上放两张这样的表格就会把旧预算耗光。预算在 TableAppendRuling 里通过 Check 强制执行,它抛出 EPdfError,消息是 "Table ruling-segment budget exceeded";这里没有降级结果,没有部分网格,空白那一趟也不会运行。如果你要为不可信输入设一个更紧的预算,就捕获这个异常再决定,别把一个空结果读成「没有表格」:
Options := TPdfTableExtractionOptions.Default;
Options.MaxRulingSegments := 2048;        // 针对不可信输入刻意收紧
try
  Tables := Pdf.ExtractTables(Options);
except
  on E: EPdfError do
  begin
    Log(E.Message);                       // 'Table ruling-segment budget exceeded'
    Options.MaxRulingSegments := 16384;   // 3.117.0 的默认值
    Tables := Pdf.ExtractTables(Options);
  end;
end;
实测结果与这套办法的边界
在同一批 13 份样本文档上,提取结果从 43 张表格——其中 9 张线框、34 条空白碎片或误报——变成了 41 张线框表格、零空白误报。这份清理有一部分要归功于 3.117.0 里两项配套改动:被线框网格认领过的词,在空白对齐检测运行之前就被移除,所以同一张表格不会被报两次;空白检测的列边界现在必须是贯穿它所分隔的每一行、完全没有文字的走廊——正是这一点让两端对齐的段落不再被评成 5x4 的表格。而把表格本身从碎片那一栏搬到线框那一栏的,是填充矩形这条读取路径
边界值得直说。没有文本层的页面依然只会给出网格骨架,每个单元格都是空的,因为线来自几何、文字来自文本页;扫描页需要先做 OCR。带曲线、圆角或非矩形轮廓的填充图形会被整个丢掉,所以边框画成圆角矩形轮廓的表格还是得像以前那样靠空白对齐检测。既没有边框也没有底纹的表格不受这一整套影响,仍归表格提取那篇描述的空白策略管;当连它也不够用时,结构化文本与阅读顺序里的词框和文本块就是写领域专用读取器的原料。随组件一起交付的 TableExtractionLab 演示在其选项面板里暴露了 DetectFilledRulings,这是看某份导出在开启与关闭它时分别长什么样的最快方式;完整 API 在 PDFium Component for Delphi 页面上有描述