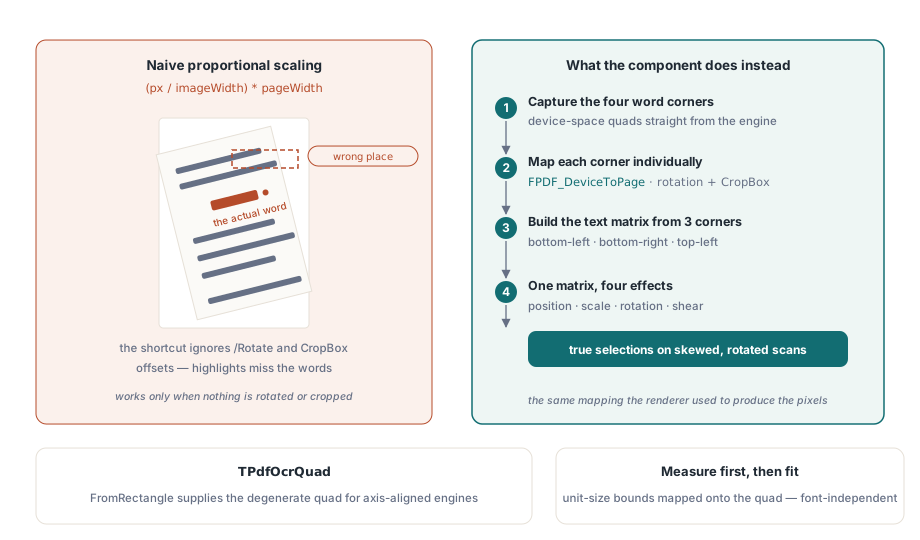
在一份扫描版 PDF 里搜发票号,命中是找到了,高亮却落在印刷数字左边半英寸、下方半英寸的地方。半英寸是 36 磅,而出问题的页面 CropBox 是 [36 36 576 756]。当初做文本层的人把像素位置换算成页面位置的方式,是拿位图宽度做除数、再乘以页面宽度,这等于假设可见区域从原点开始。在带 /Rotate 90 的页面上,同一套公式错得更离谱:位图的 x 轴已经沿着页面的 y 轴走了,单词整个落到页面的错误区域
隐形文本层到底是什么
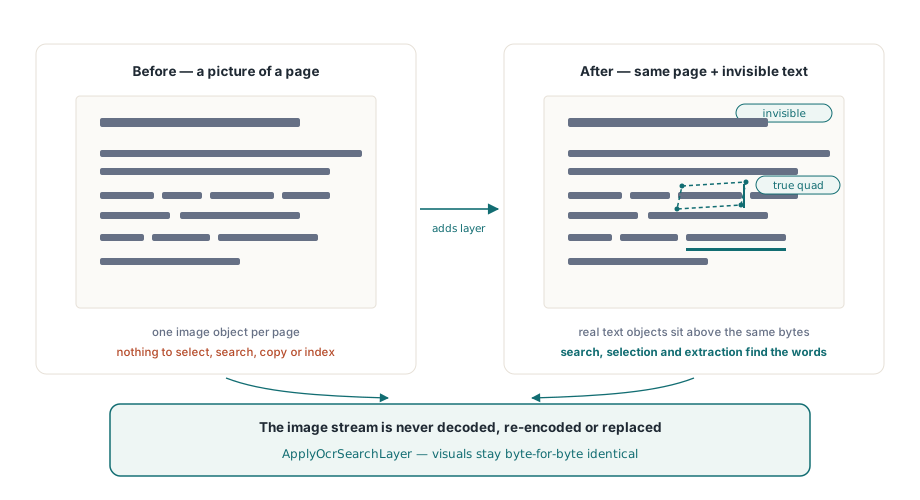
扫描页面就是内容流画出来的一整张大图,没有任何东西可以选中、搜索、复制或索引。可搜索文本层在这张图像之上叠加普通文本对象,并把它们的文本渲染模式设为 3——ISO 32000-1 §9.3.6(表 106)定义为既不填充也不描边:字形为选中、搜索和提取而存在,查看器不为它们绘制任何东西。做得好,读者看到的是原始扫描件,Ctrl+F 找到的单词就落在印刷位置上
在 PDFium Component 里,整个活儿就是一次调用:TPdf.ApplyOcrSearchLayer。它渲染每一个选定的页面,把像素交给 OCR 提供方,按置信度过滤识别出的单词,再把幸存者以隐形文本对象的形式写回。页面图像原样不动:扫描件不被解码、重新编码或替换,JBIG2 或 CCITT G4 图像保住了它带来的原始压缩字节。该方法在 Small Business 和 Enterprise 版中提供,所以工程需要在搜索路径上放 Lib\SmallBusiness,并在 uses 子句中引用 FPdfSmallBusiness;缺了这个单元,调用会抛出 EPdfSmallBusinessRequired
实现 IPdfOcrProvider
识别本身藏在一个接口后面。IPdfOcrProvider.RecognizePage 接收一个 TPdfOcrImage(页码、宽、高、行距、DPI、像素格式,以及一个装着自顶向下 BGRA 行的 TBytes 缓冲),外加一个取消令牌,返回一个 TPdfOcrWord 记录数组:Unicode 文本、0 到 1 之间的置信度,以及图像像素坐标系里的四角四边形。该版本自带一个现成的提供方,即 FPdfOcrTesseract 里的 CreatePdfTesseractOcrProvider,它绑定到你自备的 Tesseract 库和 traineddata 目录。任何其他引擎——云 API 也好,商业 SDK 也好——都通过像下面这样的类接入:
uses
  System.SysUtils, PDFium, FPdfAsync, FPdfSmallBusiness;

type
  TMyOcrProvider = class(TInterfacedObject, IPdfOcrProvider)
  public
    function RecognizePage(const Image: TPdfOcrImage;
      const CancellationToken: IPdfCancellationToken;
      out Words: TPdfOcrWords; out ErrorMessage: string): Boolean;
  end;

function TMyOcrProvider.RecognizePage(const Image: TPdfOcrImage;
  const CancellationToken: IPdfCancellationToken;
  out Words: TPdfOcrWords; out ErrorMessage: string): Boolean;
var
  I, Count: Integer;
begin
  // 下面的 Engine* 例程代表你自己的 OCR 引擎绑定
  Count := EngineRecognize(Image.Pixels, Image.Width, Image.Height,
    Image.Stride, Image.Dpi);
  CancellationToken.ThrowIfCancelled;   // 取消就按取消上报

  SetLength(Words, Count);
  for I := 0 to Count - 1 do
  begin
    Words[I].Text := EngineWordText(I);
    // 很多引擎按 0..100 上报;文本层要 0..1
    Words[I].Confidence := EngineWordConfidence(I) / 100;
    Words[I].Quad := TPdfOcrQuad.FromRectangle(
      EngineLeft(I), EngineTop(I), EngineRight(I), EngineBottom(I));
  end;
  ErrorMessage := '';
  Result := True;
end;
要是把 Tesseract 的 87.5 原样传过去,所有单词都会被拒。至少 Tesseract 是按百分比上报单词置信度的,自带的适配器在返回前会先除下来;自定义提供方也必须照做,因为 ApplyOcrSearchLayer 把大于 1 的置信度当作无效输入。知道往哪儿看之后,症状一目了然:Report.RejectedWordCount 等于 Report.DetectedWordCount,保存出来的文件里一个字都没有
令牌调用还有另一层意义。如果提供方察觉取消后只是简单返回 False,该页面会带着你设置的那条消息被记成 popsFailed。改为调用 ThrowIfCancelled,抛出的则是 EPdfOperationCancelled,文本层会捕获它并记成 popsCancelled,同时置位 Report.Cancelled 并停止循环。提供方内部令牌永远不会是 nil;调用方没传时,会给出一个永不取消的令牌
四边形,以及文本层拒收的单词
扫描件很少与页面横平竖直,稍微歪一点的纸上,一个单词占据的就是平行四边形。TPdfOcrQuad 为这种情形携带 TopLeft、TopRight、BottomRight 和 BottomLeft 四个点,FromRectangle 则为只报框的引擎构造轴对齐版本。一个单词在下列情况会被跳过并计入 RejectedWordCount:文本为空或超过 MaxWordCharacters;置信度为 NaN、低于 MinConfidence 或高于 1;任一角点落在位图之外;或者映射后四边形塌缩成窄于 0.01 磅的一条细缝
为什么按比例缩放会让 OCR 单词错位
只有当页面没有 /Rotate 项且 CropBox 从 (0, 0) 开始时,按比例缩放才是对的。大量扫描件至少违反其中一条:横向的纸常常存成带 /Rotate 的纵向页,而有人在编辑器里裁掉页边距时裁剪框就有了偏移。开头那个例子还只是轻微失败;一旦带上旋转,误差就不再是偏移,而是轴被调换了
ApplyOcrSearchLayer 把四个角点逐一送进 FPDF_DeviceToPage,用的正是产生提供方所见像素时的同一位图尺寸和旋转。旋转和裁剪框偏移因此由渲染器用过的同一套变换处理。角点进入时四舍五入到整像素,在默认 300 DPI 下这是 0.24 磅的量化步长,远低于选中高亮能分辨的程度
由映射后的点看,左下、右下和左上三个角点确定一个仿射矩阵。三个点足以表达位置、缩放、旋转和错切,所以第四个角点只做校验,绝不参与拟合。文本对象以字号 1 创建,实测它的真实边界,再由矩阵把测得的边界映射到目标四边形上。靠四边形高度去猜磅值会随每款字体的上伸下延而漂移;先测量,贴合效果就与 Options.FontName 指定的字体无关
即使什么都不画,字体对提取仍然有影响。TPdfOcrOptions.Default 把它设为 Arial。如果这个字体加载不了,文本层回退到标准 Helvetica——标准 14 字体之一,其内建编码只覆盖拉丁文。要输出西里尔文、希腊文或 CJK,就把 FontName 设成一款已安装且覆盖相应文字的字体
运行文本层并读取报告
只有当没有任何页面失败、也没有发生取消时,ApplyOcrSearchLayer 才返回 True。拿这个返回值来决定是否保存是错的。ContinueOnError 保持默认的 True 时,一个 300 页的任务只要有一页读不出来就返回 False,而其余 299 页都带上了正确的文本层,失败的那页也已被还原原状。保存与否应该看报告:
var
  Pdf: TPdf;
  Options: TPdfOcrOptions;
  Report: TPdfOcrReport;
  Cancel: IPdfCancellationTokenSource;
  I: Integer;
begin
  Cancel := TPdfCancellationTokenSource.New;  // 放在取消按钮够得着的地方
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'scanned-contract.pdf';
    Pdf.LoadDocument;

    Options := TPdfOcrOptions.Default;      // 300 DPI、MinConfidence 0.5、Arial
    Options.MinConfidence := 0.6;
    Options.MaxTotalPixels := Int64(4000) * 1000 * 1000;

    Pdf.ApplyOcrSearchLayer(TMyOcrProvider.Create, Options, Report,
      Cancel.Token);

    for I := 0 to High(Report.Pages) do
      if Report.Pages[I].Status = popsFailed then
        Writeln(Format('page %d failed: %s',
          [Report.Pages[I].PageNumber, Report.Pages[I].ErrorMessage]));
    Writeln(Format('%d inserted, %d rejected, %d skipped, %d failed',
      [Report.InsertedWordCount, Report.RejectedWordCount,
       Report.SkippedPageCount, Report.FailedPageCount]));

    if not Report.Cancelled and (Report.InsertedWordCount > 0) then
      Pdf.SaveAs('scanned-contract-searchable.pdf');
  finally
    Pdf.Free;
  end;
end;
取消后不保存是一种取舍,本文选择的就是这一边。被取消的任务留下一个前半可搜、后半空白的文件,PDF 里没有任何东西告诉下一个读者文本层到哪儿停了。以后整份文档重跑一遍,比解释一个半索引的档案便宜得多
SkipPagesWithText 默认为 True,检查页面是否已能提取出任何字符。这样原生数字页面不进 OCR,处理过的文件不会盖上第二层,对同一输出重复执行也成了空操作。反面是单个真实字符也算数:扫描件上若有一个以真实文本盖的 Bates 编号,就会被报成 popsSkippedExistingText,拿不到文本层。这类档案需要 SkipPagesWithText := False,并用 FirstPage 和 LastPage 仔细圈定页码范围,否则处理过的页面会叠上重复层,提取时每个单词返回两遍
像素预算、取消与逐页回滚
恶意文档或者单纯的大部头能撑爆的每一项数量,在 TPdfOcrOptions 里都有上限,像素检查在任何位图分配之前就执行。渲染尺寸是 Ceil(PageWidth * Dpi / 72) 乘 Ceil(PageHeight * Dpi / 72),数字可以提前算出来:
| 300 DPI 下的页面 | 位图 | 像素 |
|---|---|---|
| US Letter,612 × 792 pt | 2550 × 3300 | 8,415,000 |
| A4,595 × 842 pt | 2480 × 3509 | 8,702,320 |
| A3,842 × 1191 pt | 3509 × 4963 | 17,415,167 |
| A0,2384 × 3370 pt | 9934 × 14042 | 139,493,228 |
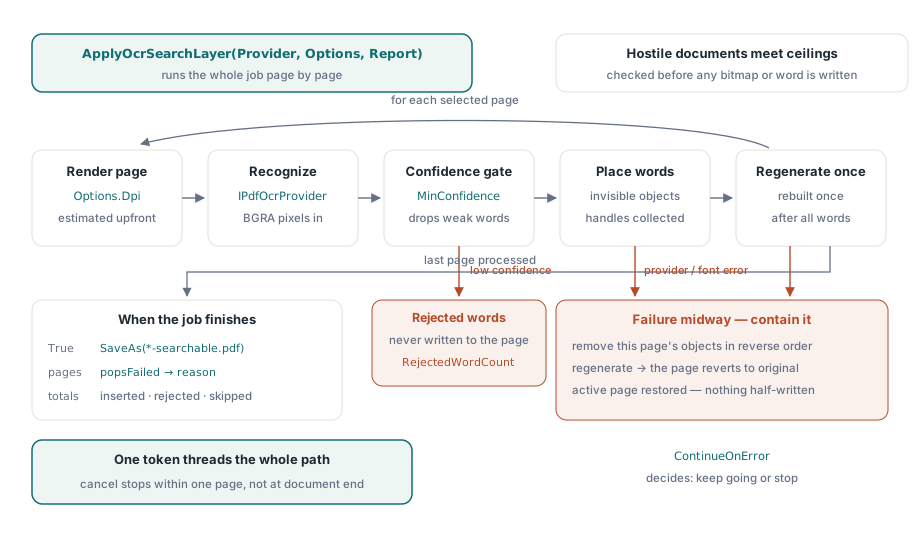
默认值是每页 1 亿像素、整个任务 10 亿像素。一张 300 DPI 的 A0 图纸光靠自己就超了 MaxPixelsPerPage。任务级预算比每页预算先用光:Letter 页每页 8,415,000 像素时,118 页能挤进 10 亿,第 119 页会失败并报出 MaxTotalPixels,之后的每一页也一样。长篇扫描档案要么像上面的例子那样调高 MaxTotalPixels,要么用 FirstPage 和 LastPage 把活儿拆成区间。被跳过的页面不渲染、不计数。自带的 Tesseract 适配器另有限制 TPdfTesseractOptions.MaxPixels,默认 16,777,216;300 DPI 的一张 A3 刚好超一点,所以 A3 批次要么调高适配器限制,要么调低 DPI
DPI 必须落在 36 到 1200 之间。从 300 翻倍到 600,位图变为四倍,每个像素 4 字节,一张 Letter 页的 BGRA 就从约 34 MB 涨到约 135 MB。对普通办公扫描件,300 DPI 在识别质量与内存之间是平衡点;600 值得用在袖珍印刷和脚注上,不值得用在整批档案上。单词数量由 MaxWordsPerPage 和 MaxTotalWords 封顶,提供方返回的单词超过页面配额时,失败的是那一页,而不是截断了事
取消令牌贯穿渐进式渲染、提供方调用和插入单词的循环。识别一份 400 页文件的第 212 页时取消,就会停在第 212 页——前提是提供方尊重递给它的令牌。Tesseract 适配器更进一步,向引擎注册了取消回调,并默认带 60,000 毫秒的每页超时
失败隔离按页进行。文本层记下它插入的每一个文本对象的句柄,在该页最后一个单词放好后调用一次 FPDFPage_GenerateContent。中间任何环节失败——字体拒收某个字符,或循环进行到一半来了取消——该页已插入的对象都会按相反顺序移除并重新生成页面内容,页面于是回到只剩原有内容的状态。随后循环按 ContinueOnError 决定继续还是停止,调用前活动的是哪一页,之后还是那一页
检查结果
两项检查覆盖大多数可能出错的地方。第一项是目测:用 TPdf.RenderPage 以相同尺寸渲染原文件的一页和处理后文件的同一页,然后比较位图。预期是逐像素相同,因为模式 3 什么都不画,图像流也没被碰过;任何像素差异都意味着改动页面的是文本层以外的东西。第二项检查单词存在且落在扫描图显示的位置上:
procedure CheckOcrPage(Pdf: TPdf; PageNo: Integer; const Probe: WString);
const
  TEXT_MODE_INVISIBLE = 3;   // FPDF_TEXTRENDERMODE_INVISIBLE
var
  TextObjects: TPdfIntegerArray;
  I, Invisible, Hit: Integer;
  Box: TPdfRectangle;
begin
  Pdf.PageNumber := PageNo;
  TextObjects := Pdf.GetObjectsByType(otText);
  Invisible := 0;
  for I := 0 to High(TextObjects) do
    if Pdf.GetTextRenderMode(TextObjects[I]) = TEXT_MODE_INVISIBLE then
      Inc(Invisible);
  Writeln(Format('page %d: %d invisible text objects', [PageNo, Invisible]));

  Hit := Pdf.FindFirst(Probe);
  if Hit >= 0 then
  begin
    Box := Pdf.CharacterRectangle[Hit];
    Writeln(Format('"%s" starts at x=%.1f, y=%.1f pt',
      [Probe, Box.Left, Box.Bottom]));
  end;
end;
挑一个肉眼能在扫描图上定位的探针单词——一个标题或一个合计数——把报告的坐标和它在渲染图像里的位置对一对。开头那个带 CropBox 的页面,x 值应从 36 或更大起步,绝不会接近零。提取一侧在从 PDF 文档提取文本里有更深入的讨论,为对齐叠加渲染页面见将 PDF 页面转换为 JPEG,贯穿全文的令牌模式见可取消的渐进式渲染
OCR 文本层与渲染、文本提取、页面编辑同在 Delphi、C++Builder 和 Lazarus 的同一个 TPdf 对象上。版本区别和完整 API 列表见 PDFium Component for Delphi 产品页