在一个保持标准 Macintosh 字形顺序的 TrueType 字体里,单词“Total”在 PDF 内容流里可以是 <0037005200570044004F> Tj。这五个双字节值是嵌入字体内部的字形编号,字符串里没有任何东西说明它们画出的是 T、o、t、a、l。把这些字节当 UTF-16 读,你得到的是 7RWDO,而页面在屏幕上显示的却是 Total——因为画字形只需要代码到字形的映射,把文本取回来却需要代码到 Unicode 的映射,而文件可能从来没带过后者
为什么提取出来的文本会变成乱码?
内容流记录的是字符码,而这些码的含义完全在字体里。Tj 和 TJ 运算符(ISO 32000-1 §9.4.3)携带的字节串要经过前面 Tf 选中的字体来解释:字节 0x41 在 WinAnsi 下是字母 A,在子集字体里可以是任意字形,在复合 CJK 字体里是双字节 CID 的一半。ISO 32000-1 §9.10 把文本提取当成正是这样一个解码问题——从字体字典提供的一切出发把每个码映射回 Unicode——并且明说:合规文件并不被要求提供足以完成这件事的信息
“从这份 PDF 复制粘贴出来全是乱码”的报告,背后都是这一条款。嵌入没有 /ToUnicode 表的子集字体的生产方,写出的是一个渲染完全正确、完全合法的文件。字形都在那里,缺的是反向映射,而提取器只能从间接证据重建它:字体声明的编码、字形名、Adobe 公布的字符集、嵌入字体程序内部的 cmap 表。一个 API 会尝试其中几样、全失败时交给你什么,正是提取库在实践中拉开差距的地方
用 ExtractLoadedPageText 拿阅读顺序文本
HotPDF Delphi Component 通过 function ExtractLoadedPageText(PageIndex: Integer; out AText: UnicodeString): boolean 返回已加载页面的阅读顺序文本。页面索引从零开始,结果类型是原生的 Delphi UnicodeString,页面没有可读内容流时函数返回 False 而不是抛异常。它对你加载的任何 PDF 都管用:客户邮件发来的发票、扫描公司交付的报告、已经没人说得出名字的软件产出的合同
var
  Pdf: THotPDF;
  PageCount, I: Integer;
  PageText, AllText: UnicodeString;
begin
  Pdf := THotPDF.Create(nil);
  try
    PageCount := Pdf.LoadFromFile('invoice.pdf');  // 返回页数
    AllText := '';
    for I := 0 to PageCount - 1 do
      if Pdf.ExtractLoadedPageText(I, PageText) then
        AllText := AllText + PageText + #13#10;
  finally
    Pdf.Free;
  end;
end;要整个文档一个字符串,ExtractLoadedPagesText(PageRange, PageSeparator) 接受从 1 开始的范围如 '1,3-5,7-'(空字符串意味着所有页面),并在页面之间放上 PageSeparator——默认是换页符 #12。大文档更适合走 ExtractLoadedPagesTextToStream,它把 UTF-8 逐页写进 TStream,返回处理了多少页
文本持有的就是页面显示的东西。盒子中心落在可见区域(media box 之内的 crop box)之外的字形被排除,裁切过页面上的印刷标记因此不会漏进你的索引。页面绘制的 Form XObject 里的文本会包含进来,并裁剪到每个 form 的 /BBox。同一位置画两遍的字符——伪装粗体的老把戏——只读一次;文本提取中的假粗体与重复字形讲了这种情况怎么被识别
换行遵循一条简单的几何规则:字形原点沿书写方向越过超过半个文本高度时开新行——文本高取本字形与前一字形上升到下降高度中较大者,按页面单位。量字形盒子而不是 Tf 的字号操作数,正是关键所在:不少生产方经文本矩阵设定字号、给 Tf 传 1,建立在那个操作数上的阈值会在每个上标处断行,还会把旋转文本的每个字符各放一行。词间空格同理。当生产方不显示空格、而是用 TJ 调整量或 Td 移动文本位置来分隔单词时,一旦前一字形自身宽度之后的间隙超过字形高度的 0.15,就补一个空格——并且在两个中日韩字符之间永远不补。解码器解析不了的码变成空格,于是即便单个字形阵亡,词边界还在。水平文本按内容流顺序输出;竖排 CJK 被重新分组为从右到左、从上到下阅读的列。页面文本中的词间空格与换行讲了这些阈值
网格、分栏还是结构顺序
当位置本身承载含义(表格、表单、代码清单、任何你要按列 diff、grep 或解析的东西),ExtractLoadedPageTextLayout 是更好的调用。它把字形聚成基线,每条基线按 X 排序,在等宽字符网格上重现水平和垂直空白——网格尺寸由页面字形步进与字号的中位数决定。基线上的大空隙变成空格串,基线之间的大空隙变成空行
uses System.IOUtils;
...
var
  Grid: UnicodeString;
begin
  if Pdf.ExtractLoadedPageTextLayout(0, Grid) then
    TFile.WriteAllText('page1.txt', Grid, TEncoding.UTF8);
  // 列、缩进与表格对齐在字符网格上以
  // 空格和空行的形式保留
end;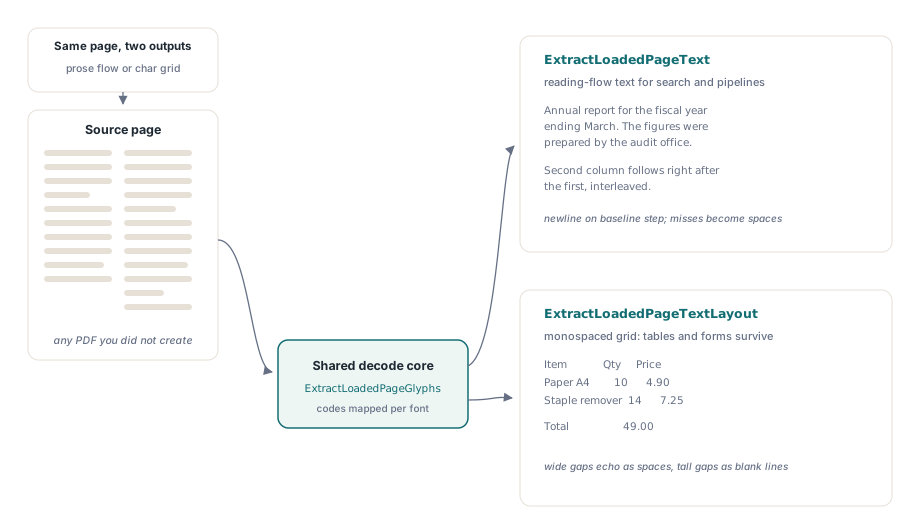
两个调用走同一套解码机制,选哪个都不损失保真度。网格不会做的是重排散文:一篇双栏文章会忠实输出成两栏并排——对 diff 是对的,对摘要器是错的。另外两个调用补这个缺口。ExtractLoadedPageTextColumns(PageIndex, AText, ColumnGapMultiplier) 在相邻字形的间隙超过中位步进的倍数(默认 3.0)处切开每一行,用制表符拼接各段。ExtractLoadedPageStructureText(PageIndex, AText, UntaggedGlyphCount) 遍历带标签 PDF(tagged PDF)的结构树(ISO 32000-1 §14.8.4),按创作顺序返回标记内容运行段;页面没有可用结构树时返回 False,UntaggedGlyphCount 告诉你有多少字形没能安置
给一个人或一个语言模型读的文本,先试结构顺序,再回退到 ExtractLoadedPageText。结构树是作者有意声明的那个顺序,相比之下每个几何方法都是猜测。列就是数据的场合,继续用网格。结构顺序文本提取里有标记内容如何与结构树匹配的细节
HotPDF 如何把字符码解码成 Unicode
HotPDF Delphi Component 按优先级排序的回退链解析每个字符码,答不上来的策略把码交给下一个。字体自己的 /ToUnicode CMap(ISO 32000-1 §9.10.3)排第一,因为它是生产方专为提取写下的唯一映射。之后是 /Encoding /Differences 数组给出的字形名,经 Adobe Glyph List 读取;然后是 /Encoding CMap 本身——以流嵌入或按名引用,名字为 Uni…-UTF16 形式时意味着码本身就是 UTF-16。复合字体继续走 Adobe 字符集(Adobe-GB1、Adobe-CNS1、Adobe-Japan1、Adobe-Korea1、Adobe-KR)从 CID 到 Unicode,再经 /CIDToGIDMap 进入嵌入字体程序的 cmap 表,从字形到 Unicode 反向读。简单字体回退到 WinAnsi、MacRoman、Standard 和 MacExpert 表,最后落到同一张嵌入 cmap。整条链走完仍解析不了的码归 0
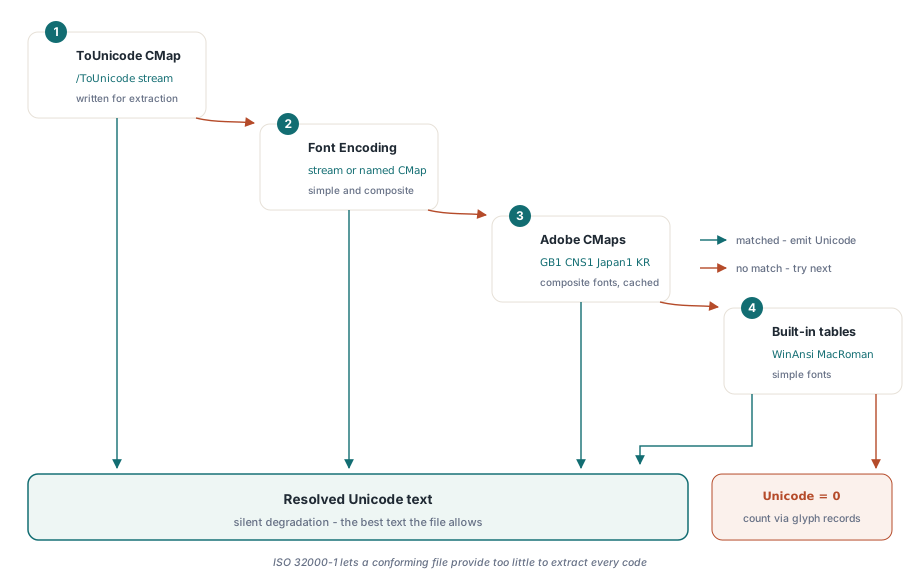
嵌入 cmap 这一步救回了许多不带 /ToUnicode 出货的子集字体:字体程序里通常还留着自己的 Unicode cmap,把它反过来读就能恢复大部分文本。不过它是重建。共用一个字形的两个 Unicode 字符都会变成 cmap 里列的那一个,所以恢复出的文本拿去做搜索和索引没问题,要当法律记录用之前请先核对
Adobe 字符集数据在磁盘上。HotPDF 在自己的 resources\CMap 文件夹里带着那些 CMap 和 cid2code.txt 文件,每个文件每个进程至多解析一次并缓存结果——光 Adobe-GB1 一张映射就是约 2 MB 的文本,你不会想每页解析一遍。预定义 CMap 也有内置表版本,所以用 UniGB-UTF16-H 这类命名 CMap 编码的字体没有那个文件夹也能解码;Identity-H CJK 字体的 CID 到 Unicode 表确实需要它。CMapResourcePath 属性指定容纳这些字符集子文件夹的目录;留空时,HotPDF 在可执行文件旁边及其上一两级找 resources\CMap
Pdf := THotPDF.Create(nil);
try
  // 装着 Adobe-GB1-6、Adobe-CNS1-7、Adobe-Japan1-7……的文件夹
  Pdf.CMapResourcePath := 'C:\MyService\resources\CMap';
  Pdf.LoadFromFile(FileName);
  ...
finally
  Pdf.Free;
end;
在服务、ISAPI 模块或插件 DLL 里请显式设置路径。那些宿主里 ParamStr(0) 指向的是宿主进程,很少是你部署到的文件夹;而文件夹缺失并不抛错——CJK 页面只是带着空隙回来,那些位置本该由字符集表填上。用 HotPDF 做复杂文种整形在写入时遇到的正是同一个“码与字形”的分裂
两个 CMap 语法陷阱
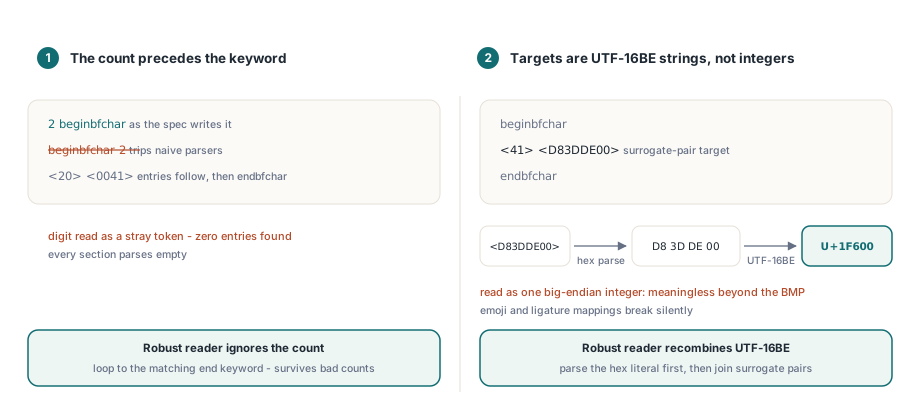
CMap 文件看起来好解析到不行,而两个细节绊倒大多数第一次尝试。记录数出现在节关键词之前:一节写作 2 beginbfchar,从来不是 beginbfchar 2。期待计数在关键词后面的解析器会把数字当游离标记吞掉,然后在每一节里找到零个条目。HotPDF 的读取器完全无视计数,循环到配对的 endbfchar 或 endbfrange 为止——这顺带也应付了现实世界里那些声明计数本来就是错的文件
第二个陷阱是 bfchar 和 bfrange 的目标是 UTF-16BE 字符串。目标 <D83DDE00> 指的是 U+1F600——一个必须重新拼合为单个码点的代理对;把这四个字节当大端整数读,基本多文种平面之外的每个字符(emoji 也在内)都会得到一个无意义的值。HotPDF 先把十六进制字面量解析成原始字节、再重组 UTF-16BE 码元,这也顺带处理了连字映射产生的多字符目标,比如一个 fi 字形映射到两个字母
用 ExtractLoadedPageGlyphs 数出未解析字形
ExtractLoadedPageGlyphs(PageIndex, AGlyphs) 把文本调用底下的字形记录暴露为 THPDFGlyphArray。每个 THPDFGlyphRecord 携带原始 Code、它的 CodeByteWidth(1、2 或 4,由 CMap 的 codespacerange 决定)、解析出的 Unicode 码点外加连字用的 UnicodeSequence、生效的 FontKey 和 FontSize、用户空间的 X/Y 原点、Advance、四角字形四边形,以及 GlyphEndX/GlyphEndY——字形自身宽度的终点,词间空格规则从这里量起。做定位高亮或你自己的排版算法,这些够用了
var
  Glyphs: THPDFGlyphArray;
  I, Unresolved: Integer;
begin
  if Pdf.ExtractLoadedPageGlyphs(0, Glyphs) then
  begin
    Unresolved := 0;
    for I := 0 to High(Glyphs) do
      if Glyphs[I].Unicode = 0 then
        Inc(Unresolved);
    if Unresolved > 0 then
      ShowMessageFmt('%d of %d glyphs have no Unicode mapping',
        [Unresolved, Length(Glyphs)]);
  end;
end;
数 Unicode = 0 的记录,是在把文本交给下游之前评判一份文档的诚实办法。这个计数会和文本调用看到的略有出入:本调用返回页面自己内容流里的每一个字形——包括裁剪框之外的、为假粗体重复绘制的——并且不深入 Form XObject。每条记录还存有 TokenIndex、ItemIndex 和 ByteOffset,把字符拴回它的源操作数;在既有 PDF 中搜索与替换正是建立在这三个字段上
有些文件无文本可给。扫描页就是一张大图,没有文本运算符,提取因此正确地返回空字符串——出路是 OCR,第一步是从已加载的 PDF 提取页面图像。加密文档用 LoadFromFile(FileName, Password) 打开后即可正常提取,因为流在解释器读到之前就已解密。字体流和内容流经与文档其余部分相同的滤镜链解码,一条解不开的 /ToUnicode 流会让该策略落空、轮到下一个,而页面其余部分照常提取。同一个对象读取器也支撑着编辑已加载文档的元数据,于是一次摄入既能读文本也能修元数据
阅读顺序、网格、分栏和结构顺序提取,外加字形级访问,都以纯 Object Pascal 形式随面向 Delphi 与 C++Builder 的 HotPDF Delphi Component 交付,没有外部 DLL,也不依赖操作系统文本服务——当奇怪的文件落进你的队列,你可以单步走进解码器,看每个码是哪个策略应答的