磁盘上有一份 PDF,客户从一摞发票扫描来的,你的活儿是把页面图像提取回位图去做 OCR。你加载文件、找到图像 XObject,然后撞上那个没人提醒过你的部分:这些流里的字节不是像素。它们是一段 JPEG 码流,或一块小波压缩的 JPEG 2000 数据,或一条 Group 4 传真行程,或一副藏在调色板后面、调色板又藏在 Flate 过滤器后面的索引光栅。图像对象知道自己的宽高,但实际样本被封在生成者选的那个过滤器里。要拿到可用的 TBitmap,就得拆掉那层过滤器,而 PDF 大约给了你八种封字节的方式
这正是 HotPDF——面向 Delphi 和 C++Builder 的原生 VCL PDF 组件——用 ExtractLoadedImage 补上的缺口。它枚举你加载的文档里的图像 XObject,报告每个是什么,并把能解码的解码回 24 位位图。有意思的不是那三个方法组成的 API 表面,而是为什么干脆必须存在一条独立的解码路径,以及它把哪些过滤器变回像素
为什么已加载的图片不是现成解码好的
HotPDF 的加载器围绕直通保真构建。调用 LoadFromFile 时,图像流按它们在源文件里的原样保留:原过滤器、原压缩字节、原字典。这是刻意的。加载文档通常是为了复制页面、合并文件、盖章、改权限再写回去,对这些操作来说,最便宜也最安全的做法就是一个字节都不碰图像流。加载时把每张图解码成光栅,会把内存和 CPU 烧在大多数调用者永远用不到的工作上;保存时重新编码,则会劣化那些本该原样复制的图像
结果是,已加载的对象图里没有像素。一个 /Filter 为 /DCTDecode 的图像 XObject 里装着 JPEG 字节;HotPDF 从没对它跑过 JPEG 解码器,因为复制加重写的路径里没有任何环节需要。所以当你真要像素时,提取 API 必须亲自解码,从零开始,针对那张图恰好用的过滤器来。这也是编码侧编解码器独立于加载器的同一个原因:在 Delphi 中给 PDF 添加 JPEG 2000 图像一文讲了 JPX 引擎如何接入创建侧,而提取 API 把同一个引擎接进了读取路径
三个方法组成的 API
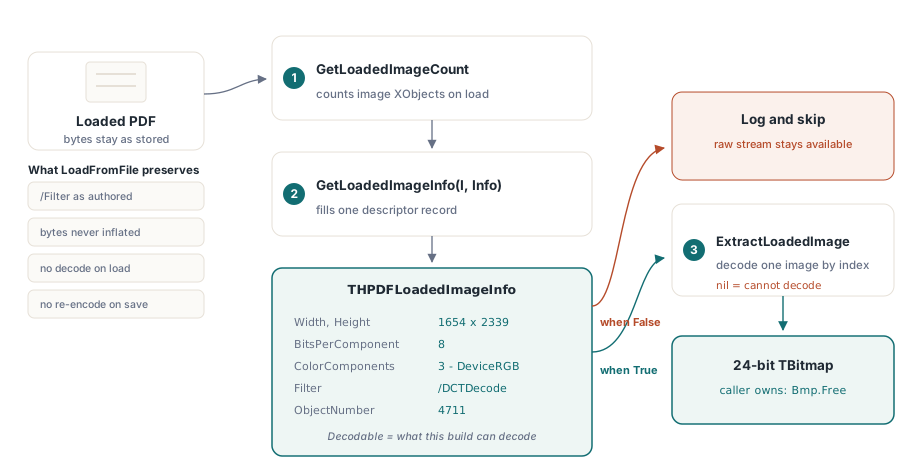
表面很小。GetLoadedImageCount 返回已加载文档包含多少个图像 XObject。GetLoadedImageInfo 按索引为其中一个填描述符记录。ExtractLoadedImage 返回解码后的位图,解不动时返回 nil。枚举按索引进行,对一次给定的加载是稳定的:内部遍历间接对象表,收集每个 /Subtype 解析为 /Image 的流,所以你传给 GetLoadedImageInfo 的索引和传给 ExtractLoadedImage 的索引是同一个
var
  Pdf: THotPDF;
  Info: THPDFLoadedImageInfo;
  Bmp: TBitmap;
  I, Count: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('scanned-invoices.pdf', '') <= 0 then
      Exit;
    Count := Pdf.GetLoadedImageCount;
    for I := 0 to Count - 1 do
    begin
      if not Pdf.GetLoadedImageInfo(I, Info) then
        Continue;
      if not Info.Decodable then
        Continue;                       // 过滤器或颜色空间不支持
      Bmp := Pdf.ExtractLoadedImage(I);
      if Bmp <> nil then
      try
        Bmp.SaveToFile(Format('img_%d.bmp', [I]));
      finally
        Bmp.Free;                       // 位图归调用方释放
      end;
    end;
  finally
    Pdf.Free;
  end;
end;
这里有两个契约细节要紧。第一,返回的 TBitmap 由你释放;文档不缓存也不持有它。第二,调用前检查 Decodable,调用后把结果和 nil 比一比。方法遇到不支持的过滤器不抛异常,它返回 nil,而批量循环里一个安静的 nil,恰恰是那种无声吞掉千页作业里一整页的东西
解码之前先读描述符
THPDFLoadedImageInfo 不承诺完整解码就能告诉你这张图是什么。它的字段直接来自图像字典:按样本计的 Width 和 Height、描述解码后解释方式的 BitsPerComponent、ColorComponents 和 ColorSpace(1 灰度、3 RGB、4 CMYK)、作为具名压缩的 Filter、模板掩码用的 IsImageMask、底层间接对象的 ObjectNumber,还有 Decodable
最后一个标志最诚实。只有当前构建真能把这个特定的过滤器加颜色空间组合变成位图时,Decodable 才是 True。它编码的是真实的支持矩阵,不是愿望:一张当前构建看不懂 Filter 的图像会报告 Decodable = False,你可以据此分支去记日志、跳过,或退回自己提取原始流。把它当前置条件,不是提示
// 在提交解码之前,先给每张图分流。
var
  Pdf: THotPDF;
  Info: THPDFLoadedImageInfo;
  I: Integer;
begin
  // ... Pdf loaded ...
  for I := 0 to Pdf.GetLoadedImageCount - 1 do
  begin
    if not Pdf.GetLoadedImageInfo(I, Info) then
      Continue;
    if Info.Decodable then
      // ExtractLoadedImage(I) 将返回一个 TBitmap
    else
      // 不支持的过滤器/颜色空间:记录对象并跳过
      Writeln(Format('Image %d obj %d: %dx%d %s/%s not decodable',
        [I, Info.ObjectNumber, Info.Width, Info.Height,
         String(Info.Filter), String(Info.ColorSpace)]));
  end;
end;一个会咬到手工构造描述符记录者的实现细节。THPDFLoadedImageInfo 持有两个 AnsiString 字段:Filter 和 ColorSpace。它们是带引用计数的管理类型,所以用 FillChar(Info, SizeOf(Info), 0) 清零记录的习惯反射在这里是错的:它改写字符串引用却不递减,要么泄露要么损坏。HotPDF 正因如此才逐字段初始化记录;你在自己的代码里抄这个模式时也照做
一个分发器,八条过滤器路径
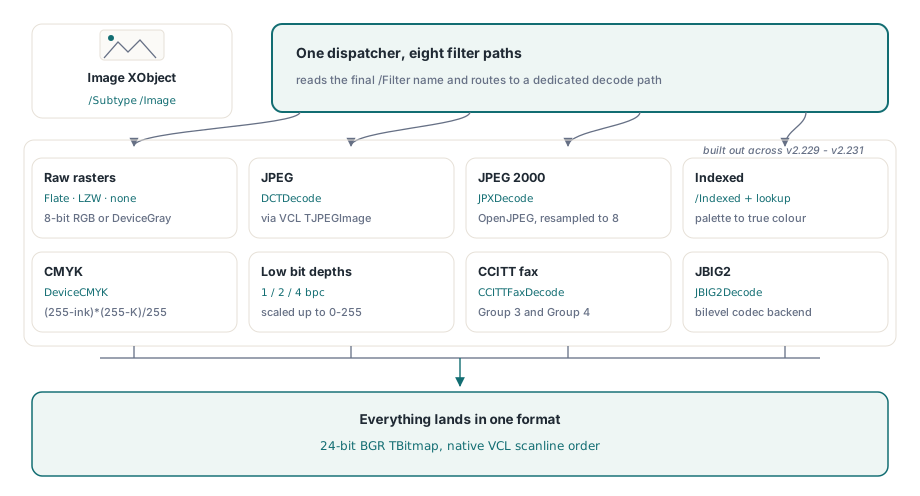
提取之所以需要一个分发器,根本原因是 PDF 没有“图像格式”这回事。它有过滤器,ISO 32000-1 §8.9.5 允许图像 XObject 在 /Filter 里点名其中任何一个,样本解释则另由 /ColorSpace、/BitsPerComponent 和可选的 /Decode 数组管着。ExtractLoadedImage 读过滤器名,按情形路由到专用解码器。支持的集合覆盖八条不同的路径
- 原始光栅(FlateDecode、LZWDecode 或无过滤器),8 位 DeviceRGB 或 DeviceGray。字节解压成打包光栅,唯一的变换是通道交换,下文会讲
- DCTDecode(JPEG)。码流交给 VCL 的
TJPEGImage,由它解析几何与颜色,结果指派进一张 24 位位图 - JPXDecode(JPEG 2000)。经 OpenJPEG 后端解码——与 JPEG 2000 一文讲的同一个引擎——超过 8 位深度的分量重采样降回 8 位
- Indexed 颜色。调色板从
[/Indexed base hival lookup]数组读出,每个样本经查找表展开成真彩 - DeviceCMYK。四通道样本按标准的白底油墨公式转成 RGB
- 低于 8 位的 DeviceGray 与 Indexed,每分量 1、2 或 4 位,逐样本解包并缩放进 0–255 范围
- CCITTFaxDecode,Group 3 与 Group 4 传真过滤器,由专用的 T.4/T.6 后端解码
- JBIG2Decode,高压缩比的双色层过滤器,经注册的 JBIG2 后端解码——原生 JBIG2 压缩一文从编码侧讲过它
所有路径落在同一个地方:一张 24 位 BGR 位图,因为那是 VCL TBitmap 原生存的格式,也是每个下游消费者期望的
会悄悄改像素的变换
这些路径里有两个涉及容易错得很微妙的变换,哪怕你永远不碰解码器也值得弄懂。第一个是颜色顺序交换。PDF 的 DeviceRGB 光栅按红-绿-蓝顺序存样本,顶行在前。VCL 的 24 位扫描行按蓝-绿-红存。所以解码一张普通 RGB 图不是一次 memcpy:进入扫描行的路上,每个像素的第一和第三个字节要互换。搞反了,红蓝互换位置,在灰度测试图上看不出问题,在彩色图上错得离谱。行顺序倒是直通的:PDF 自上而下的光栅与 VCL 的 ScanLine[0] 作为最上面的视觉行正好对齐,不需要垂直翻转
第二个是 CMYK。PDF DeviceCMYK 图像带四种油墨,转 RGB 是逐通道的计算,不是查表:每个输出通道是 (255 - ink) * (255 - K) / 255。这是设备近似,不是过 ICC 配置文件的色彩管理转换,所以结果拿去显示和重新光栅化足够正确,但要印准颜色就不是正路。工作流要保真,就把提取出的位图当预览,把原始 CMYK 流留给色彩管理管线
Indexed 路径还藏着一个自己的解析陷阱。/Indexed 颜色空间里的调色板可以存成字面字符串,也可以存成十六进制字符串,而 HotPDF 把十六进制字符串的值存成十六进制文本,不是解码后的字节。所以调色板是十六进制字符串时,查找表得先过一遍十六进制转字节的解码;字面字符串则已经是原始字节。漏掉这个分支,一张四色索引图出来就是乱码,因为每个调色板条目都在错误的字节边界上被读取
过滤器链:最后一个过滤器才是图像自己的
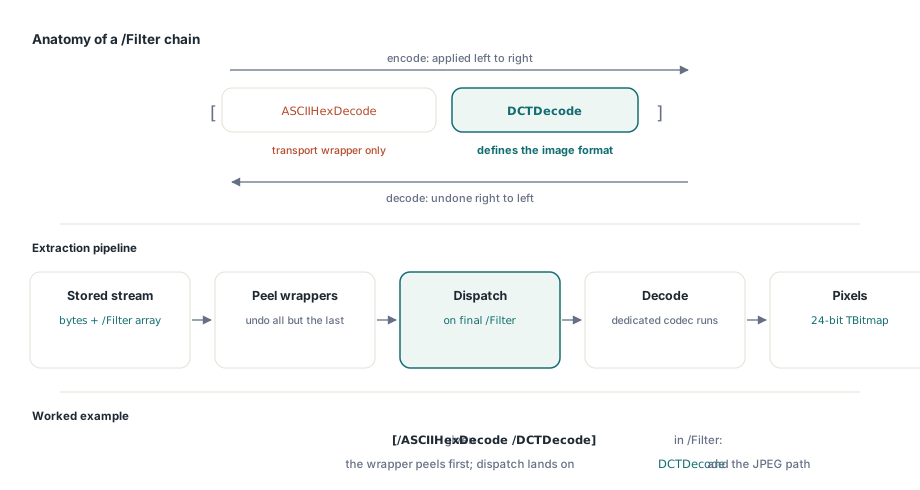
单个 /Filter 名是容易的情况。PDF 还允许过滤器链:流依序过了好几道,按顺序列在 /Filter 数组里,比如 [/ASCII85Decode /FlateDecode] 或 [/ASCIIHexDecode /DCTDecode](ISO 32000-1 §7.4)。语义精确:编码时过滤器从左到右施加,所以解码时你要从右到左拆掉它们,而数组里最后一个过滤器才是真正定义图像格式的那个。前面的过滤器只是包在它外面的传输编码
提取器用剥皮来处理。任何图像解码器运行之前,链上除最后一个之外的每个过滤器先被施加,产出最终过滤器期望的输入,然后才按最后一个过滤器分发。所以 [/ASCII85Decode /DCTDecode] 先给流解 ASCII85,再把结果路由去 JPEG 路径;包着原始光栅的 [/FlateDecode] 先解压,再走光栅路径。这正是八个解码器能保持简单的原因:它们都不必知道 ASCII85 或十六进制传输包装——解码器看到字节时,包装早没了。这也意味着末端过滤器不支持的链,仍然干净地败在分发那一步,而不是半途出错
拿回来的是什么,什么时候改用原始流
你拿到的是基础图像按它自己那个流解码的结果,不是叠了柔和掩码的合成结果。超过 8 位的 JPEG 2000 分量被重采样到 8 位,显示和 OCR 正合适;图像掩码——一种没有自己颜色的一比特模板——由 IsImageMask 标出,好让你把它当模板而不是照片。末端过滤器或颜色空间落在上面集合之外的图像返回 nil,这正是 Decodable 防护该出现在每个循环里的原因
要 alpha、要完整位深、要色彩管理输出时,原始流仍在已加载的对象图里,连着过滤器原封不动,你可以逐字节取出,交给你自己的专用编解码器。这是直通设计刻意保留的退路:原始字节从不被丢弃,最坏也就是你自己解码,而不是数据没了。不过对多数实际作业来说,这八个受支持的过滤器已经覆盖扫描仪、办公套件和报表引擎真正会产出的东西,一个带 Decodable 防护、跑在 GetLoadedImageCount 上的循环,几行代码就能把已加载的 PDF 变回一文件夹位图
已加载图像提取 API 与这里描述的整套解码过滤器,随面向 Delphi 和 C++Builder 的 HotPDF Delphi Component 提供