查看器的查找框在发票第 2 页高亮了 “Acme Corp”,可对解压后页面流按同样九个字符做字节搜索,结果是空的。光第一个词,流里装的就可能是 <0024004600500048> Tj:内嵌子集字体里的双字节字形代码,两个词之间的空隙由定位偏移而不是空格字符产生。替换这个名字意味着:把那些代码解码成 Unicode、在 Unicode 层匹配、回溯到产生命中的确切字节、再写出同一字体认得的新代码。而当子集里从来没有过新文本需要的字形时,就无代码可写
这背后的需求都是寻常的文档维护。公司更名了,三千份归档发票还带着旧名字。合同模板带着去年的截止日期发了出去。退役的零件号要在每份数据表里换成继任者。在文字处理器里,每件事三十秒搞定;在 PDF 里,每一件都会撞上页面实际的存储方式
PDF 页面存的不是文本,是什么
PDF 页面放的是定位好的字形,不是可编辑文本。在 ISO 32000-1 §9.4 之下,内容流驱动 Tj 和 TJ 这类文本显示操作符,在文本矩阵设定的位置绘制字符代码序列。那些代码是索引,指向当前字体声明的任何编码。回到可读字符的路可能经过 /ToUnicode CMap(§9.10.3)、带 /Differences 数组的 /Encoding,或 Type0 字体的 CID 映射链。没有段落对象,没有文本流,也没有任何东西要求生产者把一个可见词存成一个字符串:[(Ac) -12 (me)] TJ 是给词做字距调整的再普通不过的写法
替换在解码之上又加了一层要求。文本提取器拿到 Unicode 之后可以把字节位置扔掉;替换器不能——它必须知道每个字形由哪个字符串操作数的哪些字节产生,才能只重写那一段、其余一概不碰。这就是为什么对流字节直接跑 StringReplace 是错误的工具,哪怕文件碰巧用的是 WinAnsi 编码:它不知道哪个 ( 属于字符串,哪个 Tf 选出了赋予那些字节意义的字体
在解码后的字形序列上搜索
HotPDF Delphi Component 用 SearchLoadedPageText 和 SearchLoadedDocumentText 搜索已加载的文档:把查找词与每页解码后的 Unicode 字形序列匹配,从不匹配原始流字节。因此无论字体怎么编码,命中就是命中。解码时,每个字形都记录它来自哪个字符串操作数、哪个 TJ 数组项和哪个字节偏移——替换步骤日后靠的正是这些。同一个字形解释器驱动着在 Delphi 中从已加载 PDF 提取文本所覆盖的 API;搜索只是保留了提取阶段丢弃的源位置
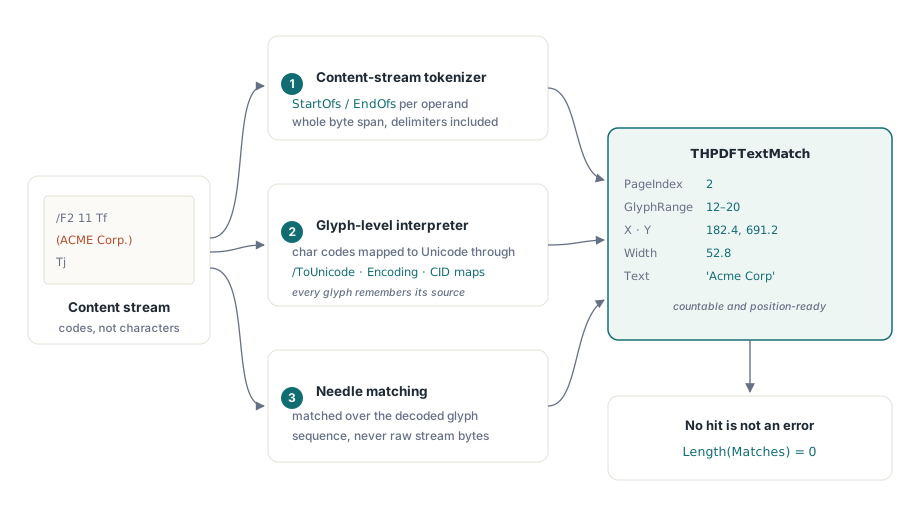
每个命中以 THPDFTextMatch 记录返回:PageIndex、GlyphStart 与 GlyphEnd 给出的含首含尾字形范围、用户空间原点 X 和 Y、命中的 Width、来源 TokenIndex 与 ItemIndex,以及匹配到的 Text。PageIndex 从 0 起算。查不到时返回空数组和 True,调用代码不必为“没找到”写特殊分支
var
  Pdf: THotPDF;
  Matches: THPDFTextMatchArray;
  I: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('invoices-2025.pdf') > 0 then
      if Pdf.SearchLoadedDocumentText('Acme Corp', False, Matches) then
        for I := 0 to High(Matches) do
          WriteLn(Format('page %d at (%.1f, %.1f), width %.1f: "%s"',
            [Matches[I].PageIndex + 1, Matches[I].X, Matches[I].Y,
             Matches[I].Width, Matches[I].Text]));
  finally
    Pdf.Free;
  end;
end;
那个循环能不能打印出东西,首先取决于空格。搜索文本由页面真正绘制的字形构成,一个字形一个字符;视觉上分开两个词的 TJ 偏移是数组里的一个数,不是字形。用偏移而不是空格字符设置词间隙的生产者,会在字形序列里产出 “AcmeCorp”,查找词 “Acme Corp” 就匹配不上。当一个可见短语死活匹配不上时,先搜它最长的单个词,看看返回结果的 Text
大小写是另一件要检查的事。CaseSensitive 设为 False 时,Delphi XE2 起的构建经 Unicode 简单小写映射比较字符——与区域设置无关,所以 É 匹配 é,希腊与西里尔大写也匹配各自的小写。更老的编译器构建只折叠 A–Z。该映射一字形对一字形,让查找词的每个位置恰好对齐一个字形;代价是 ß 不匹配 SS。整词 UI 流程用 SearchLoadedPageTextWholeWord 丢弃落在更长单词内部的命中,GetLoadedSearchHitRect 把一个匹配变成单个矩形供绘制高亮
搜索与替换都作用于页面自己的 /Contents 流。画在 Form XObject 里的文本——许多工具把盖章的页眉页脚放那里——住在页面用 Do 调用的单独流里,两种操作都够不到它
用 ReplaceLoadedDocumentText 重写匹配的字节
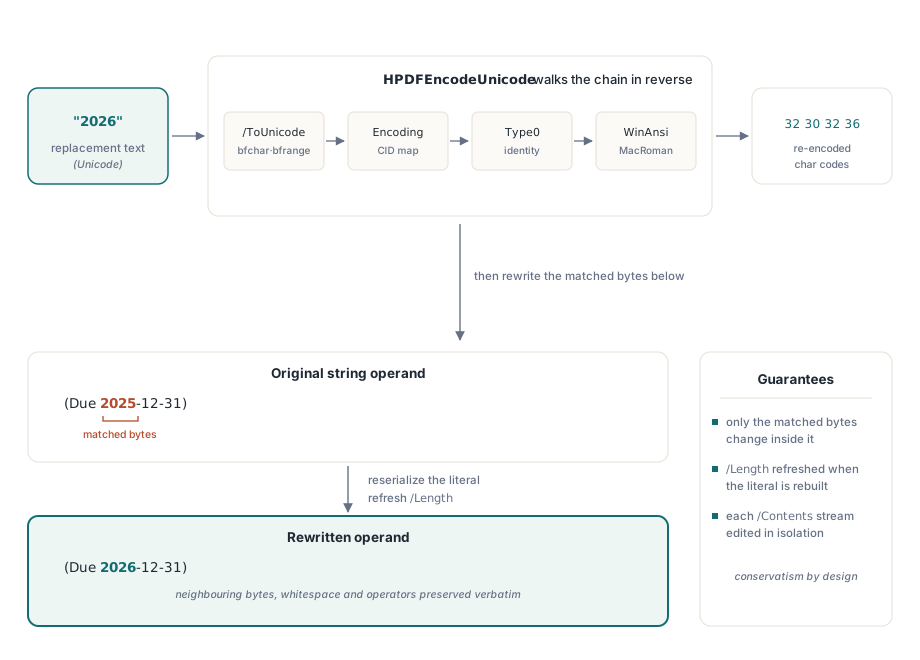
ReplaceLoadedPageText 和 ReplaceLoadedDocumentText 把字体解码倒着跑一遍,重写查找词的每次出现。每个替换字符沿解码器用的同一条链反向查找:/ToUnicode 的 bfchar 与 bfrange 条目、Type0 字体的 CID 映射、恒等映射,以及预定义的 WinAnsi 与 MacRoman 表。得到的字符代码以字面字符串写回;任何字节落在可打印 ASCII 之外时则写成十六进制字符串,遵循内容流解析器读取的同一套转义规则
只有匹配覆盖的字节会变。同一操作数里未被匹配的字节、token 之间的空白、注释和周围所有操作符都原样通过。在 abcabc 里替换 bca 得到 a + 替换文本 + bc。替换文本可以比查找词更短或更长;页面 /Contents 数组里的每条流独立处理,页面因此保持良构。当匹配跨过多个字符串操作数——比如 Hello 存成 [(He) -20 (llo)] TJ——替换文本写进匹配开始处的那个操作数,匹配的字节从其后的操作数中移除
var
  Pdf: THotPDF;
  Rewrites: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('contract-draft.pdf') > 0 then
    begin
      if Pdf.ReplaceLoadedDocumentText('2025-12-31', '2026-12-31',
        True, Rewrites) then
        WriteLn(Format('%d operand rewrites', [Rewrites]));
      Pdf.SaveLoadedDocument('contract-final.pdf');
    end;
  finally
    Pdf.Free;
  end;
end;
页面不会重新排版。PDF 没有重排,所以比原文更宽的替换只是多占水平空间,可能撞上画在它右边的东西;下一个字形的位置是生产者定死的,不会挪。日期、版本号、零件号和长度相近的拼写订正,正是这个方法为之内建的工作。改写一段话需要把下游所有东西重新排版,那种改动属于源文档
字体子集为什么装不下它从未有过的字符?
内嵌子集从未包含过的替换字符,没有可逆向得到的字符代码。生产者做字体子集化时,/ToUnicode CMap 和编码只覆盖原文档用过的字形,其余一切的字形轮廓根本不在文件里。如果文档从没用那个字体印过大写 E,就没有任何字节序列能选中一个。这个限制在文件里,不在做替换的工具里
ReplaceLoadedDocumentText 对无法编码的替换采取保守处理:只要有一个字符无法重新编码,整个出现位置就整体跳过。没有异常,没有替换了一半的字符串,原文保持可读。在上面日期的例子里,数字 6 必须在同一字体的某处存在,重写才能成功。假设那字体只印过 “2025” 和几个不含 6 的订单合计:日期就保持原样
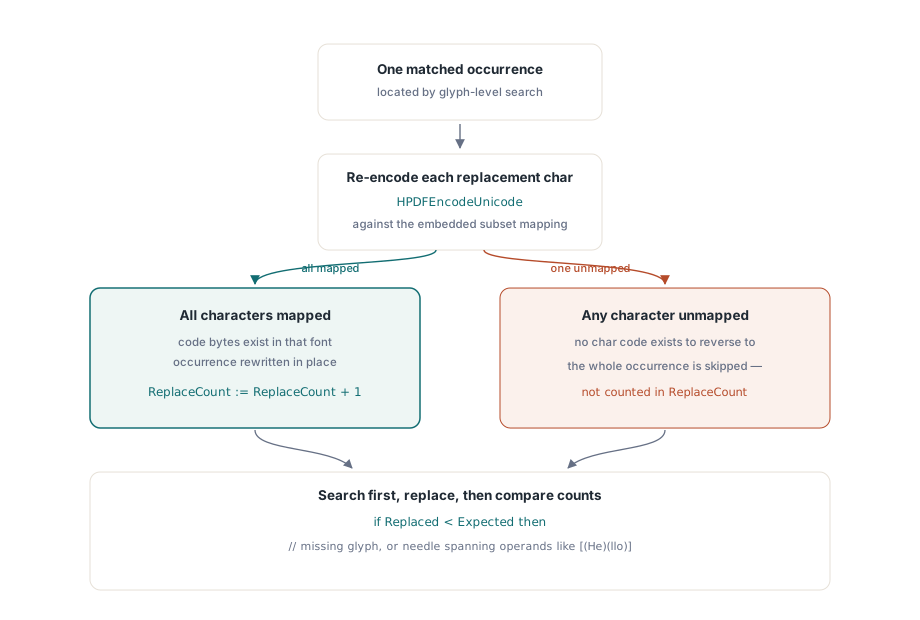
ReplaceCount 报告的是操作数重写次数,一次跨多个操作数的匹配可能算作不止一次重写。计数低于命中数仍然说明有东西被跳过,但确切答案来自替换之后再搜一遍。第二次搜索找到的,就是留下来的东西,带着页码和位置
procedure ReplaceAndAudit(Pdf: THotPDF; const OldText, NewText: UnicodeString);
var
  Before, After: THPDFTextMatchArray;
  Rewrites, I: Integer;
begin
  // 只有当 NewText 本身不包含 OldText 时,重搜才有意义
  Pdf.SearchLoadedDocumentText(OldText, True, Before);
  Pdf.ReplaceLoadedDocumentText(OldText, NewText, True, Rewrites);
  Pdf.SearchLoadedDocumentText(OldText, True, After);
  WriteLn(Format('%d found, %d operand rewrites, %d left',
    [Length(Before), Rewrites, Length(After)]));
  for I := 0 to High(After) do
    WriteLn(Format('  left on page %d at (%.1f, %.1f)',
      [After[I].PageIndex + 1, After[I].X, After[I].Y]));
end;
子集不够用时:换用新字体预览并应用
对字节级方法编码不了的出现位置,PreviewLoadedPageTextReplacement 和 ApplyLoadedPageTextReplacement 换一条路:移除匹配的字形,用你选的字体、按原字号、在原基线上就地绘制替换文本。默认的 THPDFLoadedTextReplacementOptions 以匹配文本的字号用 Arial,把框撑到匹配文本的宽度,并保持 Atomic 开启——页面上只要有一个匹配被拒,其余全部回滚。预览返回一个计划,每个匹配一条结果,各带 Status,被拒的还有 Reason
var
  Opts: THPDFLoadedTextReplacementOptions;
  Plan, Applied: THPDFLoadedTextReplacementPlan;
  I: Integer;
begin
  // Pdf 是已加载的 THotPDF;PageIndex 是审计标记的从 0 数起的页
  Opts := THPDFLoadedTextReplacementOptions.Default;
  Opts.Appearance.FontName := 'Arial';
  Opts.Appearance.OverflowPolicy := ltopShrinkToFit;
  Opts.Appearance.MinFontSize := 6;
  if not Pdf.PreviewLoadedPageTextReplacement(PageIndex, 'Acme Corp',
    'Apex Corporation', True, Opts, Plan) then
    for I := 0 to High(Plan.Results) do
      if Plan.Results[I].Status = ltrsRejected then
        WriteLn(Format('match %d at (%.1f, %.1f): %s',
          [I, Plan.Results[I].X, Plan.Results[I].Y, Plan.Results[I].Reason]));
  if (Plan.RejectedCount = 0) and (Plan.ReadyCount > 0) then
  begin
    Pdf.ApplyLoadedPageTextReplacement(Plan, Applied);
    WriteLn(Format('%d of %d matches applied',
      [Applied.AppliedCount, Applied.MatchedCount]));
  end;
end;
拒绝理由值得打印出来,因为它们直接对应页面几何。跨行——从一行文本跨到下一行的匹配——会被拒绝,竖排文本同样。默认 ltopReject 溢出策略下,装不进匹配宽度的替换文本也被拒绝。ltopShrinkToFit 则向 MinFontSize 逐级缩小字号——这正是示例设它的原因,因为替换文本比查找词长了五个字符。替换文本含有所选字体显示不了的字符时同样被拒
计划携带页面内容与字体的指纹。预览与应用之间如果有任何东西改动了页面,ApplyLoadedPageTextReplacement 会抛 EInvalidOpException,而不是往预览从未见过的页面上写。带不配对 q/Q 或 BT/ET 的页面、含签名字段的文档,抛 EArgumentException;已签名的文档需要增量更新,被签名的修订因此保持完好
字节级替换先行,字体替换路径只在审计仍能找到旧文本的页面上运行。字节级重写保留原字体、它的度量和字距,编辑后的文本与同一行上的邻居保持一致。预览路径用另一种字型绘制,在用窄体或衬线体排版的行上,细心的读者会看出变化。当目标是让文字消失而不是改写它时,真正的内容移除是更好的工具;在 Delphi 中对已加载 PDF 涂黑与重组讲了那条路
保存后的文件里变了什么
被 ReplaceLoadedPageText 编辑过的内容流以未压缩方式保存。流为编辑而解码,重建的字节写回时,它的 /Filter 和 /DecodeParms 条目被移除,/Length 刷新。PDF 有效、渲染正常;代价是每条被编辑的流都让文件变大。对几千份发票跑批处理,应当为这个增长留出预算,或在事后补一道压缩
预览加应用的路径改动略多。被应用的页面以一条新的未压缩内容流替换原 /Contents,外加一份自己的资源字典副本,替换字体加在其中。文档里其余一切不动:未触碰的流保留压缩,既有字体和图像不被重写,没有命中的页面绝不打开写入。重写后的对象在保存时如何落进交叉引用结构,见HotPDF 中的对象流与增量更新
搜索、字节级替换、预览加应用式替换、提取与涂黑都跑在同一个内容流解释器上,从 Delphi 5 到当前 RAD Studio,无外部依赖。方法参考、替换选项和试用版都在 HotPDF Delphi Component 产品页