你手上有一万份出自十几种不同生成器的合同 PDF,法务部门要求每一份都带上正确的 Author、一个修正过的 Producer 字符串,以及一种打开时就展开书签面板的阅读模式。最省事的做法是把每个文件加载进来,重新排布页面,再写出一份全新的文档。这么一来,你就把原有的每一个对象号、增量更新历史、任何数字签名,以及原始工具精心生成的 xref 统统丢掉了。页面看上去一模一样,可文件在结构上已经是个陌生人。对一次元数据编辑而言,这笔交换完全不划算
正确的做法是把已加载的文档当成一张可以就地修改的对象图:伸手进 Info 字典、/Metadata 流和 Catalog,只改你在意的那几个条目,然后把结果写回去。HotPDF 是面向 Delphi 和 C++Builder 的原生 VCL PDF 组件,它的已加载文档写入 API 暴露的正是这样一个操作面。本文讲的就是如何正确使用它,以及几乎人人都会犯的那个错误:改了 Info 字典,却忘了同一份元数据还有一份副本躺在 XMP 里
同一份元数据存在两个地方,而且它们会互相矛盾
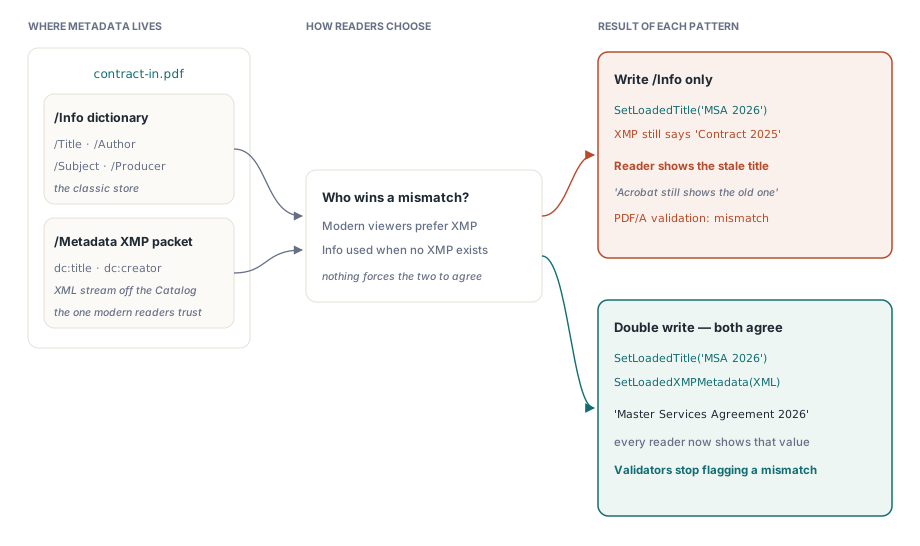
PDF 把文档信息保存在两个平行的位置,这正是大多数“我改了标题,可 Acrobat 还是显示旧的”这类工单的根源。第一个是文档信息字典,也就是经典的 /Info 对象,带有 /Title、/Author、/Subject、/Keywords、/Creator 和 /Producer 键,定义在 ISO 32000-1 §14.3.3。第二个是 XMP 数据包,一份以流的形式挂在 Catalog 的 /Metadata 之下的 XML 文档,定义在 §14.3.2,建立在 Adobe XMP 数据模型之上
两边都能保存标题。规范里没有任何条款强制它们保持一致。现代查看器和大多数 PDF/A 校验器在 XMP 数据包存在时优先采信它,只有在它缺席时才回落到 Info 字典。所以如果你只更新 /Info — 绝大多数“设置 PDF 元数据”的代码就是这么干的 — 那么信任 XMP 的阅读器会继续显示陈旧的值,PDF/A 检查器也会把这处不一致标记出来。对任何已经带有 XMP 数据包的文件,正确的操作是双重写入:既改 Info 条目,又重新生成 XMP,让两者始终一致。HotPDF 把两半都给了你;把它们配合起来用的纪律得靠你自己
编辑 Info 字典
Info 一侧的辅助方法既轻薄又可预期。SetLoadedTitle、SetLoadedAuthor、SetLoadedSubject、SetLoadedKeywords、SetLoadedCreator 和 SetLoadedProducer 各接受一个 AnsiString,把对应的键写进已加载的 Info 字典,键已存在就替换其值,不存在就新增。要彻底删掉某个键 — 比如一个泄露了你内部工具名的 /Creator — 就用裸键名调用 RemoveLoadedInfoKey。这些方法都不碰 XMP;它们只操作 LoadFromFile 解析文件时定位到的那个 /Info 对象
var
  Pdf: THotPDF;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('contract-in.pdf', '') > 0 then
    begin
      Pdf.SetLoadedTitle('Master Services Agreement 2026');
      Pdf.SetLoadedAuthor('Legal Department');
      Pdf.SetLoadedSubject('Executed contract, retention 7 years');
      Pdf.SetLoadedKeywords('contract; MSA; 2026; executed');
      Pdf.SetLoadedProducer('Acme Document Pipeline');
      Pdf.RemoveLoadedInfoKey('Creator');  // 丢掉原始的工具名
      Pdf.SaveLoadedDocument('contract-out.pdf');
    end;
  finally
    Pdf.Free;
  end;
end;
有个细节要如实交代:这些方法接受的是 AnsiString。标题是 ASCII 时这不成问题,但需要非拉丁字符的 PDF 文本字符串必须按规范要求先编码 — 带字节序标记的 UTF-16BE,或者 PDFDocEncoding — 再交给它们。库会把你给的字节原样写进一个字符串对象;它不会替你猜编码。如果你的标题是纯英文,忽略这一条。如果它们带重音符号或 CJK 字符,就有意识地编码,并在真实查看器里验证
重写 XMP 数据包
SetLoadedXMPMetadata 是双重写入的另一半。把完整的 XMP 数据包作为 AnsiString 传给它,它会做两件事之一:如果 Catalog 已经引用了一个 /Metadata 流,它就原地替换该流的内容,保持对象号不变;如果还没有元数据流,它就新建一个,标记为 /Type /Metadata 和 /Subtype /XML,分配对象号,并从 Catalog 链接过去。两种情况下你得到的都是一个查看器能读懂的有效元数据对象
XML 由你提供,这意味着模式由你掌控 — dc:title、dc:creator、xmp:CreatorTool 等等。这既是权力也是责任:库不会解析或校验你的数据包,而且写出的字节未经压缩,不施加任何流过滤器。一个格式错误的数据包会顺利通过这次调用,稍后再以“元数据损坏”的投诉浮出水面。仔细构造这段 XML,把你写进 Info 字典的值精确镜像过来,两种视图才永远不会互相矛盾
const
  XMP_TEMPLATE =
    '<?xpacket begin="" id="W5M0MpCehiHzreSzNTczkc9d"?>' +
    '<x:xmpmeta xmlns:x="adobe:ns:meta/">' +
    '<rdf:RDF xmlns:rdf="http://www.w3.org/1999/02/22-rdf-syntax-ns#">' +
    '<rdf:Description rdf:about="" xmlns:dc="http://purl.org/dc/elements/1.1/">' +
    '<dc:title><rdf:Alt><rdf:li xml:lang="x-default">%s</rdf:li></rdf:Alt></dc:title>' +
    '<dc:creator><rdf:Seq><rdf:li>%s</rdf:li></rdf:Seq></dc:creator>' +
    '</rdf:Description></rdf:RDF></x:xmpmeta><?xpacket end="w"?>';
begin
  // 设置完 Info 字典后,把同样的值镜像进 XMP:
  Pdf.SetLoadedTitle('Master Services Agreement 2026');
  Pdf.SetLoadedAuthor('Legal Department');
  Pdf.SetLoadedXMPMetadata(
    AnsiString(Format(XMP_TEMPLATE,
      ['Master Services Agreement 2026', 'Legal Department'])));
  Pdf.SaveLoadedDocument('contract-out.pdf');
end;
这个顺序 — 先 Info,再 XMP,然后保存 — 是需要内化的模式。两次调用彼此独立;一致性之所以成立,仅仅因为你喂给它们的是同样的字符串。在一个已有 XMP 数据包的文件上跳过 XMP 调用,你就又回到了整节内容旨在预防的那个静默陈旧 bug
操控查看器打开文件的方式
有三个 Catalog 条目决定了文档打开的瞬间阅读器呈现什么,而这三处在已加载的对象图上都是一行改动。SetLoadedPageMode 把 /PageMode 写成一个名称对象:传 'UseOutlines' 弹出书签面板,'UseThumbs' 显示缩略图栏,'FullScreen' 进入演示模式,'UseAttachments' 则显示附件窗格(ISO 32000-1 §7.7.3.1,表 28)。SetLoadedPageLayout 以同样方式写 /PageLayout — 'SinglePage'、'OneColumn'、'TwoColumnLeft' 等等。两者接受的名称都不带前导斜杠;库会在输出时补上
SetLoadedLanguage 写入 Catalog 的 /Lang 条目,也就是整份文档的自然语言标签 — 'en-US'、'de-DE',一个 BCP 47 标签。注意那处绊倒不少人的类型差异:/PageMode 和 /PageLayout 是 PDF 的名称对象,而 /Lang 是字符串。HotPDF 内部处理得没错,但你若去检视输出,会看到 /PageMode /UseOutlines 与 /Lang (en-US) 并列,现在你知道原因了。/Lang 条目的分量比看上去更重:辅助技术正是靠它挑选发音,它也是 PDF/UA 无障碍合规的硬性要求
if Pdf.LoadFromFile('handbook.pdf', '') > 0 then
begin
  Pdf.SetLoadedPageMode('UseOutlines');     // /PageMode,一个名称对象
  Pdf.SetLoadedPageLayout('TwoColumnLeft'); // /PageLayout,一个名称对象
  Pdf.SetLoadedLanguage('en-US');           // /Lang,一个字符串
  Pdf.SaveLoadedDocument('handbook-tagged.pdf');
end;
重命名书签而不扰动整棵树
书签标题属于例行清理 — 标题里的一个错字,或者大纲建好之后被重新编号的某一章。SetLoadedOutlineTitle 接受一个指向顶层大纲条目的零基索引和一个新标题,沿 Catalog → /Outlines → /First → /Next 链走到那个位置,替换该条目的 /Title 字符串。它只改标题;目标位置、展开或折叠状态以及子结构都不受影响
if Pdf.LoadFromFile('report.pdf', '') > 0 then
begin
  Pdf.SetLoadedOutlineTitle(0, 'Executive Summary');
  Pdf.SetLoadedOutlineTitle(1, 'Financial Results');
  Pdf.SaveLoadedDocument('report-renamed.pdf');
end;重命名之所以安全,恰恰因为它从不触碰结构性计数器。删除一个大纲条目才是会咬人的情形,即便你只做重命名也值得理解它,因为它告诉你哪些东西不该手工编辑。每个大纲节点都带一个 /Count,而 — 按 ISO 32000-1 §12.3.3 — 这个计数并不是直接子节点的数量。它是可见后代的总数:正的 /Count 为 N 表示当前有 N 个后代处于展开状态,负值则表示该节点有后代但已折叠。当一个顶层条目被移除时,/Outlines 根节点的计数不能简单地减一;它必须重新计算,对每个存活的顶层节点按“节点自身算一个,加上它的正 /Count”求和,并跳过任何折叠(负计数)节点的后代。算错了,阅读器显示的书签总数就会漂移 — 每删一条它跳动的幅度都不止一
保存为何是就地进行的
上面每一次编辑都只改动内存中的对象;在 SaveLoadedDocument 运行之前,没有任何东西落到磁盘。这套做法之所以便宜,是因为保存并不重新生成文档 — 它保留既有的对象号和 HotPDF 加载时解析出的结构,把同一张图连同你那少数几个改过的和新分配的对象一起写回去。正是这一点让一次元数据处理不必重写整个文件,而它用的也正是让对象流与增量更新得以工作的同一套就地更新机制。如果你的源文件出自 Word 或别的办公套件,它们的对象布局有自己的怪癖,编辑之前值得先了解;讲 Office PDF 中的混合引用交叉引用流的那篇文章说明了这类文件的结构,以及往返一趟后有哪些东西能存活
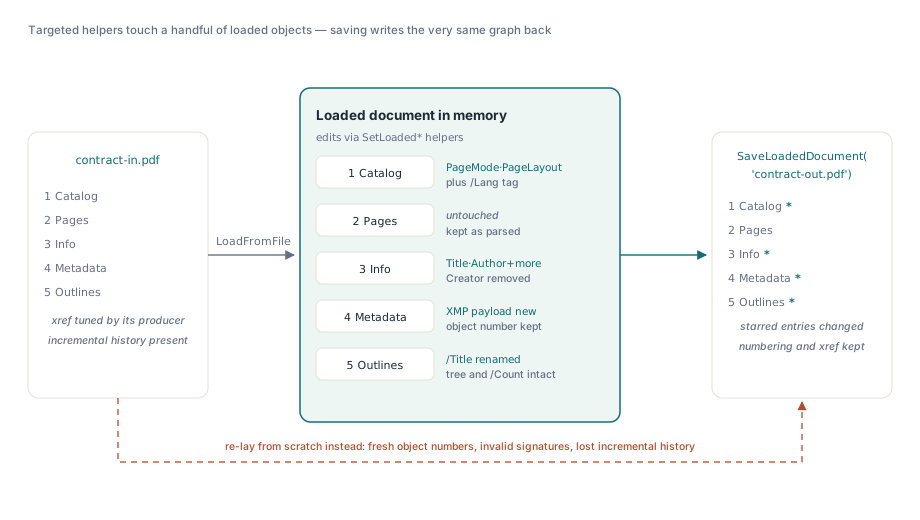
有两条边界要守。第一,这是一个就地编辑模型,不是脱敏或清洗工具:移除一个 Info 键就是移除那个键,但它不会清除可能残留在同一文件早前某代增量更新中的旧值。如果你的要求是真正抹除敏感元数据,那是另一件更重的事。第二,XMP 写入是字面的 — 库信任你的 XML,不做校验 — 所以凡是要送进 PDF/A 或严格校验器的内容,都应从一个已知可用的模板生成数据包,并验证输出。在这些界限内使用,就地元数据编辑是尺寸恰当的工具:它修好那几个错了的字节,把文件里已经正确的百分之九十九原封不动地留成原始生成器写下的样子
本文展示的已加载文档写入 API 随面向 Delphi 和 C++Builder 的标准 HotPDF Delphi Component 一同提供,同时附带完整的元数据、大纲和 Catalog 编辑方法集