内容流片段 [(Reference)-333(Manual)] TJ 画出两个词、中间有明显的空隙,却不包含任何空格字符。空隙是笔的移动:ISO 32000-1 §9.4.3 让阅读器在画 Manual 之前把下一个字形右移字号的千分之 333。一个只抄字符、无视几何的提取器返回 ReferenceManual,喂给搜索索引就永远匹配不上“Reference Manual”这个短语。TeX 输出、许多 Distiller 文件和大多数两端对齐的排版都用这种方式分隔单词
换行则从另一头出错。上标把一行劈成两行,斜着的 DRAFT 水印一行一个字,裁切过的校样开头带着阅读器从不显示的印前标记行(printer’s slug line)。这些文件没有一个坏了。每一个都用了合法的文字摆放方式,而抄字符的提取器恰好读错
从字形几何重建词间空格
HotPDF Delphi Component 的 THotPDF.ExtractLoadedPageText 从字形位置判断词断,流里的空格字符只是它读到的信号之一。沿前一个字形的书写方向(glyph’s writing direction),它测量从该字形自身宽度(glyph’s own width)的终点到当前字形原点的距离,距离超过当前字形盒高度(glyph’s box height,按用户空间从上伸量到下伸)的 0.15 时插入一个空格。对上面的 TJ 片段,三分之一个 em 对任何普通文本字体都稳稳越过了这条线,所以页面文本读作 Reference Manual
两个条件会把空格按住。到此为止的文本已经以空白结尾、或下一个字形就是空白(空格、制表符、不换行空格、全角空格)时,不再添加,所以确实写出空格的生成器不会得到双份。两个 CJK 字符之间也不添加。汉字、假名、谚文和全角形式都算 CJK,因为两端对齐会把中文或日文一行拉开,而那种拉伸并不意味着词边界。与两者分开的还有一条:高度为零的字形盒回落到 Tf 字号作为高度。规则用到的每个数字都存在字形记录上,间距看起来不对的文件可以逐字形重放
uses
  SysUtils, HPDFDoc, HPDFContentStream;

// 打印出 ExtractLoadedPageText 会变成空格的那些间隙。
// 仅水平文本;ExtractLoadedPageGlyphs 返回页面
// 内容流,不含 Form XObject 文本,也不做裁剪过滤
procedure DumpWordGaps(Pdf: THotPDF; PageIndex: Integer);
var
  Glyphs: THPDFGlyphArray;
  I: Integer;
  Height, Gap: Double;
begin
  if not Pdf.ExtractLoadedPageGlyphs(PageIndex, Glyphs) then
    Exit;
  for I := 1 to High(Glyphs) do
  begin
    if Glyphs[I].Vertical or Glyphs[I - 1].Vertical then
      Continue;
    // 字形盒从上伸到下伸的高度,用户空间
    Height := Sqrt(Sqr(Glyphs[I].QuadX[3] - Glyphs[I].QuadX[0]) +
      Sqr(Glyphs[I].QuadY[3] - Glyphs[I].QuadY[0]));
    if Height <= 0 then
      Height := Abs(Glyphs[I].FontSize);
    // 间隙从前一个字形自身宽度的终点量起
    Gap := Glyphs[I].BaselineStartX - Glyphs[I - 1].GlyphEndX;
    if (Height > 0) and (Gap > 0.15 * Height) then
      Writeln(Format('U+%.4x gap %.2f height %.2f: space',
        [Glyphs[I].Unicode, Gap, Height]));
  end;
end;
为什么不从笔位置而要从字形自身宽度(glyph’s own width)量起?
因为字形之后的笔位置已经包含了与词断毫无关系的间距。ISO 32000-1 §9.4.4 把水平位移定义为字形宽度乘以字号,加上字符间距 Tc,再加上词间距 Tw,全部再乘水平缩放 Tz。每个字形记录两头都带:BaselineEndX / BaselineEndY 存完整位移,而 GlyphEndX / GlyphEndY 只存字体在当前字号下的前进量(the font’s advance)与 Tz。两者在用负 Tc 收紧字距、再靠每个字形后的 TJ 调整把空间还回来的文件上分道扬镳。从笔位置量起,每一次归还看起来都像间隙,“95后”这样的中文词会变成“9 5 后”。从字形自身宽度(glyph’s own width)量起,调整只归还 Tc 拿走的东西,词保持完整
阈值系在字形盒高度而不是 Tf 字号上,理由同源。Word 导出常写 1 Tf、把真实字号放进缩放过的 Tm,于是字号操作数读作 1,文本却有 10 磅高。以那个操作数为钥匙的规则会把阈值放在这种页面的 0.15 磅上,普通的字距对开始被读成词断。盒高度在所有矩阵应用完之后测量,所以带缩放矩阵的 1 Tf 与朴素的 10 Tf 产出同样的文本
两个边界情况直接由几何推出。用极宽字距排的标题——光 Tc 就在字母间撑开超过文本高度 0.15 的那种——会提取成 S P A C E D。页面看起来的样子就是这样,我们宁可原样返回,也不加一个猜测哪些宽间隙是字距、哪些是词的启发式;那种猜测在排得紧的两栏里会开始吞掉真正的词断,对搜索是更糟的失败。同一条基线上乱序绘制的片段产生负间隙,直接相连不加空格。正文里这种情况罕见
提取文本里的新行从哪开始?
ExtractLoadedPageText 在从前一个字形的原点(glyph’s origin)到当前原点的移动、投影到前一书写方向的法线上、超过两个字形中较大盒高的一半时,开启新行。沿基线的移动永远不算换行,无论笔跳多远
拿原始 Y 移动与 Tf 字号一半比较的规则在两个方向上翻车。1 Tf 加缩放过的 Tm 让阈值缩到半个单位,于是被 0.4 的 text rise 抬起来的上标断行。有些排版引擎在 run 之间留下的小基线抖动同样断行。同一条规则还完全无视 X。在旋转过的 Tm 下——比如那道斜水印——文本逐字形沿页面向下走,输出一行一个字,而投影把 45 度的 run 处理得与水平的完全一样
同一行里字号混杂时,取两者较大的高度很重要。36 磅的展示词后面跟一个低几磅的 8 磅说明文字,判据是大字形高度(the large glyph’s height)的一半,两个一起留下;只拿小字形判断,说明文字就会自占一行。text rise 是字形原点的一部分,这就是为什么上标抬起的基线(superscript’s raised baseline)也用同一半高度来量
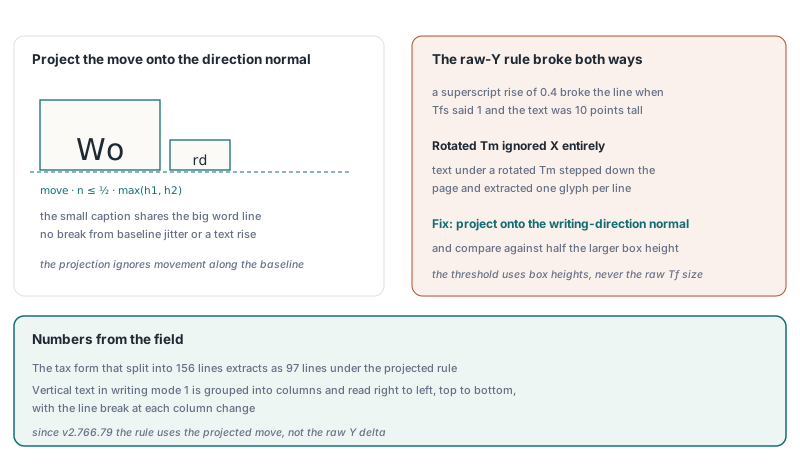
书写模式 1(§9.7.4.3)里的竖排文本走单独的路径。那些字形按原点 X 分组成列,列容差为半个字号,然后从右到左、从上到下读取,每次换列加一个换行。竖排日文正文混横排页眉的页面,在两个方向之间的每次切换处同样得到换行
哪些字形进入页面文本
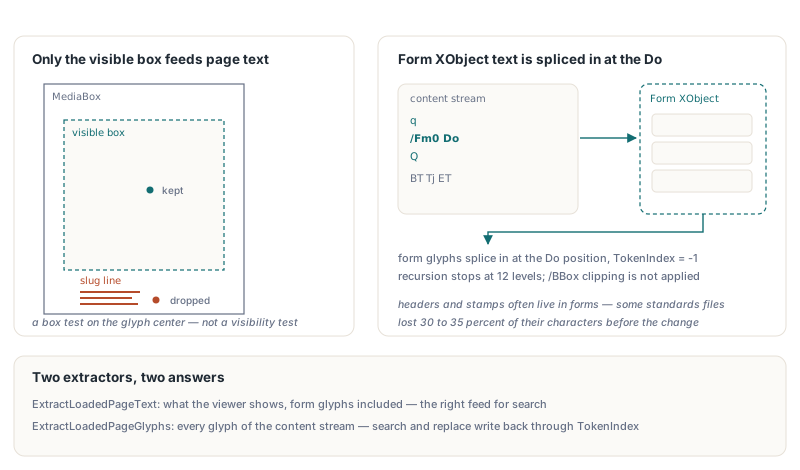
ExtractLoadedPageText 返回阅读器显示的文本。它只保留盒中心落在 GetLoadedPageVisibleBox 内的字形——后者是裁剪到 MediaBox 的 CropBox(§14.11.2)——所以裁切区外作为文本写的印前标记(printer’s marks)和划线行被丢弃。需要它们的活儿仍然可以走 ExtractLoadedPageGlyphs,它继续返回页面内容流的每一个字形,印前标记行也在内。过滤器是对每个字形一个点的几何测试。被裁剪路径藏住、画成白色或被图像盖住的文本照样出来,因为判定真实可见性意味着渲染整页
uses
  SysUtils, HPDFDoc, HPDFContentStream;

var
  Pdf: THotPDF;
  Raw, Merged: THPDFGlyphArray;
  PageText: UnicodeString;
  L, B, R, T: Single;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.LoadFromFile('trimmed-proof.pdf');
    if Pdf.GetLoadedPageVisibleBox(0, L, B, R, T) then
      Writeln(Format('Visible box: %.1f %.1f %.1f %.1f', [L, B, R, T]));
    // 页面内容流的每个字形,印前标记行也在内
    if Pdf.ExtractLoadedPageGlyphs(0, Raw) then
      Writeln(Length(Raw), ' glyphs in the page content stream');
    // 页面流加 Form XObject 文本,按绘制顺序,裁剪之前
    if Pdf.ExtractLoadedPageGlyphsWithForms(0, Merged) then
      Writeln(Length(Merged), ' glyphs including forms');
    // 页面显示的内容:表单拼接进来,裁剪框外的字形丢弃
    if Pdf.ExtractLoadedPageText(0, PageText) then
      Writeln(PageText);
    // 同一套间距规则作用于未过滤的流,供对比
    Writeln(HPDFAssemblePageText(Raw));
  finally
    Pdf.Free;
  end;
end.
经 Form XObject 绘制的文本是页面文本的一部分。页眉、印章和水印常常住在表单里,只读页面内容流的提取器永远看不见它们。HotPDF 把每个 Do 连同生效的 CTM 一起记录,按表单的 /Matrix 乘该 CTM(§8.10.1)解释表单,把表单的字形(the form’s glyphs)拼接在 Do 的位置上,并递归进入嵌套表单。没有自己 /Resources 的表单借用绘制它的流的那份——§7.8.3 描述的较早安排。字形中心落在表单 /BBox(the form’s /BBox)之外的不要,因为绘制时那个框裁剪表单。直接或经由另一个表单绘制自身的表单不会被第二次进入,嵌套在 12 层封顶
表单字形带着 TokenIndex = -1 和 ItemIndex = -1。同样的理由让 ExtractLoadedPageGlyphs 只限于页面流字形:搜索、替换和涂改要经 TokenIndex 把改动写回去,数组里的表单字形会把它们指向另一条流里的字节。需要在字形层级拿合并列表时,ExtractLoadedPageGlyphsWithForms 按绘制顺序返回它,在可见框过滤器运行之前
间距规则之前还有一道工序。叠印的 logo 和靠同一段文本带小偏移画两遍伪造的粗体,否则会让每个字母都翻倍。当一个字形在沿基线十分之一、横向五分之一的范围内、以相同字号重复绘制早先字形的同一字符时,只保留一份;空格永远不会被这样去掉。文本提取中的伪粗体与重复字形一文细讲这个案例
跨 q 与 Q 的文本状态
只把 CTM 存进 q 的提取器,Q 之后的文本都会解错。文本状态参数——字体、字号、Tc、Tw、Tz、TL、渲染模式和 text rise——属于图形状态(§9.3.1),所以 Q 必须连同栈上其余一切一起恢复它们(§8.4.2)。有一个模式能很快暴露这个错误:一个两字节的 Identity-H 字体在 q … Q 内部为单个表格单元选中,Q 之后的文本显示的是没有自己 Tf 的单字节 WinAnsi 字符串。保留内部字体的解释器把这些字节成对读取,目录的引导点变成一串不相干的 CJK 字符。HotPDF 的解释器在每次 q 时把全部八个文本状态值连同 CTM 一起压栈,每次 Q 弹出
以上一切在每一页都成立,所以整份文档可以一次调用写进 UTF-8 文件。ExtractLoadedPagesTextToStream 接受一基页码范围(空串表示所有页)、写在页与页之间的分隔符和一个字节序标记开关,返回提取的页数。输出追加在流当前位置(the stream’s current position),内存里不会持有超过一页文本(one page’s text)的量
uses
  SysUtils, Classes, HPDFDoc;

var
  Pdf: THotPDF;
  Output: TFileStream;
  Pages: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.LoadFromFile('report.pdf');
    Output := TFileStream.Create('report.txt', fmCreate);
    try
      // 空范围 = 所有页;页间换页符;UTF-8 BOM
      Pages := Pdf.ExtractLoadedPagesTextToStream(Output, '', #12, True);
      Writeln(Pages, ' pages extracted');
    finally
      Output.Free;
    end;
  finally
    Pdf.Free;
  end;
end.
为活儿挑对文本 API
做搜索和索引,ExtractLoadedPageText 是对的进货口:它遵循内容流顺序、反映页面显示的内容。它底下的解码链——从 /ToUnicode 映射到 CID 字体——见用 HotPDF 从已加载 PDF 提取文本。内容流顺序最弱的场景是生成器把页眉写到最后、或把两栏穿插写的带标签文档;对那些,结构顺序文本提取改为按创作顺序遍历结构树,而不是从几何推断。锁在表格里的数据更适合跨页的类型化表格提取,它返回带值的单元格。要编辑页面的代码归 ExtractLoadedPageGlyphs,它的 token 索引指向即将重写的字节
这些示例用到的字形记录字段,连同其余文本提取 API 和试用版,文档都在 HotPDF Delphi PDF Component 产品页