PDFium Component 可透過 ExtractTables(針對單一頁面)與 ExtractDocumentTables(針對整份文件),偵測 PDF 頁面上的表格,並以帶有跨列跨欄範圍、標題列與信心值的儲存格網格形式傳回。每個表格都能以單次呼叫轉換為 CSV 或 JSON,而跨越分頁的表格則可以連結成一條延續鏈
PDF 並沒有表格物件。PDF 中的表格,只是一組經過定位的文字片段,讓人類讀起來像一張網格,有時周圍畫有線條,但往往沒有。要還原這張網格,就等於要重建一個檔案本身從未記錄下來的意圖,這也是為何每種擷取工具產生的結果都略有不同,以及為何一個會告訴你信心值的工具,會比不告訴你的工具更有用
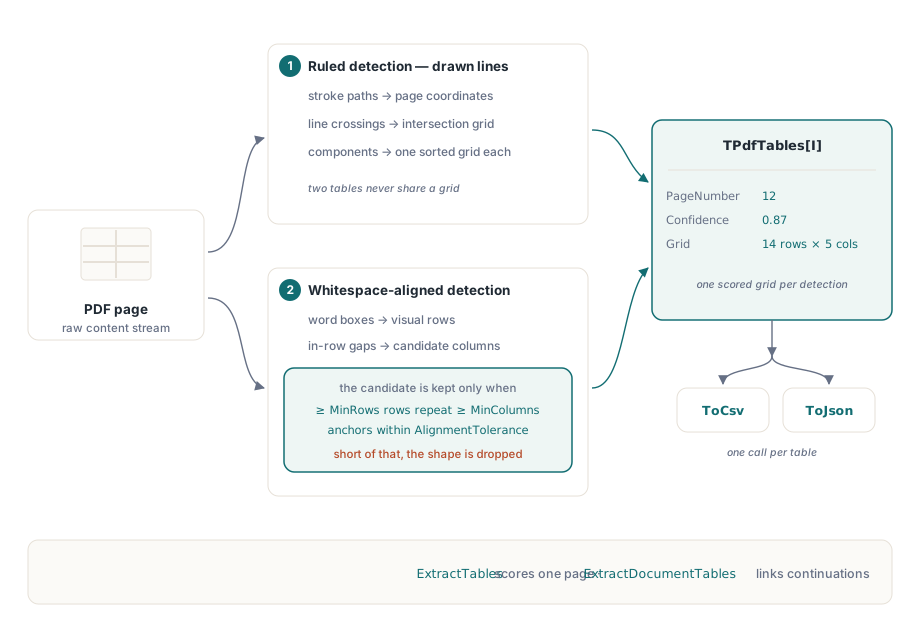
兩種偵測模式,對應兩種表格
框線偵測利用實際畫出的線條。每一段描邊路徑,都會透過頁面物件的矩陣轉換成頁面座標,水平線與垂直線互相求交,這些交點再組成連通元件。每個元件都會各自形成一個排序過的 X、Y 位置網格,這正是讓同一頁上兩張各自獨立的表格,不會被誤合併成一張無意義大網格的關鍵
留白偵測則處理以對齊方式而非線條繪製的表格。文字框會被歸組成視覺列,列內的間隙把它切分成候選欄,而只有當至少 MinRows 列,在 AlignmentTolerance 容差範圍內,重複出現至少 MinColumns 個左對齊錨點時,才會被接受為一張表格。列間隙係數預設為 3,涵蓋了 12 級字型典型約 30 點基線間距的情況,同時避免讓包含多個文字片段的單一行文字被誤判成表格
uses
  PDFium;

var
  Pdf: TPdf;
  Options: TPdfTableExtractionOptions;
  Tables: TPdfTables;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'annual-report.pdf';
    Pdf.LoadDocument;
    Pdf.PageNumber := 12;                    // 從 1 起算

    Options := TPdfTableExtractionOptions.Default;
    Options.DetectRuledTables := True;
    Options.DetectWhitespaceTables := True;
    Options.MinConfidence := 0.6;            // 預設值為 0.5
    Options.HeaderRowCount := 1;

    Tables := Pdf.ExtractTables(Options);
    for I := 0 to High(Tables) do
      Writeln(Format('table %d: %dx%d cells, confidence %.2f, mode %d',
        [I, Tables[I].RowCount, Tables[I].ColumnCount,
         Tables[I].Confidence, Ord(Tables[I].DetectionMode)]));

    if Length(Tables) > 0 then
      SaveText('page12-table0.csv', Tables[0].ToCsv);
  finally
    Pdf.Free;
  end;
end;
完整專案隨元件一併附上,位於 Demo/Delphi/TableExtractionLab/TableExtractionLab.dpr,C++Builder 與 Lazarus 的對應版本則分別在 Demo/CBuilder/TableExtractionLab 與 Demo/Lazarus/TableExtractionLab。這個 Lab 會產生一份範例文件,內含一張帶有合併標題儲存格的框線表格、一張不帶任何框線、純以留白對齊的表格,以及一張跨頁斷開的長表格,接著逐一擷取,並顯示儲存格、跨列跨欄範圍、信心值、延續群組,以及 CSV / JSON 輸出,可說是觀察這些設定如何互動的最快途徑。表格偵測功能是 3.36.0 版才加入的,因此若 TPdfTableExtractionOptions 或 TPdfTables 在編譯時被判定為未知識別字,代表您專案裡的那份程式庫副本比該版本還舊,得先更新,這段程式碼才有辦法建置
合併儲存格是如何還原的?
這正是天真的擷取工具容易出錯的地方。單靠全域網格是無法辨識出合併儲存格的,因為這張網格是從頁面上所有線條推導出來的,而一個合併區域,恰恰就是缺少了那條原本會把它分開的內部線條
這裡採用的規則是局部性的:當兩個相鄰的基礎儲存格之間,沒有任何邊界線覆蓋它們之間的區間時,就會被視為合併。並查集(union-find)會把它們連結起來,得到的矩形元件就成為 RowSpan 與 ColumnSpan 的值,文字則依其中心點指派給某個基礎儲存格,再跟隨該儲存格找到它的合併根。這種做法也讓成本與「文字數加儲存格數」呈線性關係,而不是逐一比對每個文字與每個儲存格所產生的二次方掃描
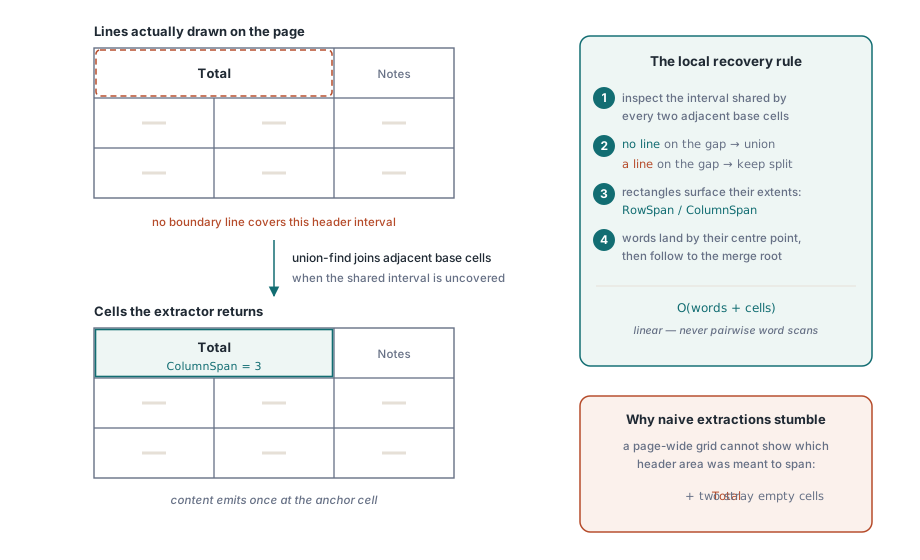
實務上的效果是,一張財務表格中橫跨三欄的合併「總計」標題,會以一個範圍為三的儲存格呈現,而不是一個有內容的儲存格,旁邊跟著兩個來歷不明的空儲存格
跨頁延續
長表格會跨頁斷開,若把每一頁的片段都當成獨立表格處理,就會迫使呼叫端自行把它們拼接起來。ExtractDocumentTables 則可以改為連結它們,但僅限於符合嚴格條件的情況:前一頁的片段必須是該頁最下方的表格,下一個片段必須是後一頁最上方的表格,頁碼必須相鄰,且欄邊界必須相符
這四項條件缺一不可,正是為了避免一個明顯的錯誤:只因為欄數剛好相同,就把文件中每一張四欄表格全部串成一張想像出來的巨型表格。當條件都成立時,這些表格會共用同一個延續群組識別碼並攜帶延續中繼資料;條件不成立時,你會得到各自獨立的表格,可以自行判斷該怎麼處理
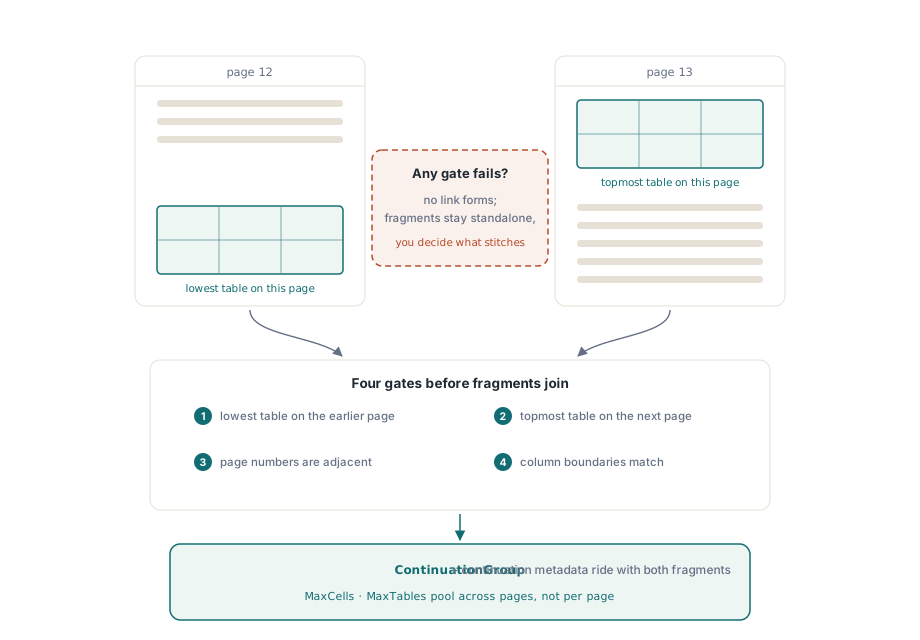
文件層級擷取會讓 MaxCells 與 MaxTables 額度在各頁之間共用,而不是每頁重新歸零,而且會在 finally 區塊中還原目前作用中的頁面,因此在檢視器中執行一次擷取,使用者結束後仍會停留在原本瀏覽的那一頁
匯出時不破壞資料
兩種匯出方式在跳脫處理上都經過刻意設計。CSV 一律為欄位加上引號,並把內部引號加倍,藉此避免一個典型錯誤:某個含有逗號的儲存格,悄悄變成兩個欄位。至於合併儲存格,內容只會在左上角錨點輸出一次,因此往返一次 CSV 不會讓一個跨欄標題在它所涵蓋的每一欄中重複出現
JSON 會保留 Unicode,而不是把它跳脫成 ASCII,會跳脫控制字元,並包含消費端判斷品質所需的中繼資料:偵測模式、信心值、邊界、跨列跨欄範圍值、標題旗標與延續資訊。若你要把擷取出的表格餵給下游系統,優先選用 JSON,因為一列 CSV 資料無法告訴你它所屬的表格信心值只有 0.51:
// 全文件擷取,只保留值得信任的表格
Tables := Pdf.ExtractDocumentTables(Options);
for I := 0 to High(Tables) do
begin
  if Tables[I].Confidence < 0.75 then
  begin
    Log(Format('page %d table needs review (%.2f)',
      [Tables[I].PageNumber, Tables[I].Confidence]));
    Continue;
  end;
  if Tables[I].ContinuationGroup > 0 then
    AppendToGroup(Tables[I].ContinuationGroup, Tables[I].ToJson)
  else
    EmitStandalone(Tables[I].ToJson);
end;
調校,以及知道何時該停手
三項設定比其他設定更重要。MinConfidence 是品質關卡,預設值 0.5 是刻意設得寬鬆的;自動化匯入時可以調高,而在由人工逐一確認結果的審閱介面中則可以調低。MinColumnGap 決定留白模式下什麼算是欄邊界,密集報表中排版緊湊的表格,可能需要把它從預設的 12 點下調。MaxRowGapFactor 決定垂直距離多大就視為表格結束,這對偶爾出現空白列的表格很重要
誠實面對這項功能的極限。框線表格能可靠地被擷取。乾淨對齊的留白表格也能擷取得不錯。至於含有旋轉文字、巢狀表格,或內容自動換行到看起來像另一列的儲存格,無論參數怎麼調整,都需要人工複核。針對這類情況,結構化文字模型能提供原始素材,讓你建構特定領域的讀取器,說明於結構化文字區塊與閱讀順序一文
有一種實用的搭配方式:當掃描文件完全沒有文字時,在文字層存在之前,表格偵測就無從下手。請先依為掃描 PDF 加入可搜尋文字層一文所述加入文字層,再進行擷取。OCR 供應者傳回的文字框,正是留白偵測所需要的輸入
表格擷取、結構化文字與重新流排版,在 Delphi、C++Builder 與 Lazarus 中都讀取自同一套頁面模型;完整 API 說明請見PDFium Component for Delphi 頁面