Word 匯出的表格跨了三頁,卻從來不會距離紙張底部 72 點以內。一英吋邊界是 72 點,文書處理器到邊界就停止排列表格列。只在片段相距頁緣 36 點以內才連結的連結器,看到的是三張欄位完全相同、卻互不相干的表格。有效的問法不同:除了每頁重複的頁首或頁尾,第一個片段的結尾與下一個片段的開頭之間還有沒有別的東西?
這個問題自帶兩個陷阱。表單可能在第 1 頁底結束一張表格,又在第 2 頁頂用相同的欄寬開出另一張表格;而格線表格也可能把單獨一列推過分頁點,短到想先看到兩列才承認是表格的偵測器無法認領
ExtractDocumentTables 裡的兩道邊緣測試
PDFium Component 在 TPdf.ExtractDocumentTables——每頁版 ExtractTables 的文件層級對應版本——裡標記接續,每頁版在表格偵測與擷取一文介紹過。設了 DetectContinuations(TPdfTableExtractionOptions.Default 預設就開)之後,這個方法擷取每一頁,按頁碼、再按每頁內由上而下的順序排序表格,然後檢查清單裡每一對相鄰項。只比較相鄰項。所以接續候選永遠是第 N 頁最低的表格配第 N+1 頁最高的表格,而第 N 頁放在長表格底下的小表格,會頂替長表格進入這個配對。短備註表格坐在長表格下面時,請在自己的程式碼裡按頁碼與 ColumnCount 自行連結這些片段
第一道測試純幾何。前一個片段的下緣必須落在頁底 ContinuationMargin 點之內,後一個片段的上緣落在下一頁頁頂同樣距離之內。預設 36 點,半英吋。填滿固定內容框的排版引擎報告輕鬆過關。一英吋邊界的 Word 匯出兩邊都至少差 36 點,而把邊界放大到過關也是錯的,因為同一個數字還設定著第二道測試的頁首與頁尾區帶
第二道測試,也就是內容感知的那道,才是處理文書處理器輸出的關鍵。兩者以 OR 結合:任一道通過就開閘
兩個片段之間什麼算文字?
頁面上每個詞都算內文,除非它完全落在每頁頁首區帶或頁尾區帶裡,兩條區帶的深度都是 ContinuationMargin 點。每頁 ExtractDocumentTables 記錄兩個極值:頂端在頁尾區帶之上的詞裡最低的下緣,以及底端在頁首區帶之下的詞裡最高的上緣——表格自身的儲存格文字也算在內。表格是第 N 頁最後一段內文時,它的下緣位於最低詞的下緣或更低,測試在 AlignmentTolerance(預設 3 點)之內通過。後一個片段得在第 N+1 頁頂滿足鏡像條件
忽略區帶在規範裡有依據。ISO 32000-1 §14.8.2.2 把頁首、頁尾與頁碼視為分頁產物——只因為文件被切成頁面才存在的內容。有標籤的檔案可以用 /Artifact 宣告它們,標記內容一文解釋過這點,但最需要表格縫合的匯出檔很少帶標籤,所以用位置代替標籤。用預設區帶時,字形頂端高於底邊 30 點的頁碼會被忽略;頂到 40 點的免責聲明是內文,它會擋下連結
沒有文字層的頁面上,存放的極值退回頁面邊界,內容感知測試直接通過,由其餘關卡決定。畫成影像或向量輪廓的頁尾基於同樣原因不可見,也從不擋連結
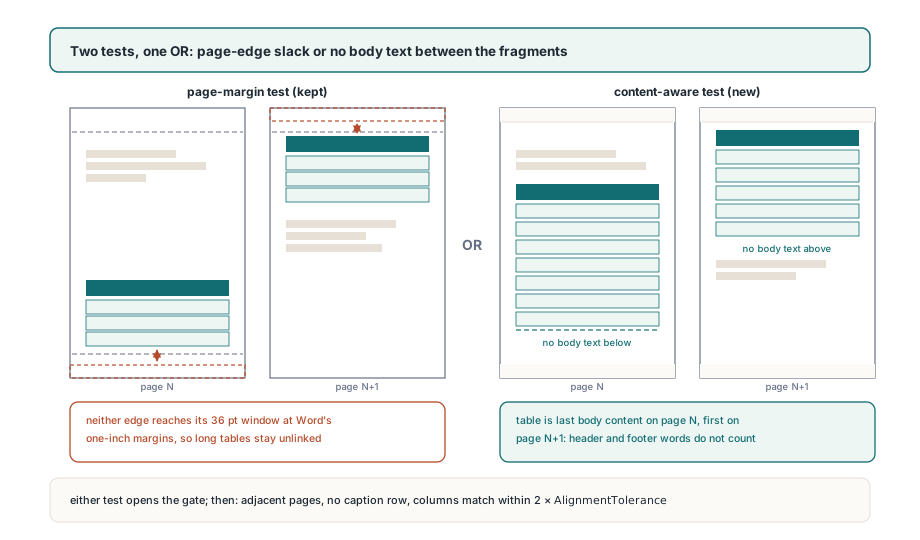
通過邊緣測試只是開閘。頁碼必須相鄰,後一個片段不得以標題列開頭,欄界線必須在兩倍 AlignmentTolerance(預設下 6 點)之內對齊。全部成立時,前一個片段成為帶新群組編號的 ptcStart,或從 ptcEnd 升為 ptcMiddle(若它已收束一條鏈),後一個片段則成為同一群的 ptcEnd。跨三頁的表格讀作 start、middle、end。群組編號從 1 起;群組 0 加 ptcNone 表示表格獨立。ToJson 以 "continuationGroup" 與 "continuation"(none、start、middle 或 end)寫出同樣的資料,收 JSON 的服務可以自行縫合
下面的清單假設 Word 匯出、頁尾是約 50 點深的兩行文字,所以邊界調到 54,讓兩行都落在區帶內
uses
  System.SysUtils, PDFium;

var
  Pdf: TPdf;
  Options: TPdfTableExtractionOptions;
  Tables: TPdfTables;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'itinerary-from-word.pdf';
    Pdf.LoadDocument;

    Options := TPdfTableExtractionOptions.Default;  // DetectContinuations = True
    Options.ContinuationMargin := 54;               // 假設頁尾約 50 點深

    Tables := Pdf.ExtractDocumentTables(Options);
    for I := 0 to High(Tables) do
      case Tables[I].Continuation of
        ptcStart:
          Writeln(Format('group %d starts on page %d, %d rows',
            [Tables[I].ContinuationGroup, Tables[I].PageNumber,
             Tables[I].RowCount]));
        ptcMiddle, ptcEnd:
          Writeln(Format('group %d continues on page %d, %d rows',
            [Tables[I].ContinuationGroup, Tables[I].PageNumber,
             Tables[I].RowCount]));
      else
        Writeln(Format('standalone table on page %d, %d x %d',
          [Tables[I].PageNumber, Tables[I].RowCount,
           Tables[I].ColumnCount]));
      end;
  finally
    Pdf.Free;
  end;
end.
全寬首列如何把兩張表格隔開
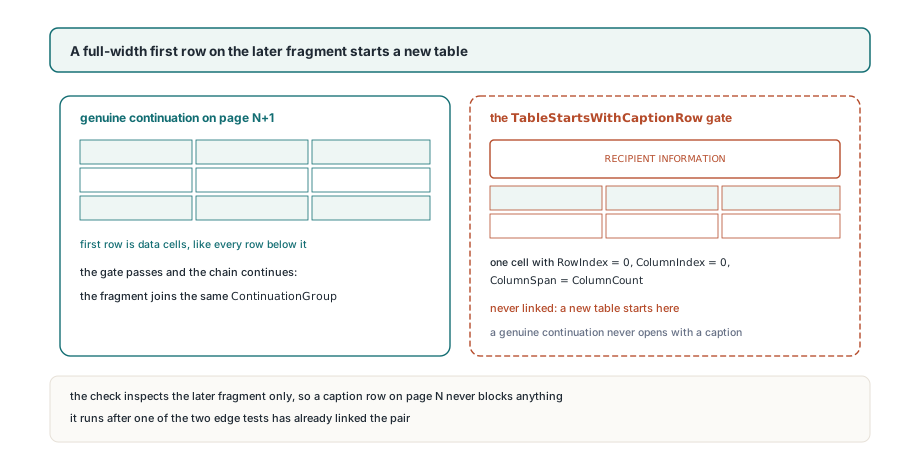
後一個片段的首列若是橫跨所有欄的單一儲存格,會被回報為新表格,就算邊緣測試通過、欄位也相符。表單正是內容感知測試會失手的地方:一張表格在第 1 頁底收尾,下一節在第 2 頁頂以相同欄寬開場,所有幾何檢查全過。差別在第二張表格的開場列——像 RECIPIENT INFORMATION 這樣、以全寬合併儲存格排版的節標題。真正的接續不會這樣開場,因為表格的標題留在表格開始的那一頁
這條規則只讀後一個片段的儲存格。該片段需要至少兩欄,以及一個 RowIndex = 0、ColumnIndex = 0 且 ColumnSpan = ColumnCount 的儲存格。前一個片段從不被檢查,所以標題自身坐在第 N 頁頂的表格,照常連到第 N+1 頁的接續
接下來的欄位比較比欄數相等嚴格。每個片段的邊界位置從其儲存格矩形重建;被合併儲存格遮住的邊界,按兩側最近的已知邊界均勻內插補出。然後逐對比較邊界,差異超過 6 點就拒絕連結。兩張比例不同的四欄表格會被隔開;真的接續若產生器在兩頁之間把某欄移了 8 點也一樣被拒,調高 AlignmentTolerance 來接納它的同時,也放寬了偵測時用來聚簇的標準
跨過分頁的一條格線列
格線表格把單獨一列推到下一頁時,接進鏈裡就保留這一列,沒接進去就丟掉。預設 MinRows 為 2,擋下兩條游離框線被誤報成表格。被推過分頁的列不同:它是真資料,丟掉它,縫好的表格就短一列,而且再也沒有片段能解釋這個缺口
文件掃描用三步處理。DetectContinuations 與 DetectRuledTables 都開時,格線偵測器在每一頁以降到 1 的列數下限運行。接著在完整結果上標記接續。最後,列數低於呼叫端 MinRows、又沒進任何鏈的表格會被移除。普通頁面中央的單列格線表格走過這道過濾器就消失,這正是 MinRows 的用途
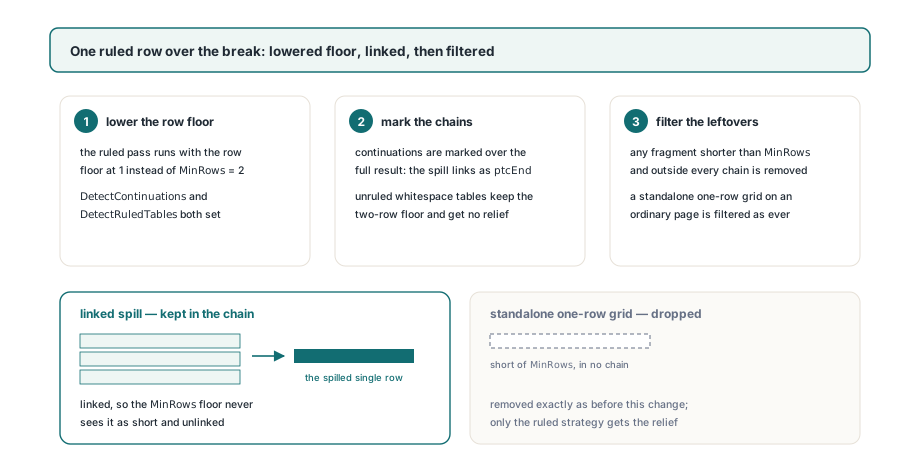
MinRows 維持 2。自己設成 1 等於關掉最後那道過濾器,每頁的每個單列格線表格都會回來
這個例外只適用格線表格。空白策略至少要兩列對齊才認得表格,所以不管 MinRows 說什麼,它內部維持 2 的下限;ExtractTables 接受 MinRows = 1,但只有格線偵測真的照辦。無框線表格溢出一列時,頁面的文字方框,或結構化文字區塊與閱讀順序一文描述的區塊,給你自行救回那一列的位置
把鏈縫回一張表格
鏈回來時是連續的。連結只發生在排序後陣列的相鄰項之間,所以 ptcStart 片段之後直接跟著它的 ptcMiddle 與 ptcEnd 片段;在 ptcNone 或 ptcStart 時重置、在 ptcNone 或 ptcEnd 時輸出的迴圈,完全不必按群組編號查任何東西
重複的表頭列是麻煩所在:Word 會在每一頁重複它,其他產生器不會。TPdfTableCell 的 IsHeader 旗標定不了這件事,因為它是按位置指定的——RowIndex < HeaderRowCount——而且每個片段分開算。接續的第 0 列不管重複表頭還是帶資料都會被標成表頭,上一節那條單列溢出也被標成表頭。下面的常式把每條接續首列的文字與鏈首列比較,只在完全相等時丟掉
它也從 Cells 建列,而不是把 ToCsv 輸出按行切開。儲存格內文字換列時,回傳的文字在視覺行之間帶 CR LF,ToCsv 把這個斷行留在引號欄位裡,直接刪掉 CSV 文字的第一行會把兩行的表頭儲存格攔腰切斷
// Reader-side helpers (not part of the library): rebuild each chain
// 成一份 Tab 分隔檔,丟掉後續頁面重複的表頭
function RowText(const T: TPdfTable; Row: Integer): string;
var
  Parts: array of string;
  I: Integer;
begin
  SetLength(Parts, T.ColumnCount);
  for I := 0 to High(T.Cells) do
    if (T.Cells[I].RowIndex = Row) and (T.Cells[I].ColumnIndex >= 0) and
       (T.Cells[I].ColumnIndex < T.ColumnCount) then
      Parts[T.Cells[I].ColumnIndex] :=
        StringReplace(string(T.Cells[I].Text), #13#10, ' ', [rfReplaceAll]);
  Result := '';
  for I := 0 to High(Parts) do
  begin
    if I > 0 then
      Result := Result + #9;
    Result := Result + Parts[I];
  end;
end;

procedure ExportChains(const Tables: TPdfTables; const Folder: string);
var
  I, R, FirstRow: Integer;
  Header: string;
  Lines: TStringList;
begin
  Lines := TStringList.Create;
  try
    for I := 0 to High(Tables) do
    begin
      FirstRow := 0;
      if Tables[I].Continuation in [ptcNone, ptcStart] then
      begin
        Lines.Clear;
        Header := RowText(Tables[I], 0);
      end
      else if (Trim(Header) <> '') and (RowText(Tables[I], 0) = Header) then
        FirstRow := 1;                     // 表頭在這一頁重複了
      for R := FirstRow to Tables[I].RowCount - 1 do
        Lines.Add(RowText(Tables[I], R));
      if Tables[I].Continuation in [ptcNone, ptcEnd] then
        Lines.SaveToFile(Format('%s\table%d-page%d.tsv',
          [Folder, I, Tables[I].PageNumber]));
    end;
  finally
    Lines.Free;
  end;
end;
完全比對是正確選擇。文書處理器重複的表頭逐字元相符,模糊比對遲早吞掉一列長得像表頭的資料列。輸出裡多出一個表頭好發現;少了一列資料不好發現
量測頁尾區帶,而不是用猜的
ContinuationMargin 一個數字幹三份工作:第一道測試的頁緣寬容,以及第二道測試的頁尾區帶深度與頁首區帶深度。頁尾比區帶深時,它的上面一行留在內文區,前一個片段看起來像後面還跟著文字,鏈就在那頁斷掉。區帶設得太深則開始吞掉真內容:緊貼下邊界的簡短結尾行落進區帶,其上的表格就可能連到下一頁開場的任何東西
文件自己就能供給這個數字。TPdf.PageWordBoxes 回傳當前頁每個詞的頁面空間 Rect,其 Top 大於 Bottom,所以位於內文邊界之下的詞裡最高的 Top 就是頁尾深度。下面的探測取排版下邊界略低一點的值——一英吋頁取 70——並保留 36 點做為沒有頁尾文件的下限
// Reader-side helper (not part of the library): the highest word top
// BodyMargin 之下最高的文字上緣,也就是頁尾區的深度
function MeasureFooterDepth(Pdf: TPdf; BodyMargin: Double): Double;
var
  P, I: Integer;
  Words: TPdfWordBoxes;
begin
  Result := 0;
  for P := 1 to Pdf.PageCount do
  begin
    Pdf.PageNumber := P;
    Words := Pdf.PageWordBoxes;
    for I := 0 to High(Words) do
      if (Words[I].Rect.Bottom < BodyMargin) and
         (Words[I].Rect.Top > Result) then
        Result := Words[I].Rect.Top;
  end;
end;

// 需 uses System.Math 才有 Max
Options := TPdfTableExtractionOptions.Default;
Options.ContinuationMargin := Max(36.0, MeasureFooterDepth(Pdf, 70) + 2);
Tables := Pdf.ExtractDocumentTables(Options);
兩條區帶深度相同,所以深的每頁頁首也對頁頂量一次,取較大值。寬容維持在兩三點內;每多一點,內容感知測試就少看見一點內文
有一種版面天性上就擊敗標題規則:產生器把合併的「續表」橫幅寫成每個接續片段的首列。這種片段個個被回報為新表格,所以請在自己的程式碼裡,按連續頁碼、相等的 ColumnCount 與第 0 列的橫幅文字自行連結
接續標記、標題規則與單列例外全部運行在 ExtractDocumentTables 之內,在 Delphi、C++Builder 與 Lazarus 版本上行為一致。完整的表格擷取選項列在 PDFium Component for Delphi 產品頁