一份雙欄會議論文按垂直位置排序,回傳的第一行是 Abstract We measure the 2 Related work Earlier studies:左欄的開頭幾個字接上右欄的開頭幾個字,只因為兩者坐在同一條基準線上。剖析器沒有出錯。PDF 頁面對自己的文字提供兩種都站得住腳的順序——內容串流的繪製順序,與每個字形在頁面上的位置——而對不少版面,這兩個順序互相矛盾。擷取器若回傳帶位置的區塊而非一整條字串,你就能看清拿到的是哪種順序,並在它與眼前頁面不合時切換
GetStructuredText 回傳什麼
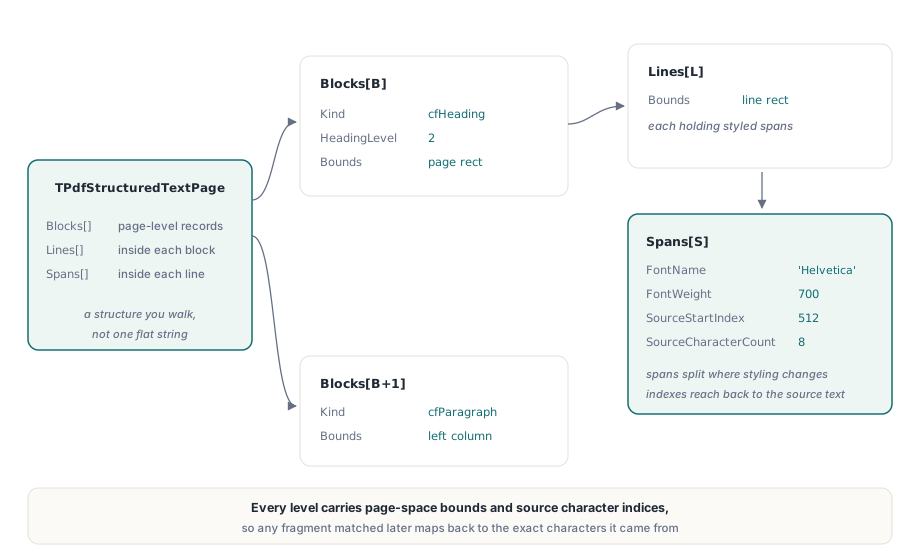
PDFium Component 的 TPdf.GetStructuredText 為當前頁回傳一個 TPdfStructuredTextPage:區塊陣列,每個區塊是行陣列,每行是帶樣式片段陣列。每一層都帶自己的 Text 與一個以 PDF 點計的頁面空間 Bounds 矩形,標題、單行或粗體片語因此不必二次查找就能定位在頁面上。頁面記錄另加 Width、Height、CharacterCount 與兩個品質計數器,後面再談
壓平的 Page.Text 由區塊組裝而成,不是從原始字元流來的。區塊內的行以單一 CRLF 相接、區塊之間隔一個空行,所以把 Page.Text 直接印出來,就能看到擷取器畫下的區塊邊界在哪裡。頁面讀起來奇怪時,這是最快的一步檢查
這一切都由一個小小的選項記錄驅動。TPdfStructuredTextOptions.Default 把 ReadingOrder 設為 roPhysicalLayout、開啟 IncludeFontInfo 與 IncludeSemantics、並把 MaxCharacters 設為 1,000,000。改變輸出形狀最多的,就是閱讀順序那一欄
兩種閱讀順序怎麼建行與區塊
roContentOrder 保留生產器的繪製順序,roPhysicalLayout 從字形位置重建順序,差別最先顯現在行的組成方式。內容順序裡,字元按頁面繪製的次序取用。遇到明確換行、或下一個字元不再與當前行垂直重疊時,開新的一行。一行要併入它正前面的區塊,必須兩者水平重疊至少較窄寬度的五分之一、且垂直間距不超過約兩又四分之一個行高;否則開新區塊。區塊維持繪製順序
實體版面把繪製順序整個丟掉。每個有已知盒的字元先按盒的垂直中心排序、頁首優先,再按左緣。垂直範圍重疊足夠的字元共享一行,這個判準只看高度,水平距離完全不參與。每一行再按同一套重疊與間距規則,併入頁面上任何位置最適合它的既有區塊;完成的區塊按上緣排序,半點以內的平手由左緣裁定
開頭那個例子正是第二條規則的產物。論文的兩欄共用基準線網格時,左欄第一行與右欄第一行垂直重疊,實體版面便把它們放上同一行。欄間溝的空隙比四分之一個字型大小寬,擷取器插入一個空格、繼續前進。正文的每一行都如法炮製,合併的行彼此水平重疊,整個雙欄正文於是變成一個橫跨欄間溝直讀過去的超寬區塊
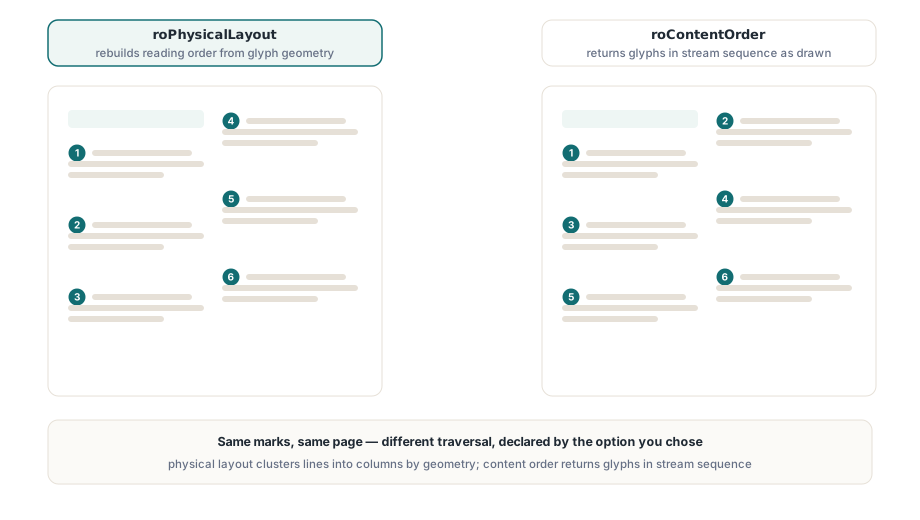
只要生產器先寫第一欄、再寫第二欄——文書處理器與排版系統的正常做法——內容順序就能把這種頁面處理得很好。左欄的行疊成區塊,右欄第一行與它們沒有水平重疊、自開新區塊,區塊按作者書寫的順序出來。實體版面則在另一類頁面上掙得一席:發票、對帳單、表單與投影片,標籤與它的值坐在同一條基準線上,由左至右讀一整列正是你要的。繪製順序毫無意義時——比如按字型逐段繪製的文字、或由許多小覆蓋層拼裝的頁面——也該用這個模式
混合式的收藏,按文件類型分流。來自已知製作工具的文章、報告與手冊走 roContentOrder;表單與交易單據維持 roPhysicalLayout 預設。下面的常式以內容順序印出一頁的區塊,檔案有標記時順帶標出標題
uses
  SysUtils, PDFium;

procedure DumpBlocks(Pdf: TPdf; PageNumber: Integer);
var
  Options: TPdfStructuredTextOptions;
  Page: TPdfStructuredTextPage;
  B, L: Integer;
begin
  Pdf.PageNumber := PageNumber;                 // 1-based
  Options := TPdfStructuredTextOptions.Default;
  Options.ReadingOrder := roContentOrder;      // 按欄寫出的生產器

  Page := Pdf.GetStructuredText(Options);
  if Page.Source = rosStructure then
    Writeln('block kinds come from the structure tree')
  else
    Writeln('block kinds are inferred from layout');

  for B := 0 to High(Page.Blocks) do
  begin
    if Page.Blocks[B].Kind = cfHeading then
      Writeln(Format('[%d] H%d  %s',
        [B, Page.Blocks[B].HeadingLevel, Page.Blocks[B].Text]))
    else
    begin
      Writeln(Format('[%d] x=%.0f..%.0f, %d line(s)',
        [B, Page.Blocks[B].Bounds.Left, Page.Blocks[B].Bounds.Right,
         Length(Page.Blocks[B].Lines)]));
      for L := 0 to High(Page.Blocks[B].Lines) do
        Writeln('      ', Page.Blocks[B].Lines[L].Text);
    end;
  end;
end;
怎麼偵測橫跨欄間溝的一行?
合併的行會從它的片段露出馬腳。只要下一個字元不是它在頁面原始字元序列裡的直接後繼,GetStructuredText 就開新的片段——這是除了下面講的樣式變化之外的另一個切分點。同一欄之內,連續的詞在來源裡通常也連續。合併行的欄間溝處,來源索引一口氣跳過幾百個字元,兩個片段之間的水平空隙也遠比任何詞間空格寬
這兩個訊號合起來是可靠的測試,而且可以在預設輸出上先跑一遍,再決定頁面是否該改用內容順序。GetStructuredText 讀取的字元資料快照按頁快取、預設八頁,所以對同一頁換一個 ReadingOrder 再要一次,是對記憶體裡已有的資料重新分組,不用再擷取頁面
// LineCrossesGutter 是你自己加的輔助函式:標記一行裡有兩個
// 相鄰片段在頁面上相距很遠、
// 在來源字元序列裡也不相鄰
function LineCrossesGutter(const Line: TPdfStructuredTextLine;
  MinGap: Double): Boolean;
var
  S: Integer;
  Prev, Cur: TPdfStructuredTextSpan;
begin
  Result := False;
  for S := 1 to High(Line.Spans) do
  begin
    Prev := Line.Spans[S - 1];
    Cur := Line.Spans[S];
    if (Prev.SourceStartIndex < 0) or (Cur.SourceStartIndex < 0) then
      Continue;                                 // 替代文字區塊
    if (Cur.Bounds.Left - Prev.Bounds.Right > MinGap) and
       (Cur.SourceStartIndex <>
        Prev.SourceStartIndex + Prev.SourceCharacterCount) then
      Exit(True);
  end;
end;

function ExtractWithFallback(Pdf: TPdf): TPdfStructuredTextPage;
var
  Options: TPdfStructuredTextOptions;
  B, L, Lines, Crossing: Integer;
begin
  Options := TPdfStructuredTextOptions.Default;   // roPhysicalLayout
  Result := Pdf.GetStructuredText(Options);

  Lines := 0;
  Crossing := 0;
  for B := 0 to High(Result.Blocks) do
    for L := 0 to High(Result.Blocks[B].Lines) do
    begin
      Inc(Lines);
      if LineCrossesGutter(Result.Blocks[B].Lines[L], 18) then
        Inc(Crossing);
    end;

  // 四分之一的行跨過空隙,看起來是欄,不是表單列
  if (Lines > 0) and (Crossing * 4 >= Lines) then
  begin
    Options.ReadingOrder := roContentOrder;
    Result := Pdf.GetStructuredText(Options);
  end;
end;
十八點是四分之一英吋,比正文的詞間空格寬得多、又比多數欄間溝窄。四分之一門檻讓只有幾列標籤加金額的發票留在實體版面,而幾乎每行都跨溝的真雙欄正文則切換過去。若生產器按列橫跨兩欄地寫頁面,來源索引保持連續,測試永不觸發,兩種順序都幫你分不開欄;那種頁面需要可讀內容 API 的欄模式,見以跨欄標題閱讀雙欄一文
IncludeSemantics 改變什麼、放過什麼?
IncludeSemantics 給區塊貼標籤,不重排它們。選項開啟時,GetStructuredText 讀取頁面的可讀內容,按重疊面積最大者把片段的種類發給每個區塊。可用的種類有 cfParagraph、帶 HeadingLevel 的 cfHeading、cfListItem、cfTableCell、cfCaption、cfFigure、cfLink、代表其他任何標籤的 cfOther,以及什麼都沒對上時的 cfPlain。每個區塊還帶上一個 Language 與一個把它繫到結構樹元素的 StructElementIndex
Source 欄位說明標籤的來源:頁面有 ISO 32000-1 §14.7 意義上可用的結構樹時是 rosStructure,種類屬推斷時是 rosHeuristic。Page.Source 對整頁給出同一答案。以 rosStructure 回報的標題,是標題因為作者標了它;以 rosHeuristic 回報的是有根據的猜測,對標題加權的索引管線應該區別對待。兩種情況下,區塊順序仍出自 ReadingOrder。語意趟次用的是可讀內容的預設,所以經 ReadableContentOptions 施加的欄設定到不了 GetStructuredText
圖形多一條規則。有標記頁面上,沒有對上任何文字區塊的 Figure 元素或替代文字,會以自己的區塊附加在後,把替代描述當作文字。這種區塊只有一行、一個片段,且 SourceStartIndex 為 -1,因為頁面上沒有任何字形產生它。把片段對映回字元的程式碼必須跳過這個值,上面的欄間溝測試正是為此檢查它。結構樹檢查本身在PDF/UA 結構樹驗證一文
片段、邊界與回到字元的路
每個 TPdfStructuredTextSpan 帶自己的文字、邊界、FontName、FontSize、FontWeight 與 Angle,外加 SourceStartIndex 與 SourceCharacterCount。IncludeFontInfo 開啟時,四個樣式值任何一個變化處就是片段的邊界,所以中間帶三個粗體詞的句子會以三個片段抵達,強調可以從 FontWeight 重建、不必靠字型名稱猜。IncludeFontInfo 關閉時,樣式欄位留空,片段只在來源序列被中斷處切分
角度在帶印章的頁面上很重要。斜向的 DRAFT 浮水印與正文共用同一座標空間,實體版面裡它的字母可能垂直橫越正文行、因而落進正文行。把文字接起來做索引之前,非零 Angle 的片段很容易先剔除
兩個來源欄位是把搜尋命中變成可畫下之物的關鍵。它們對頁面的字元序列編索引,區塊裡找到的片語因此能直接換成字元方框、畫出高亮,做法見以字元方框做視覺文字行選取一文。目標是頁面的重排或 HTML 形態時,同一批區塊餵給重排模型與其 HTML 匯出
字元預算與兩個品質計數器
MaxCharacters 在頁面字元數超標時直接拒收。GetStructuredText 在配置任何工作陣列之前先檢查數量,超標頁面拋出帶 Structured text character budget exceeded 訊息的 EPdfError,永遠不會回傳半個頁面。該值必須為正。方法讀取的每頁字元快照另有自己的預設上限——100 萬字元與 10 萬個文字物件——以 Text snapshot budget exceeded 回報,所以把 MaxCharacters 設到一百萬以上也放不進更大的頁面
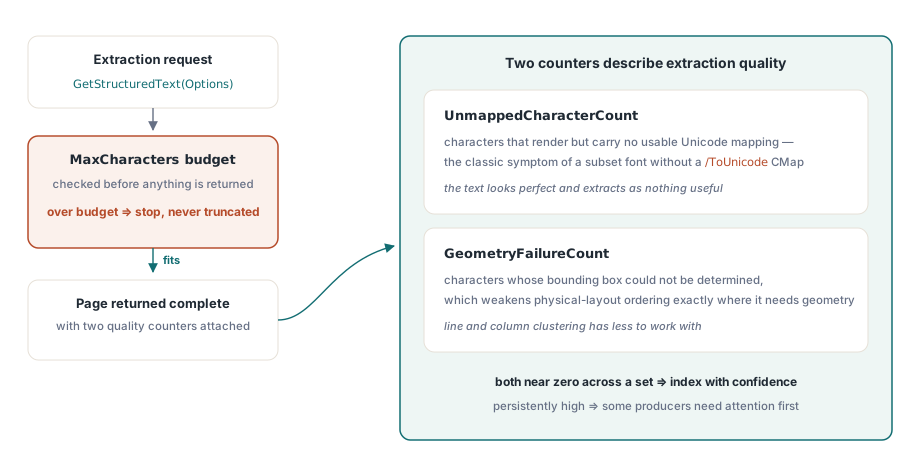
UnmappedCharacterCount 計數 PDFium 完全生不出 Unicode 值的字元。這些字元在每個 Text 欄位裡以 U+FFFD 出現。常見原因是帶自訂編碼、又沒有 /ToUnicode CMap 的子集字型——ISO 32000-1 §9.10.2 描述的情況:文字渲染正確、卻無法可靠擷取。這個計數器只量缺失的對映:/ToUnicode 項目指錯碼位的字形仍算已對映,所以一頁看起來煞有介事的亂碼照樣可以回報零
GeometryFailureCount 計數沒有可用方框的字元,換行不算在內。內容順序裡這些字元就跟在鄰居後面。實體版面裡它們沒有位置可排,於是被放到所有已定位字元之後、黏在頁面最底一行上。幾何計數非零、最後一行又出現奇怪片段的頁面,呈現的正是這件事
// LogRejected 與 LogQuality 是你自己的記錄常式
function ExtractForIndex(Pdf: TPdf; PageNumber: Integer;
  out Page: TPdfStructuredTextPage): Boolean;
var
  Options: TPdfStructuredTextOptions;
begin
  Result := False;
  Pdf.PageNumber := PageNumber;
  Options := TPdfStructuredTextOptions.Default;
  Options.MaxCharacters := 200000;              // 這條管線的接入上限
  try
    Page := Pdf.GetStructuredText(Options);
  except
    on E: EPdfError do
    begin
      LogRejected(PageNumber, E.Message);       // 字元或快照預算
      Exit;
    end;
  end;

  if Page.UnmappedCharacterCount * 20 > Page.CharacterCount then
    LogQuality(PageNumber, Format('%d of %d characters have no Unicode value',
      [Page.UnmappedCharacterCount, Page.CharacterCount]));
  if (Options.ReadingOrder = roPhysicalLayout) and
     (Page.GeometryFailureCount > 0) then
    LogQuality(PageNumber, Format('%d characters without a box; check the last line',
      [Page.GeometryFailureCount]));
  Result := True;
end;頁面只求一條字串的話,從 PDF 文件擷取文字一文講的是更簡單的呼叫,讀寫 BDC 與 MCID 標記內容一文則深入結構樹的下一層。結構化頁面模型、可讀內容讀取器與重排匯出,都裝在PDFium Component 產品頁所描述的 Delphi 與 Lazarus 元件裡