文字處理器匯出、當年「tagged PDF」勾選框沒打的合約,在螢幕上照樣有模有樣:24 點粗體標題、編號條款、一張劃好線的費用表。轉成可重排 HTML 之後,費用表回來是一個規規矩矩的 <table>,標題卻是一個與腳註地位完全相同的 <p>。這個輸出是正確的。ISO 32000-1 §14.8 只給 PDF 一個地方說「這段文字是標題」——結構樹——而未加標籤的檔案沒有這棵樹。字級與粗體是排版選擇;把每行大號粗體都升成 <h1> 的轉換器,也會把引言、表格合計與信頭裡的公司名一起升
所以任何 PDF 轉 HTML 管線都值得被問:輸出裡的每個標題、清單項、表格從哪裡來,手機排版、螢幕閱讀器或搜尋索引器各能信它到什麼程度。標題與表格給的答案不同。匯出這一步還要自己決定換行、字元編碼與記憶體
標題與清單從哪裡來
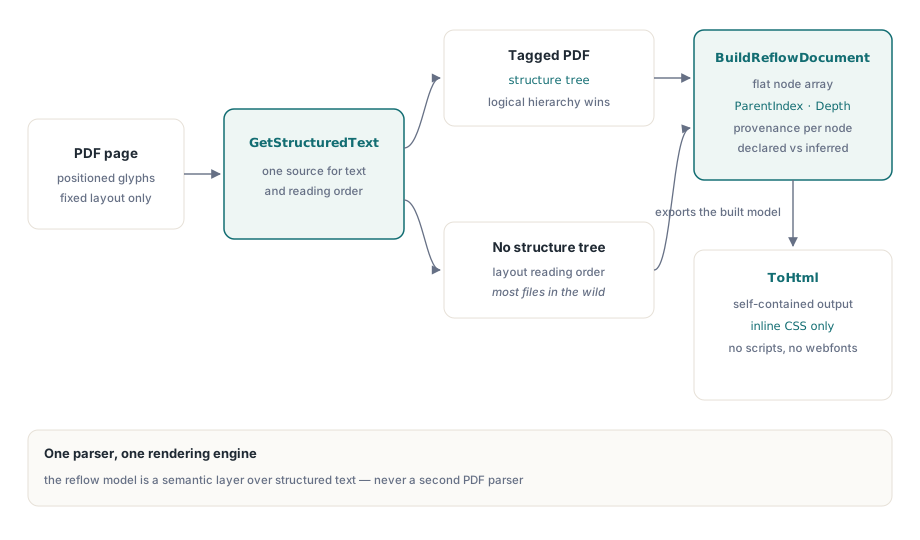
PDFium Component 用 TPdf.BuildReflowDocument 建重排模型,這個方法的每個字詞、區塊與語意提示都取自 GetStructuredText——與結構化文字區塊與閱讀順序描述的同一層結構化文字。背後沒有第二個解析器、也沒有第二個文字抽取器。請求範圍裡的每一頁,它按實體版面順序收集區塊;GetStructuredText 已經用重疊面積把每個區塊對上頁面的有標籤內容,BuildReflowDocument 把找到的角色抄到區塊上:H 到 H6 成為帶層級的標題,LI、Lbl、LBody 成為清單項,Figure 成為以替代描述為文字的圖形,Caption 成為題註
兩個後隨之而來,都很好觀察。區塊順序永遠跟著頁面版面走,有標籤的檔案也不例外——標籤決定區塊是什麼,幾何決定它去哪。沒有標籤的頁面上,每個區塊都是段落。標題與清單絕不靠字級去猜
每個節點帶一個 TPdfReadingOrderSource 型別的 Source 欄位:角色來自結構樹是 rosStructure,只從版面來是 rosHeuristic。匯出的 HTML 在每個元素上把它重複為 data-source="structure" 或 data-source="inferred";文件層級的 TPdfReflowDocument.Source 只有在範圍內每頁都有標籤時才是 rosStructure。表格永遠是 rosHeuristic,因為它們出自幾何偵測而不是 Table 標籤。下游若把標題當導航地標,先查這個欄位——有標籤的文件給你作者選定的地標
扁平節點陣列,而非物件樹
TPdfReflowDocument.Nodes 是前序攤平的樹:一個 TPdfReflowNode 記錄的動態陣列,每筆帶 ParentIndex 與 Depth。頁面節點在深度 0、父索引 -1。段落、標題、圖形、題註、清單與表格掛在深度 1 的頁面下;清單項在深度 2、屬於自己的清單;表格儲存格最深到深度 3、掛在列下。相鄰的清單項共用一個清單節點;任何其他區塊或表格插進來,就另起新清單
扁平版面是個可移植性決策。「包含自己的動態陣列的遞迴記錄」在 Delphi、C++Builder、Free Pascal 都編得過,但跨套件或 DLL 邊界時,三者對遞迴受管型別的處理不同。樸素記錄的扁平陣列在三者行為一致,還能用一個 for 迴圈、不遞迴地串流
uses
  SysUtils, PDFium;

var
  Pdf: TPdf;
  Options: TPdfReflowOptions;
  Doc: TPdfReflowDocument;
  Node: TPdfReflowNode;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'contract.pdf';
    Pdf.LoadDocument;

    Options := TPdfReflowOptions.Default;   // 全部頁面、開表格、開 CSS
    Doc := Pdf.BuildReflowDocument(Options);

    for I := 0 to High(Doc.Nodes) do
    begin
      Node := Doc.Nodes[I];
      case Node.Kind of
        prnkHeading:
          Writeln(Format('%sH%d [%s] %s', [StringOfChar(' ', Node.Depth * 2),
            Node.HeadingLevel,
            BoolToStr(Node.Source = rosStructure, True), Node.Text]));
        prnkTable:
          // 在表格節點上,RowSpan/ColumnSpan 存的是表格的列數與欄數
          Writeln(Format('%stable %dx%d, page %d, confidence %.2f',
            [StringOfChar(' ', Node.Depth * 2), Node.RowSpan, Node.ColumnSpan,
             Node.PageNumber, Node.Confidence]));
      end;
    end;

    Writeln(Format('%d node(s), %d table(s), %d character(s), pages %d-%d',
      [Length(Doc.Nodes), Doc.TableCount, Doc.CharacterCount,
       Doc.FirstPage, Doc.LastPage]));
  finally
    Pdf.Free;
  end;
end;
拿開場那份未加標籤的合約跑,那個迴圈一行 H 都不印,每個偵測到的費用表印一行 table。同一份文件的有標籤副本上跑,標題出現、後面跟著 True。選項裡的 FirstPage 與 LastPage 預設 0,意味文件首頁與末頁;超出頁數的範圍在任何頁被讀之前丟 EPdfError
表格文字為什麼不會出現兩次?
表格偵測在結構化文字收集完之後、逐頁執行,也就是說表格裡的字存在兩份:一份是文字區塊,一份是儲存格。兩份都輸出,HTML 裡每個表格後面就跟著自己的內容再當一遍散段落——「把表格加進文字裡」的天真合併產出的正是這個
模型用幾何解決它:邊界框至少一半落在偵測到的表格界內的文字區塊被丟棄,表格節點頂上。表格再按垂直位置與剩餘區塊交錯(頁面上較高者先,頂邊相差不足半點時以左到右決勝),表格於是落在上方段落下、下方段落前,而不是被綁在頁尾
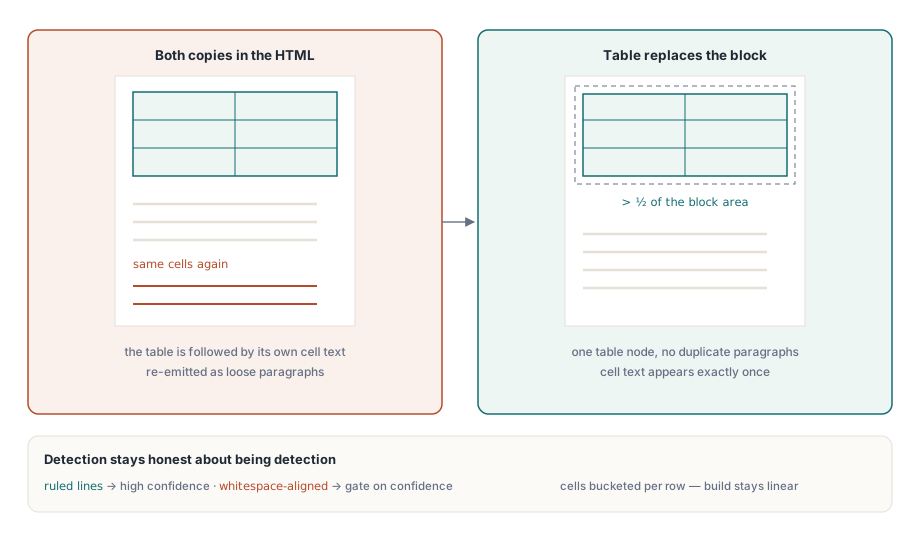
半面積門檻有條看得見的邊。橫跨表格邊界、大半在外面的區塊原樣存活,所以偶爾會有一行字同時出現在最後一列和下一段裡。這是該偏的那一側。門檻低到清光所有重疊區塊,也會刪掉只是碰到表格邊界框的正文;多出來的一行遠比缺掉的一句容易察覺、容易被原諒
偵測到的表格還帶信心值,兩種偵測策略落在不同區間:從框線找到的表格得分 0.88 到 1.0,視多少儲存格真有文字而定;純靠留白對齊推斷的表格得分 0.58 到 0.88。表格節點的 Confidence 存這個分數,每個儲存格節點重複它,HTML 把它寫成 <table> 元素上的 data-confidence。低於 TableOptions.MinConfidence(預設 0.5)的表格根本不會被建出來;表格被拒時,那些字就留在模型裡當普通段落
給搜尋索引或手機閱讀視圖用,錯一個表格代價很小、偵測對了收穫很大——維持預設即可。做歸檔轉換,在兩欄地址區塊外硬造出一圈網格比沒有網格更糟,那就把偵測限縮到有框線的表格:
Options := TPdfReflowOptions.Default;
Options.DetectTables := True;
Options.TableOptions.DetectWhitespaceTables := False; // 只收有框線的表格
Options.TableOptions.MinConfidence := 0.9;            // 稀疏的框線網格也丟掉
Options.TableOptions.MaxTables := 200;                // 全文件上限
Options.TableOptions.MaxCells := 50000;               // 全文件上限

Doc := Pdf.BuildReflowDocument(Options);
if Doc.TableCount = 0 then
Writeln('No ruled tables; all page text is emitted as paragraphs');一次重排建構裡,MaxTables 與 MaxCells 是整個頁面範圍合計,不按頁計。三百頁、每頁一張框線表格的對帳單,MaxTables 至少要 300,否則建構在第一張超限表格處以 EPdfError 停手。預設是 1000 張表格、100000 個儲存格
偵測本身——包括畫成邊框的細長實心矩形與跨頁續表——見表格偵測與抽取
匯出什麼都不缺的 HTML
TPdfReflowDocument.ToHtml 走訪已建好的模型,不再碰 PDFium,同一個模型匯出兩次得到同一個字串。FullDocument 開著(預設)時,結果是完整頁面:doctype、<meta charset="utf-8">、viewport meta、取自文件 Title 條目的 <title>(空則「PDF document」),以及來自文件語言的 lang 屬性。FullDocument 關掉,得到一個 <div class="pdf-reflow"> 片段,丟進你自己的模板
IncludeCss 帶來的選用樣式表是一個內嵌 <style> 區塊:72rem 的閱讀欄、IncludePageSections 開啟時每個 PDF 頁面一張白卡、收攏的表格邊框,以及 40rem 以下去掉卡片內距、縮小表格文字的 media query。沒有腳本、沒有網頁字型、沒有外部 URL——檔案因此能躺進電子郵件、CHM 式說明檢視器或沙箱化的瀏覽器控制項。1 到 6 以外的標題層級寫成 h2,表頭儲存格變 th,RowSpan 或 ColumnSpan 大於 1 的儲存格加上 rowspan 與 colspan。打開 IncludeGeometry 會加 data-left、data-top、data-right、data-bottom(PDF 點),想在渲染頁面上把搜尋命中高亮回來時很好用
PreserveLineBreaks 值得一個深思熟慮的選擇。PDF 段落裡的換行是為某個固定欄寬做的;帶上 360 像素的螢幕,每一行都折兩次——重排的存在正是為了消滅這種鋸齒。散文請關著(預設)。換行承載意義的文件——地址、詩句、程式碼清單——再開,它會寫 <br> 而不是空格
長文件把整個頁面建成一個 WString 再編碼,記憶體峰值翻倍。WriteHtml 改把同樣的標記串流進 TPdfReportWriter,以 ASCII 寫出、每個非 ASCII 字元寫成數字字元參照,接收端怎麼猜編碼,位元組都合法:
uses
  Classes, SysUtils, PDFium, FPdfAsync, FPdfReport;

procedure ExportReflowHtml(Pdf: TPdf; const FileName: string;
  const Token: IPdfCancellationToken);
var
  Options: TPdfReflowOptions;
  Doc: TPdfReflowDocument;
  Limits: TPdfReportLimits;
  Stream: TFileStream;
  Writer: TPdfReportWriter;
begin
  Options := TPdfReflowOptions.Default;
  Options.MaxNodes := 500000;
  Options.MaxCharacters := 20000000;
  Doc := Pdf.BuildReflowDocument(Options, Token);   // 頁面狀態事後會還原

  Limits := TPdfReportLimits.Default;
  Limits.MaxCharacters := 64 * 1024 * 1024;  // 輸出位元組上限,最大 64 MiB
  Limits.MaxItems := Options.MaxNodes;       // 每節點一個 item,最大 1048576

  Stream := TFileStream.Create(FileName, fmCreate);
  try
    Writer := TPdfReportWriter.Create(Limits, Stream);  // 串流仍歸呼叫者所有
    try
      Doc.WriteHtml(Writer);
    finally
      Writer.Free;
    end;
  finally
    Stream.Free;
  end;
end;
WriteHtml 查得比 ToHtml 嚴:拒絕節點數超過 Options.MaxNodes 的模型、對寫出的文字執行 Options.MaxCharacters、巢狀限於 MaxDepth 參數(預設 64),並驗證每個 ParentIndex 都指向更早的節點。最後這條在你於匯出前過濾或改寫 Nodes 時最要緊:帶前向父索引的編輯過陣列會丟 EPdfReportLimit,而不是產出標籤錯配的標記
預算、取消與現用頁面
PDF 是不受信任的輸入,畸形或懷有惡意的檔案可以宣告幾千頁蠅頭小字。BuildReflowDocument 在每個節點加入之前檢查字元、節點、表格與儲存格預算,超標的檔案以 EPdfError 停手、訊息點名是哪個預算(例如「Reflow node budget exceeded」),記憶體用量的界限始終在。MaxCharacters 與 MaxNodes 都必須為正;預設 10,000,000 字元、1,000,000 節點
選用的 IPdfCancellationToken 在每頁之前、區塊之間、每個表格與每個表格列之前被檢查。把表單擁有的 TPdfCancellationTokenSource 的 Token 傳進去、按鈕 handler 裡呼叫 Cancel,建構就在下一個檢查點丟 EPdfOperationCancelled。把它與 EPdfError 分開接住,使用者的取消才不會被記成檔案損壞。建構無論以哪個例外收場,都不回傳半成品;若失敗發生在 WriteHtml 裡較深處,目的地檔案會躺著一份截斷的頁面——在你自己的例外 handler 裡刪掉它
頁面狀態是 GUI 程式碼仰賴的細節。建構靠移動 PageNumber 走訪範圍內每一頁,try/finally 在成功、預算失敗與取消三種情況下都把呼叫者的頁面放回去。使用者在讀第 340 頁時啟動匯出的檢視器,匯出回來時還停在 340
重排適合的位置
重排輸出很適合當搜尋索引、無障礙閱讀視圖、手機顯示與內容遷入 CMS 的輸入。它刻意丟掉絕對定位、精確字型、向量圖稿與頁面幾何——選用的 data-* 座標除外。工作需要頁面長得一模一樣,就渲染;需要文字在別處可讀,就重排
標題與清單只出自標籤,HTML 的品質因此追著上游標記品質走。通過PDF/UA 結構樹驗證各項檢查的文件,產出的模型帶真正的標題層級;同一批有標籤內容也驅動打造無障礙閱讀器裡的閱讀功能
重排、結構化文字、表格抽取與渲染都跑在同一個 TPdf 物件上,Delphi、C++Builder 與 Lazarus 皆然;選項記錄、例外與報告寫入器都記錄在PDFium Component for Delphi 產品頁