PDFium Component 的表格抽取從 3.117.0 版起,把細長的填色矩形視為表格框線。啟用 DetectFilledRulings(這是預設值)之後,一個厚度不超過 MaxRulingThickness(3 點)、軸向對齊的填色盒,會變成長軸方向上的一條框線;更大的填色盒則貢獻它的四條邊;而在組出網格之前,每一個框線座標都會在 RulingSnapTolerance(4 點)之內被對齊。因此從 Word、Google Docs 與瀏覽器匯出的表格,會以完整網格的姿態到達有框線偵測器,而不是當成碎片掉進空白偵測
先前那篇表格偵測與抽取說,有框線偵測用的是畫出來的線,而且每一段描邊路徑都會轉換成頁面座標。那句話是真的,但不完整。在一組 13 份真實樣本文件上數路徑物件,發現其中 9 份完全不含任何描邊路徑,但它們的每一頁都帶著幾百個 0.5 到 1 點厚的填色矩形。只看描邊的偵測器什麼都看不到,每一頁都掉進空白偵測,輸出就是一堆散落的小碎片,而不是表格。3.116.4 加入的窄欄預設集在碎片層級上緩和了這件事;但根本原因是偵測器讀錯了繪製運算子
為什麼 Word 匯出的表格沒有描邊線?
文書處理器不把框線想成一條線;它想成一個有寬度的盒子,然後用填色把那個盒子塗出來。ISO 32000-1 §8.5.2.1 定義 re 運算子是附加一段矩形子路徑,而 §8.5.3 把繪製運算子分開:S 以當前的線寬描邊路徑,f 填滿它的內部。一條 0.5 點的儲存格框線出來就是 x y w 0.5 re f,而描邊那一整套機制——線寬、接合與虛線樣式——從頭到尾沒跑過。儲存格底紋是同樣的構造,只是盒子更大。用 m、l 與 S 畫出來的描邊網格,才是原本那個偵測器預期的東西,而那也幾乎是辦公應用程式匯出時不會產生的東西:
% 一個文書處理器匯出的儲存格框線:一個 0.5 點高的填色盒
72 700 468 0.5 re f
% 儲存格底紋:一個跟儲存格一樣大的填色盒
72 676 117 24 re f
% 原本那個偵測器所針對的描邊網格線
72 700 m 540 700 l S
對一個只用 FPDFPath_GetDrawMode 問描邊旗標有沒有設起的偵測器來說,兩個填色盒都是隱形的。接著,儲存格裡的文字就進了空白偵測,而那裡由 6 點間隙隔開的欄位落在預設 MinColumnGap 的 12 點之下,回來的結果只是碰巧對齊得足以通過 MinRows 的那個列子集。這就是碎片行為,而再怎麼調參數也變不出原作者畫的那個網格
PDFium Component 怎麼把一個填色盒變成框線?
TableCollectObjectRulings 一次檢查一條子路徑地看過每一個路徑物件。繪製模式來自 FPDFPath_GetDrawMode;當 DetectFilledRulings 打開、而且填色模式不是 none 時,該路徑就算填色。每個點都會經過物件矩陣轉換後被收集起來,每條子路徑最多 MaxSubpathPoints(8)個點,而任何曲線段都會把該子路徑標成彎曲的。當子路徑收合、或有新的 MoveTo 開始時,FlushSubpath 會判定它是什麼:彎曲的子路徑被丟掉,任何封閉多邊形只要它的點沒有全部落在至少一個軸向上距邊界框邊緣 PointTolerance(0.05 點)以內,也一樣被丟掉。三角形、箭頭形或圓角標籤永遠不會變成框線,這正是把裝飾性圖形擋在網格之外的原因
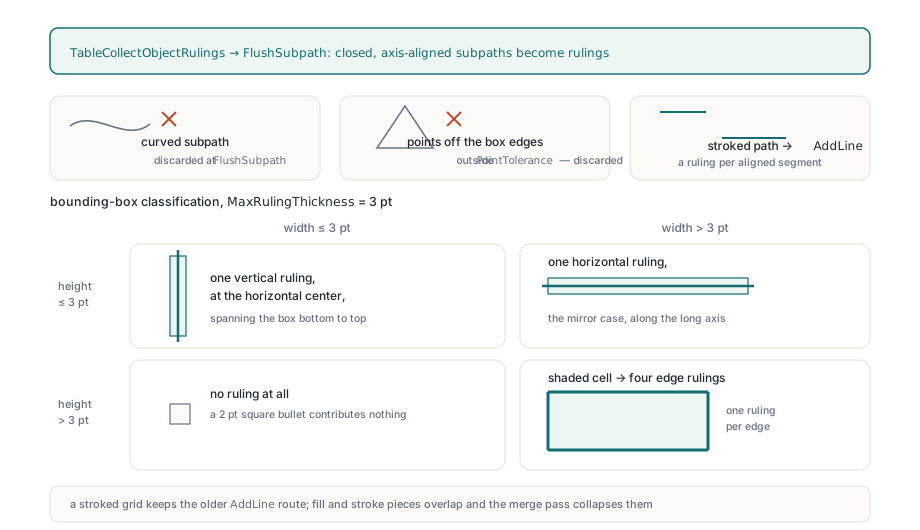
存活下來的是軸向對齊的矩形,再由它的邊界框分類。寬度在 MaxRulingThickness 以內、高度超過它,就在水平中心產生一條垂直框線,由盒底貫穿到盒頂;反過來的情況產生一條水平框線。兩個維度都超過門檻,代表這是一個填色儲存格,盒子貢獻四條框線,每條邊一條。兩個維度都在門檻以內則什麼都不貢獻,所以一個 2 點的方形項目符號不會被誤認成線。描邊路徑走的是 AddLine 那條舊路,每個軸向對齊的線段一條框線,所以用 S 畫的網格處理方式跟以前完全一樣;而同時填色又描邊的路徑會產生互相重疊的碎片,由合併那一趟收掉:
uses
  PDFium;

var
  Pdf: TPdf;
  Options: TPdfTableExtractionOptions;
  Tables: TPdfTables;
  Mode: string;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'itinerary-from-word.pdf';
    Pdf.LoadDocument;
    Pdf.PageNumber := 1;                     // 從 1 起算

    Options := TPdfTableExtractionOptions.Default;
    // 這些是 3.117.0 的預設值,寫出來只是為了清楚
    Options.DetectFilledRulings := True;     // 細填色盒變成框線
    Options.MaxRulingThickness := 3.0;       // 點;更厚的盒算底紋
    Options.RulingSnapTolerance := 4.0;      // 點;0 表示關閉對齊
    Options.IncludeFormXObjects := True;

    Tables := Pdf.ExtractTables(Options);
    for I := 0 to High(Tables) do
    begin
      if Tables[I].DetectionMode = ptdmRuled then
        Mode := 'ruled'
      else
        Mode := 'whitespace';
      Writeln(Format('%dx%d %s, confidence %.2f',
        [Tables[I].RowCount, Tables[I].ColumnCount, Mode,
         Tables[I].Confidence]));
    end;
  finally
    Pdf.Free;
  end;
end;
RulingSnapTolerance 對填色儲存格構成的表格做了什麼?
RulingSnapTolerance 就是讓一張純靠底紋構成的表格連成單一網格的東西。有些匯出檔根本不畫框線:每一格都是自己顏色的填色盒,相鄰盒子之間隔著 1 到 3 點的白色間隙。每個盒子產生四條邊框線,但這一格的右緣與下一格的左緣相距 2 點,而連通性測試用的 RulingTolerance 預設是 1 點。不對齊的話,每一格自成一個由四條框線構成的連通分量,沒有任何分量達到 MinRows,該頁就什麼都不回報。TableSnapRulings 把所有會用到的 X 座標(每一條垂直框線的位置,加上每一條水平框線的起點與終點)以及所有 Y 座標照樣收集起來,各自排序,把相鄰差距不超過容差的值串成叢集,以平均值取代每個叢集,然後把每一個位置、起點與終點移到最近的叢集中心。間隙的兩側變成同一條線,連通性就成立了
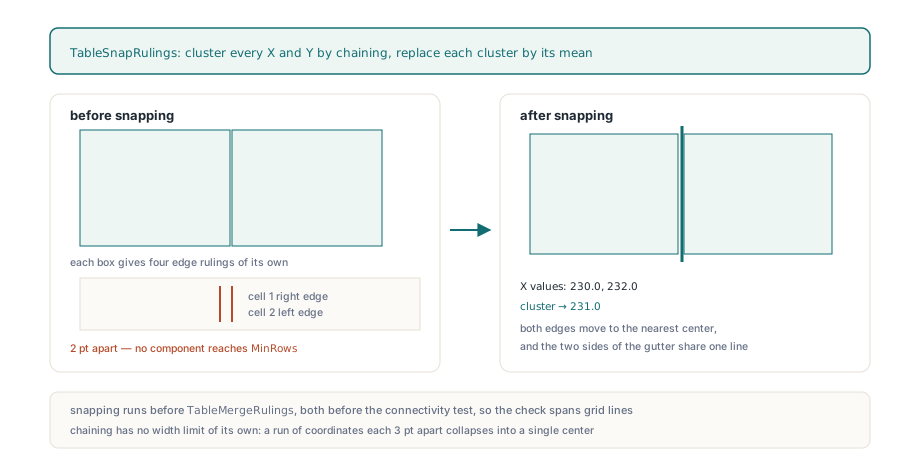
對齊在 TableMergeRulings 之前跑,後者會把框線排序,並把在 RulingTolerance 之內相接或重疊的共線片段接起來;兩者都在 TableDetectRuled 看到資料之前就跑完,所以成對連通性檢查的代價與格線數量成正比,而不是與每格碎片數量成正比。在描邊網格上這兩趟無害,因為本來就相同的座標會對齊到自己。唯一要記住的是:串鏈式叢集本身沒有寬度上限——一串彼此相距 3 點的座標會塌縮成單一中心。在 4 點的預設值下,這只影響比一個字元還窄的欄位,但如果某份文件真的有必須分開的 3 點間隙,就把容差調低,或設成 0 關掉對齊:
// 把有框線策略單獨隔出來,比較每種設定在同一頁上看到什麼
function CountRuledTables(Pdf: TPdf; FilledRulings: Boolean;
  SnapTolerance: Double): Integer;
var
  Options: TPdfTableExtractionOptions;
begin
  Options := TPdfTableExtractionOptions.Default;
  Options.DetectWhitespaceTables := False;
  Options.DetectFilledRulings := FilledRulings;
  Options.RulingSnapTolerance := SnapTolerance;
  Result := Length(Pdf.ExtractTables(Options));
end;

// 一份 Word 匯出檔通常會回報 0、N,然後比 N 少:
// 只看描邊什麼都看不到,對齊把填色儲存格連起來,
// 而關掉對齊會讓每一格填色儲存格各自成為孤島
Writeln(CountRuledTables(Pdf, False, 4.0));
Writeln(CountRuledTables(Pdf, True, 4.0));
Writeln(CountRuledTables(Pdf, True, 0.0));
form XObject 裡的框線
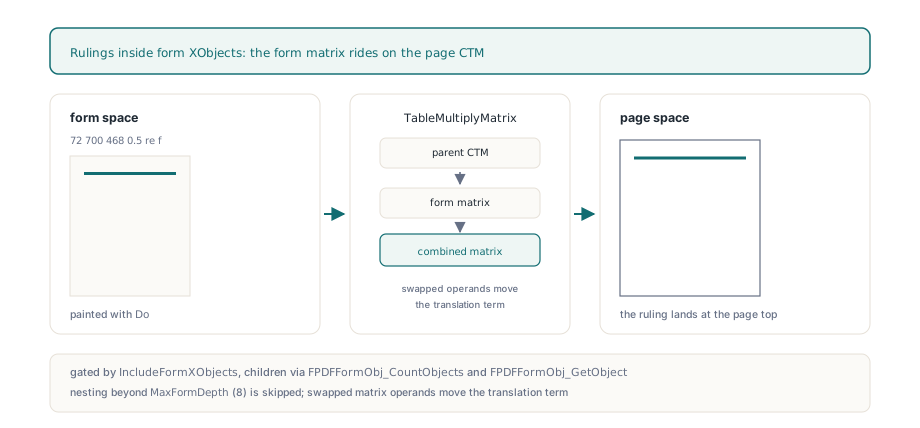
頁面排版工具經常把一張表格、或整頁的內容包進一個 form XObject,再用 Do 繪製它。ISO 32000-1 §8.10.1 規定,繪製 form 時 form 矩陣會與當前轉換矩陣串接,所以 form 裡的矩形住在 form 空間,要經過兩道以上轉換才會落到頁面上。TableCollectObjectRulings 在 IncludeFormXObjects 設定時會遞迴進 form 物件:它讀出物件矩陣,透過 TableMultiplyMatrix 與父矩陣結合——這個函式的參數順序意思是「先經第一個矩陣映射,再經第二個」——並用 FPDFFormObj_CountObjects 與 FPDFFormObj_GetObject 列舉子物件,把結合後的矩陣往下傳。巢狀深度超過 MaxFormDepth(8)會被默默跳過,那是對病態檔案的防護,不是任何真實匯出檔會碰到的上限。乘法順序之所以要緊,理由跟矩陣前置與後置一文談的相同:把運算元對調會移動平移項,一條該落在頁面頂端的框線會落到原點去
為什麼框線預算變成四倍?
預設的 MaxRulingSegments 在 3.117.0 從 4096 升到 16384,因為逐格框線的數量遠遠多於描邊格線。一張描邊的 30 列 6 欄表格是 38 個線段。同樣一張表格以填色盒匯出,每格最多四條框線,合併前是 720 個碎片,而一份帶填色儲存格的表單還要再翻一倍。一頁裡有兩張這樣的表格,就會把舊預算用光。這個預算在 TableAppendRuling 裡透過 Check 強制執行,後者會丟出帶著 "Table ruling-segment budget exceeded" 訊息的 EPdfError;沒有降級結果、沒有部分網格,空白那一趟也不會跑。如果您為不受信任的輸入自己設了更緊的預算,請接住例外再決定,而不是把空結果當成「沒有表格」來讀:
Options := TPdfTableExtractionOptions.Default;
Options.MaxRulingSegments := 2048;        // 對不受信任的輸入刻意設緊
try
  Tables := Pdf.ExtractTables(Options);
except
  on E: EPdfError do
  begin
    Log(E.Message);                       // 'Table ruling-segment budget exceeded'
    Options.MaxRulingSegments := 16384;   // 3.117.0 的預設值
    Tables := Pdf.ExtractTables(Options);
  end;
end;
量到的結果,以及這個做法停在哪裡
在同一組 13 份樣本文件上,抽取結果從 43 張表格(其中 9 張有框線、34 份是空白碎片或誤判),變成 41 張有框線表格、零筆空白誤判。那次的清理有一部分要歸功於 3.117.0 裡兩個配套改動:已經被有框線網格取用的文字,會在空白偵測開跑前移除,所以同一張表格永遠不會被回報兩次;而空白策略的欄界線現在必須是一條在被它分隔的每一列上都暢行無阻、不含文字的走廊,這才擋住了左右對齊的段落被算成 5x4 表格。把表格本身從碎片那一欄移到有框線那一欄的,則是填色矩形讀取器
界線值得直白講清楚。沒有文字層的頁面仍然會給出網格骨架,每一格都是空的,因為框線來自幾何、文字來自文字頁;掃描頁得先做 OCR。帶曲線、圓角或非矩形輪廓的填色圖形會被整個丟掉,所以框線畫成圓角矩形輪廓的表格,照舊得靠空白偵測。既沒有框線也沒有底紋的表格不受這一切影響,仍然是表格抽取一文所述空白策略的守備範圍;當連那樣都不夠時,結構化文字與閱讀順序給出的文字方框與區塊,就是為特定領域需求寫專用讀取器的原料。元件附的 TableExtractionLab 範例在它的選項面板裡公開了 DetectFilledRulings,要看某份匯出檔在有它與沒它時長什麼樣,那是最快的辦法;完整 API 說明在 PDFium Component for Delphi 產品頁