一份从文字处理器导出、导出时没勾"带标签 PDF"的合同,在屏幕上照样显得有结构:24 磅的粗体标题、编号条款、带横线的收费表。把它转成可重排 HTML,收费表回来了——是一个正经的 <table>;标题却是一个 <p>,与脚注地位完全相同。这个输出是对的。ISO 32000-1 §14.8 给 PDF 的唯一一处"这段文本是标题"的声明位置就是结构树,而无标签文件没有结构树。字号和加粗是排版选择,一个把每行大号粗体都变成 <h1> 的转换器,同样会把引言金句、表格合计和信头里的公司名一并升格
所以任何 PDF 转 HTML 管线都值得问一句:输出里的每个标题、列表项和表格从哪来,手机排版、屏幕阅读器或搜索索引各能信任它到什么程度。标题和表格给出的答案不同。导出这一步还要自己拿主意:换行、字符编码和内存
标题和列表从哪来
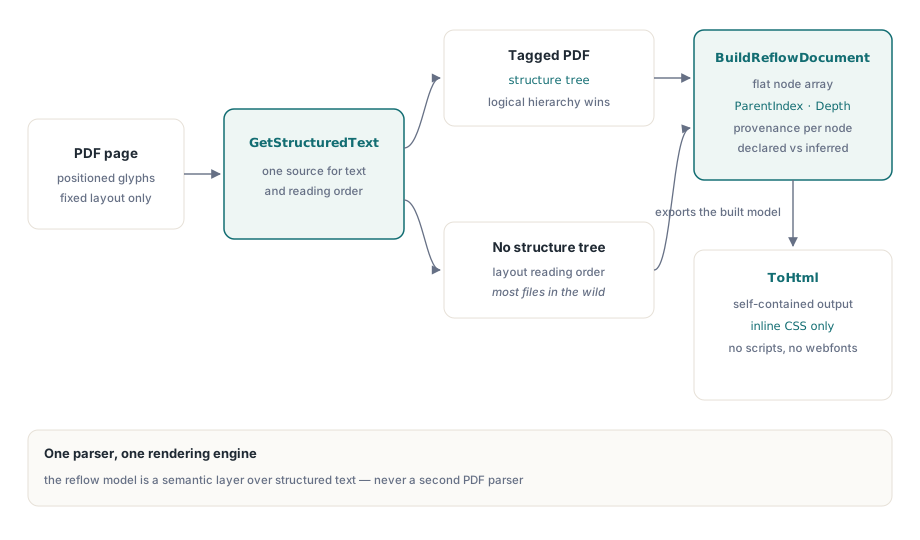
PDFium Component 用 TPdf.BuildReflowDocument 构建重排模型,这个方法从 GetStructuredText 取每一个词、块和语义提示——就是 结构化文本块与阅读顺序讲的那个结构化文本层。它背后没有第二个解析器,也没有第二个文本抽取器。对请求范围内的每一页,它按物理版面顺序收集块。GetStructuredText 已经按重叠面积把每个块与页面的带标签内容配对,BuildReflowDocument 把找到的角色复制到块上:H 到 H6 成为带级别的标题,LI、Lbl 和 LBody 成为列表项,Figure 成为文本取自替代描述的图形,Caption 成为图注
由此得到两个结论,都很容易观察到。即使文件带标签,块顺序也永远跟随页面版面——标签决定一个块是什么,几何决定它去哪里。而在没有标签的页面上,每个块都是段落。标题和列表绝不靠字号猜测
每个节点带一个 TPdfReadingOrderSource 类型的 Source 字段:角色来自结构树是 rosStructure,只来自版面是 rosHeuristic。导出的 HTML 在每个元素上重复它,写作 data-source="structure" 或 data-source="inferred";文档级 TPdfReflowDocument.Source 只有范围内每一页都带标签时才是 rosStructure。表格永远是 rosHeuristic,因为它们来自几何检测而非 Table 标签。如果下游步骤把标题当导航地标用,先检查这个字段——带标签的文档给你的是作者亲自选的地标
扁平节点数组,而不是对象树
TPdfReflowDocument.Nodes 是前序遍历压平的树:一个 TPdfReflowNode 记录的动态数组,每个记录带 ParentIndex 和 Depth。页面节点在深度 0、父索引 -1。段落、标题、图形、图注、列表和表格挂在页下深度 1,列表项在其列表下深度 2,表格单元格在行下深度 3。连续的列表项共享同一个列表节点;中间插入任何其他块或表格,就另起一个列表
扁平布局是可移植性决定。包含自身动态数组的递归记录在 Delphi、C++Builder 和 Free Pascal 下都能编译,但三者在跨包或 DLL 边界时对递归托管类型的处理各不相同。普通记录的扁平数组在三者中行为一致,而且可以用一个 for 循环、不带递归地流式处理
uses
  SysUtils, PDFium;

var
  Pdf: TPdf;
  Options: TPdfReflowOptions;
  Doc: TPdfReflowDocument;
  Node: TPdfReflowNode;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'contract.pdf';
    Pdf.LoadDocument;

    Options := TPdfReflowOptions.Default;   // 全部页面、开表格、开 CSS
    Doc := Pdf.BuildReflowDocument(Options);

    for I := 0 to High(Doc.Nodes) do
    begin
      Node := Doc.Nodes[I];
      case Node.Kind of
        prnkHeading:
          Writeln(Format('%sH%d [%s] %s', [StringOfChar(' ', Node.Depth * 2),
            Node.HeadingLevel,
            BoolToStr(Node.Source = rosStructure, True), Node.Text]));
        prnkTable:
          // 表格节点上 RowSpan/ColumnSpan 存的是表格的行数与列数
          Writeln(Format('%stable %dx%d, page %d, confidence %.2f',
            [StringOfChar(' ', Node.Depth * 2), Node.RowSpan, Node.ColumnSpan,
             Node.PageNumber, Node.Confidence]));
      end;
    end;

    Writeln(Format('%d node(s), %d table(s), %d character(s), pages %d-%d',
      [Length(Doc.Nodes), Doc.TableCount, Doc.CharacterCount,
       Doc.FirstPage, Doc.LastPage]));
  finally
    Pdf.Free;
  end;
end;
对开头那份无标签合同,这个循环一行 H 都不打印,每张检出的收费表打一行。对同一份文档的带标签副本运行,标题带着旁边的 True 出现。选项里的 FirstPage 和 LastPage 默认 0,表示文档第一页和最后一页;超出页数的范围在任何页面被读取之前抛 EPdfError
表格文本为什么不会出现两次?
表格检测在结构化文本收集完之后对每页运行,这意味着表格里的词存在两份:一份作为文本块,一份作为单元格。两者都输出,HTML 里每张表格后面就跟着一份以松散段落形式重复的自身内容——"把表格加到文本里"的天真合并产出的正是这个
模型用几何规则化解它。外接框至少有一半落在检出表格边界内的文本块被丢弃,表格节点取而代之。表格随后与剩下的块按垂直位置交织(页面上更高者在前,顶边相差不到半磅时以从左到右为次序),所以表格落在上方段落与下方段落之间,而不是被追加到页面末尾
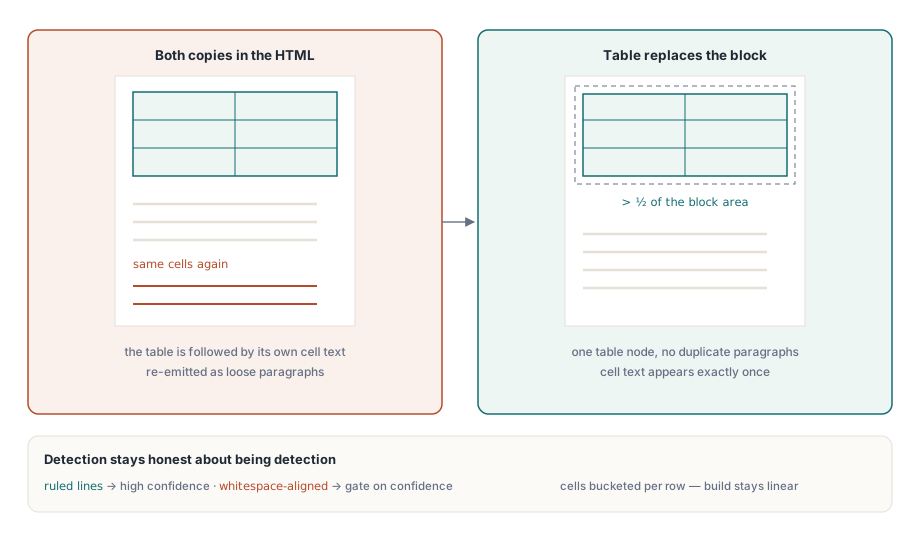
半面积阈值有一条可见的边界。横跨表格边界、大部分在外的块原样幸存,所以偶尔会有一行文字同时出现在最后一行和紧随其后的段落里。宁要这一侧的错误。把阈值压到足以移除所有重叠块,也会删掉只是碰到表格外接框的正文;一行重复远比一句缺失容易察觉、容易原谅
检出的表格还带置信度,两种检测策略落在不同的区间。靠边线找到的表格得分 0.88 到 1.0,取决于多少单元格装着文字;纯靠留白对齐推断的表格得分 0.58 到 0.88。表格节点的 Confidence 存这个分数,每个单元格节点重复它,HTML 把它写成 <table> 元素上的 data-confidence。低于 TableOptions.MinConfidence(默认 0.5)的表格根本不会创建,被拒的表格其文字就地留在模型里当普通段落
对搜索索引或移动阅读视图,错误的表格代价很小、检对的表格收益很大,保持默认即可。档案转换则相反——围绕两栏地址块凭空造出的网格比没有网格更糟——把检测限制在带边线的表格:
Options := TPdfReflowOptions.Default;
Options.DetectTables := True;
Options.TableOptions.DetectWhitespaceTables := False; // 只要带边线的表格
Options.TableOptions.MinConfidence := 0.9;            // 连稀疏的带线网格也丢掉
Options.TableOptions.MaxTables := 200;                // 全文档上限
Options.TableOptions.MaxCells := 50000;               // 全文档上限

Doc := Pdf.BuildReflowDocument(Options);
if Doc.TableCount = 0 then
Writeln('No ruled tables; all page text is emitted as paragraphs');重排构建内部,MaxTables 和 MaxCells 按整个页面范围计数、不是按页,所以每页一张带线表格的 300 页对账单需要 MaxTables 至少 300,否则构建在第一张超限表格处抛 EPdfError 停下。默认是 1000 张表格、100000 个单元格
检测本身的内容——画成边线的细实心矩形、跨页延续的表格——见 表格检测与抽取
导出不依赖任何外部资源的 HTML
TPdfReflowDocument.ToHtml 遍历已构建好的模型,不再回头碰 PDFium,同一模型导出两次得到同一字符串。设了 FullDocument(默认)时结果是一整页:doctype、<meta charset="utf-8">、viewport meta 标签、取自文档 Title 条目的 <title>(空则是"PDF document"),以及来自文档语言的 lang 属性。关掉 FullDocument 得到单个 <div class="pdf-reflow"> 片段,丢进你自己的模板即可
IncludeCss 的可选样式表是一段内联 <style>:72rem 的阅读栏,IncludePageSections 打开时每页一张白色卡片,表格边框合并,以及一条 40rem 以下的媒体查询去掉卡片内边距、缩小表格文字。没有脚本、没有网络字体、没有任何外部 URL——文件因此能待在邮件里、CHM 风格的帮助查看器里或沙箱化的浏览器控件里。1 到 6 之外的标题级别写成 h2,表头单元格成为 th,RowSpan 或 ColumnSpan 大于 1 的单元格带上 rowspan 和 colspan。打开 IncludeGeometry 会附加 PDF 磅值计的 data-left、data-top、data-right 和 data-bottom,把搜索命中高亮回渲染页面上时很趁手
PreserveLineBreaks 值得深思熟虑。PDF 段落里的换行是为某一条固定栏宽做出的排版决定;把它留在 360 像素的屏幕上,每行折两次——那种参差感正是重排要消灭的东西。散文请保持关闭(默认)。换行自带含义的文档——地址、诗行、代码清单——再打开,此时写出的是 <br> 而不是空格
长文档下,把整页攒成一个 WString 再编码会把内存峰值翻倍。WriteHtml 把同样的标记流式写进 TPdfReportWriter,以 ASCII 写出、每个非 ASCII 字符写成数字字符引用,所以无论接收方怎么猜编码,字节都有效:
uses
  Classes, SysUtils, PDFium, FPdfAsync, FPdfReport;

procedure ExportReflowHtml(Pdf: TPdf; const FileName: string;
  const Token: IPdfCancellationToken);
var
  Options: TPdfReflowOptions;
  Doc: TPdfReflowDocument;
  Limits: TPdfReportLimits;
  Stream: TFileStream;
  Writer: TPdfReportWriter;
begin
  Options := TPdfReflowOptions.Default;
  Options.MaxNodes := 500000;
  Options.MaxCharacters := 20000000;
  Doc := Pdf.BuildReflowDocument(Options, Token);   // 页面状态事后会恢复

  Limits := TPdfReportLimits.Default;
  Limits.MaxCharacters := 64 * 1024 * 1024;  // 输出字节上限,最大 64 MiB
  Limits.MaxItems := Options.MaxNodes;       // 每节点一项,最大 1048576

  Stream := TFileStream.Create(FileName, fmCreate);
  try
    Writer := TPdfReportWriter.Create(Limits, Stream);  // 流仍归调用者所有
    try
      Doc.WriteHtml(Writer);
    finally
      Writer.Free;
    end;
  finally
    Stream.Free;
  end;
end;
WriteHtml 查的比 ToHtml 多。它拒绝节点数超过 Options.MaxNodes 的模型,对写出的文字执行 Options.MaxCharacters,把嵌套限制在 MaxDepth 参数内(默认 64),并核验每个 ParentIndex 都指向更早的节点。最后这条在你的代码在导出前过滤或改写 Nodes 时很要紧:带前向父索引的改后数组抛 EPdfReportLimit,而不是产出标签错配的标记
预算、取消与页面状态
PDF 是不受信任的输入,一份畸形或敌意的文件可以声明几千页的小字。BuildReflowDocument 在每个节点加入之前检查字符、节点、表格和单元格预算,超限的文件以 EPdfError 和一条点名预算的消息停下(比如"Reflow node budget exceeded"),内存占用始终有界。MaxCharacters 和 MaxNodes 都必须为正;默认 1000 万字符、100 万节点
可选的 IPdfCancellationToken 在每页之前、块与块之间、每张表格之前和每个表格行之前被检查。传入你窗体拥有的 TPdfCancellationTokenSource 的 Token,在按钮处理器里调 Cancel,构建在下一个检查点抛 EPdfOperationCancelled。请把它与 EPdfError 分开捕获,用户的取消不该被记成坏文件。无论构建以哪种异常收场,都不会返回半成品;失败若发生在 WriteHtml 内部靠后的位置,目标文件里是半页残缺内容,请在自己的异常处理器里删掉它
页面状态是 GUI 代码依赖的细节。构建靠移动 PageNumber 访问范围内每一页,一个 try/finally 在成功、预算失败和取消三种结局下都把调用者的页面放回去。用户正在读第 340 页时发起导出的查看器,导出返回时还在第 340 页
重排适合哪里
重排输出很适合当输入:搜索索引、无障碍阅读视图、手机展示、向 CMS 的内容迁移。它刻意放弃绝对定位、精确字体、矢量图形和页面几何——可选的 data-* 坐标除外。工作需要页面看起来一模一样时,渲染它;需要文字在别处可读时,重排它
因为标题和列表只来自标签,HTML 的质量跟着上游标记的质量走。通过 PDF/UA 结构树校验各项检查的文档产出带真实标题层级的模型,同一份带标签内容也驱动着 构建无障碍阅读器里的阅读功能
重排、结构化文本、表格抽取和渲染在 Delphi、C++Builder 和 Lazarus 里都作用于同一个 TPdf 对象;选项记录、异常和报告写手都记录在 PDFium Component for Delphi 产品页上