В шрифте TrueType, хранящем стандартный порядок глифов Macintosh, слово «Total» может лежать в потоке контента PDF как <0037005200570044004F> Tj. Эти пять двухбайтовых значений — номера глифов внутри внедрённого шрифта, и ничто в строке не говорит, что они рисуют T, o, t, a и l. Прочтите эти байты как UTF-16 — получите строку 7RWDO, тогда как страница на экране показывает Total: чтобы нарисовать глиф, достаточно отображения код-в-глиф, а чтобы получить текст обратно, нужно отображение код-в-Unicode, которого файл может никогда и не нести
Почему извлечённый текст превращается в абракадабру?
Поток контента записывает коды символов, а их смысл целиком живёт в шрифте. Операторы Tj и TJ (ISO 32000-1 §9.4.3) несут строки байтов, которые толкуются через тот шрифт, который выбрал предшествующий Tf: байт 0x41 — буква A в WinAnsi, произвольный глиф в шрифте-подмножестве или половина двухбайтового CID в составном CJK-шрифте. ISO 32000-1 §9.10 трактует извлечение текста ровно как эту задачу декодирования — сопоставление каждого кода с Unicode по тому, что даёт словарь шрифта, и прямо говорит: соответствующий стандарту файл не обязан предоставлять достаточно информации, чтобы её решить
За каждой жалобой вида «копирую из этого PDF — получаю мусор» стоит именно эта оговорка. Генератор, внедривший шрифт-подмножество без таблицы /ToUnicode, записал корректный файл, который рисуется правильно. Все глифы на месте. Не хватает обратной карты, которую извлекателю приходится восстанавливать по косвенным уликам: объявленной кодировке шрифта, именам глифов, опубликованным Adobe коллекциям символов, таблице cmap внутри программы внедрённого шрифта. Сколько из этого пробует тот или иной API и что он вручает, когда не сработало ничего, — именно это и различает библиотеки извлечения на практике
Текст в порядке чтения через ExtractLoadedPageText
HotPDF Delphi Component возвращает текст загруженной страницы в порядке чтения через function ExtractLoadedPageText(PageIndex: Integer; out AText: UnicodeString): boolean. Индексы страниц отсчитываются от нуля, результат — обычный для Delphi UnicodeString, а при отсутствии на странице читаемого потока контента функция возвращает False вместо того чтобы возбуждать исключение. Работает это с любым загруженным PDF: счётом, который клиент прислал по почте, отчётом от сканирующего бюро, договором, выпущенным программой, чьё имя уже никто не назовёт
var
  Pdf: THotPDF;
  PageCount, I: Integer;
  PageText, AllText: UnicodeString;
begin
  Pdf := THotPDF.Create(nil);
  try
    PageCount := Pdf.LoadFromFile('invoice.pdf');  // возвращает количество страниц
    AllText := '';
    for I := 0 to PageCount - 1 do
      if Pdf.ExtractLoadedPageText(I, PageText) then
        AllText := AllText + PageText + #13#10;
  finally
    Pdf.Free;
  end;
end;
Для всего документа одной строкой есть ExtractLoadedPagesText(PageRange, PageSeparator): он принимает диапазон с единицы, вроде '1,3-5,7-' (пустая строка значит все страницы), и вставляет PageSeparator — по умолчанию символ form feed #12 — между страницами. Большие документы лучше гонять через ExtractLoadedPagesTextToStream, который пишет UTF-8 постранично в TStream и возвращает число обработанных страниц
Текст содержит то, что показывает страница. Глифы, чей центр бокса лежит вне видимой области (crop box внутри media box), отбрасываются, так что типографские метки на обрезанной странице не утекут в ваш индекс. Текст внутри Form XObjects, которыми страница рисует, включается, с обрезкой по /BBox каждой формы. Символ, нарисованный дважды в одной точке, — старый трюк для имитации жирного, — читается один раз; как распознаётся этот случай, разбирает статья о ложном жирном и дублирующихся глифах при извлечении текста
Переносы строк подчиняются простому геометрическому правилу. Новая строка начинается, когда начало координат глифа уходит вдоль направления письма дальше половины высоты текста — в единицах страницы берётся большее из значений «от верхнего выносного до нижнего» для этого глифа и предыдущего. Мерить бокс глифа, а не операнд размера в Tf — вот что здесь важно: немало генераторов задают кегль через текстовую матрицу и передают в Tf единицу, и порог, построенный на этом операнде, ломался бы на каждом верхнем индексе и раскладывал повёрнутый текст по символу на строку. Пробелы между словами устроены так же. Там, где генератор разделяет слова сдвигом текстовой позиции — подстройкой в TJ или Td — вместо показа символа пробела, пробел добавляется, как только зазор после собственной ширины предыдущего глифа превышает 0.15 высоты глифа, и никогда — между двумя китайскими, японскими или корейскими символами. Коды, которые декодер не смог разрешить, становятся пробелами, так что границы слов выживают даже там, где отдельные глифы — нет. Горизонтальный текст выходит в порядке потока контента; вертикальные CJK-фрагменты перегруппировываются в колонки, читаемые справа налево, сверху вниз. Пороги разбирает статья о словесных пробелах и перенесах строк в тексте страницы
Сетка, колонки или порядок структуры
Когда позиция несёт смысл (таблицы, формы, листинги, всё, что вы будете сравнивать через diff, фильтровать через grep или разбирать по колонкам), лучше звать ExtractLoadedPageTextLayout. Он собирает глифы в базовые линии, сортирует каждую базовую линию по X и воспроизводит горизонтальные и вертикальные пробелы на моноширинной символьной сетке, размер которой задаётся медианным шагом глифа и размером шрифта на странице. Широкие зазоры на базовой линии становятся сериями пробелов, большие интервалы между базовыми линиями — пустыми строками
uses System.IOUtils;
...
var
  Grid: UnicodeString;
begin
  if Pdf.ExtractLoadedPageTextLayout(0, Grid) then
    TFile.WriteAllText('page1.txt', Grid, TEncoding.UTF8);
  // Колонки, отступы и выравнивание таблиц сохраняются в виде
  // пробелов и пустых строк на символьной сетке
end;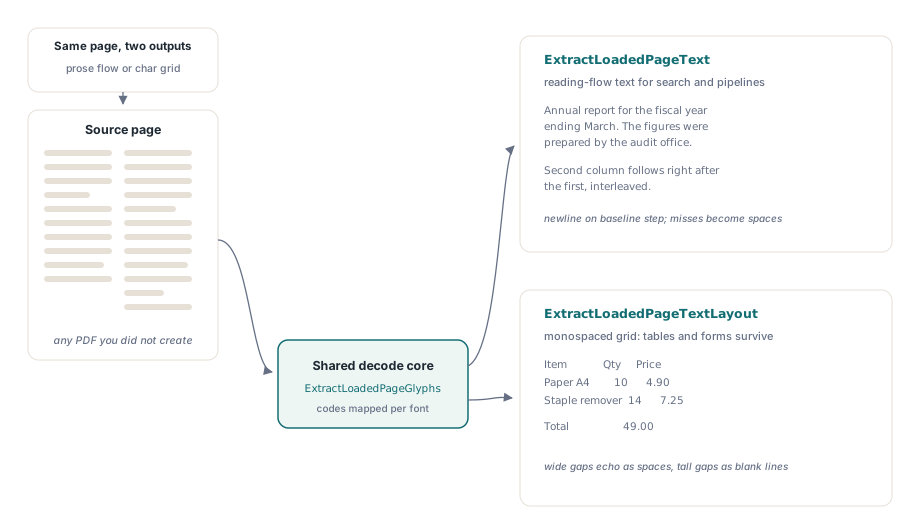
Оба вызова декодируют через одну и ту же машинерию, так что выбор между ними ничего не стоит по точности. Чего сетка не умеет, так это перелицовывать прозу: двухколоночная статья выходит обеими колонками бок о бок, честно, — это правильно для diff и неправильно для суммаризатора. Два других вызова закрывают эту брешь. ExtractLoadedPageTextColumns(PageIndex, AText, ColumnGapMultiplier) режет каждую строку там, где зазор между соседними глифами превышает множитель, умноженный на медианный шаг (по умолчанию 3.0), и разделяет куски табуляцией. ExtractLoadedPageStructureText(PageIndex, AText, UntaggedGlyphCount) обходит дерево структуры тегированного PDF (ISO 32000-1 §14.8.4) и возвращает фрагменты помеченного контента в авторском порядке; он возвращает False, когда у страницы нет пригодного дерева структуры, а UntaggedGlyphCount сообщает, сколько глифов не удалось пристроить
Для текста, который будет читать человек или языковая модель, сперва пробуйте порядок структуры и откатывайтесь к ExtractLoadedPageText. Дерево структуры — единственный порядок, который автор объявил намеренно, а любой геометрический метод рядом с ним — лишь догадка. Сетку оставьте для задач, где колонки — это данные. Как помеченный контент сопоставляется с деревом, подробно разбирает статья об извлечении текста в порядке структуры
Как HotPDF декодирует коды символов в Unicode
HotPDF Delphi Component разрешает каждый код символа через цепочку резервных стратегий в порядке приоритета, и стратегия, которая не смогла ответить, передаёт код следующей. Сначала идёт CMap /ToUnicode шрифта (ISO 32000-1 §9.10.3) — единственное отображение, которое генератор записал специально ради извлечения. За ним следуют имена глифов из массива /Differences в /Encoding, читаемые через Adobe Glyph List; затем сам CMap /Encoding, внедрённый потоком или именованный, где имя Uni…-UTF16 означает, что код уже является UTF-16. Составные шрифты продолжаются через коллекции символов Adobe (Adobe-GB1, Adobe-CNS1, Adobe-Japan1, Adobe-Korea1, Adobe-KR) от CID к Unicode, затем через /CIDToGIDMap в таблицу cmap программы внедрённого шрифта, читаемую в обратную сторону от глифа к Unicode. Простые шрифты откатываются к таблицам WinAnsi, MacRoman, Standard и MacExpert и в конце — к тому же внедрённому cmap. Код, исчерпавший цепочку, разрешается в 0
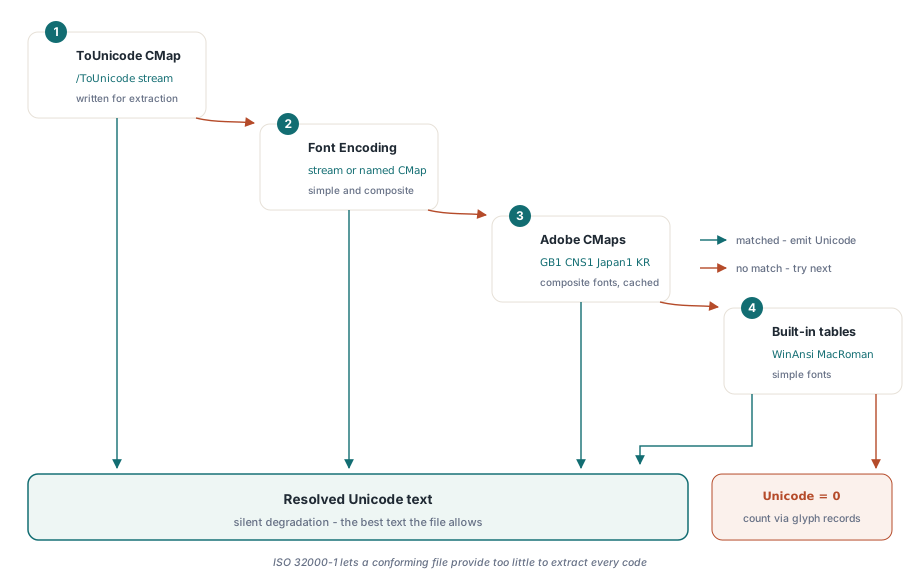
Именно шаг внедрённого cmap спасает многие шрифты-подмножества, уходящие к получателям без /ToUnicode: программа шрифта обычно всё ещё содержит собственный Unicode-cmap, и чтение его в обратную сторону возвращает большую часть текста. Но это реконструкция. Два символа Unicode, делящие один глиф, оба вернутся тем, что значится в cmap, поэтому к восстановленному тексту относитесь как к годному для поиска и индексации и проверяйте его, прежде чем делать юридическим документом
Данные коллекций Adobe лежат на диске. HotPDF поставляет файлы CMap и cid2code.txt в своей папке resources\CMap, разбирает каждый файл не более одного раза за процесс и кэширует результат; одна карта Adobe-GB1 — это примерно 2 МБ текста, который не хочется разбирать на каждой странице. Предопределённые CMap существуют и как встроенные таблицы, так что шрифт, закодированный именованным CMap вроде UniGB-UTF16-H, декодируется и без папки. А вот таблицам CID-to-Unicode для CJK-шрифтов с Identity-H папка нужна. Свойство CMapResourcePath называет папку, в которой лежат подпапки коллекций; если оставить его пустым, HotPDF ищет resources\CMap рядом с исполняемым файлом и на один-два уровня выше
Pdf := THotPDF.Create(nil);
try
  // Папка, в которой лежат Adobe-GB1-6, Adobe-CNS1-7, Adobe-Japan1-7 ...
  Pdf.CMapResourcePath := 'C:\MyService\resources\CMap';
  Pdf.LoadFromFile(FileName);
  ...
finally
  Pdf.Free;
end;
В любом сервисе, модуле ISAPI или DLL-плагине задавайте путь явно. В таких хостах ParamStr(0) называет процесс-хост, а это редко та папка, куда вы всё развернули, и отсутствие папки не возбуждает исключений; CJK-страницы просто возвращаются с дырами там, где могли бы заполнить таблицы коллекций. Тем же расколом код-против-глифа, но уже на стороне записи, занимается статья о формировании сложных письменностей в HotPDF
Две синтаксические ловушки CMap
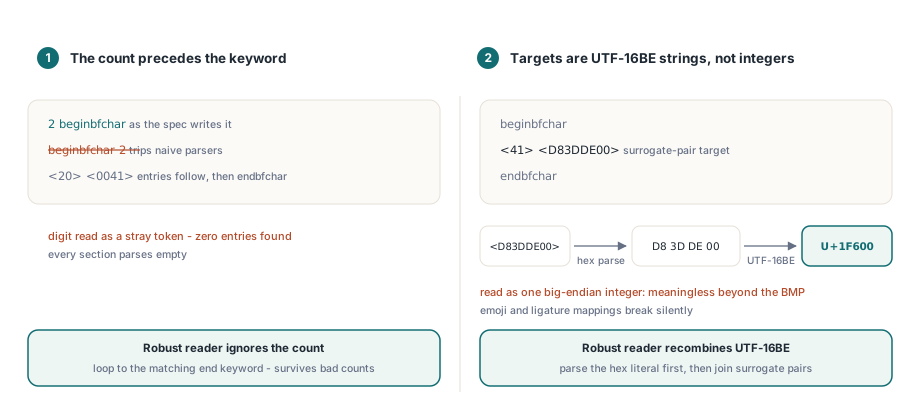
Файлы CMap выглядят элементарно разбираемыми, и две детали валят большинство первых попыток. Количество записей стоит перед ключевым словом раздела: раздел читается как 2 beginbfchar, а никогда beginbfchar 2. Парсер, ждущий число после ключевого слова, проглотит его как лишний токен и затем найдёт ноль записей в каждом разделе. Читалка HotPDF игнорирует количество целиком и крутит цикл до соответствующего endbfchar или endbfrange, что заодно переживает реальные файлы, у которых объявленные количества неверны
Вторая ловушка в том, что цели bfchar и bfrange — строки UTF-16BE. Приёмник <D83DDE00> означает U+1F600 — суррогатную пару, которую надо пересобрать в один кодовый пункт, а чтение этих четырёх байтов как big-endian целого даёт бессмысленное значение для каждого символа вне базовой многоязычной плоскости, эмодзи включительно. HotPDF сперва разбирает hex-литерал в сырые байты и лишь затем пересобирает кодовые единицы UTF-16BE, что заодно покрывает многосимвольные цели, которые порождают лигатурные отображения, — например, один глиф fi, отображающийся в две буквы
Подсчёт неразрешённых глифов через ExtractLoadedPageGlyphs
ExtractLoadedPageGlyphs(PageIndex, AGlyphs) выставляет наружу глифовые записи, лежащие под текстовыми вызовами, в виде THPDFGlyphArray. Каждая THPDFGlyphRecord несёт сырой Code, его CodeByteWidth (1, 2 или 4 — как решит codespacerange CMap), разрешённую кодовую точку Unicode плюс UnicodeSequence для лигатур, активные FontKey и FontSize, начало координат X и Y в пользовательском пространстве, Advance, четырёхугольник глифа по четырём углам и GlyphEndX / GlyphEndY — конец собственной ширины глифа, от которого правило словесных пробелов ведёт отсчёт. Этого хватает для позиционного выделения или собственного алгоритма вёрстки
var
  Glyphs: THPDFGlyphArray;
  I, Unresolved: Integer;
begin
  if Pdf.ExtractLoadedPageGlyphs(0, Glyphs) then
  begin
    Unresolved := 0;
    for I := 0 to High(Glyphs) do
      if Glyphs[I].Unicode = 0 then
        Inc(Unresolved);
    if Unresolved > 0 then
      ShowMessageFmt('%d of %d glyphs have no Unicode mapping',
        [Unresolved, Length(Glyphs)]);
  end;
end;
Подсчёт записей с Unicode = 0 — честный способ оценить документ, прежде чем доверять его тексту дальше по конвейеру. Учтите, что счётчик будет слегка отличаться от того, что видят текстовые вызовы. Этот вызов возвращает каждый глиф из собственного потока контента страницы, включая лежащие вне crop box и дубли, нарисованные ради ложного жирного, и не спускается в Form XObjects. Каждая запись также хранит TokenIndex, ItemIndex и ByteOffset, привязывающие символ к его исходному операнду; на этих трёх полях построен поиск и замена в существующем PDF
У некоторых файлов текста нет вовсе. Отсканированная страница — одно большое изображение без текстовых операторов, так что извлечение корректно вернёт пустую строку, а путь дальше — OCR, начинающийся с извлечения изображений страницы из загруженного PDF. Шифрованные документы извлекаются как обычно, стоит открыть их через LoadFromFile(FileName, Password): потоки расшифровываются до того, как их прочитает интерпретатор. Потоки шрифтов и контента декодируются той же цепочкой фильтров, что и остальной загруженный документ, а поток /ToUnicode, который не удаётся декодировать, передаёт стратегию следующей, пока остальная страница всё же извлекается. Тем же чтением объектов обеспечено редактирование метаданных загруженных документов, так что за один проход импорта можно прочитать текст и поправить метаданные
Извлечение в порядке чтения, сеткой, по колонкам и в порядке структуры, плюс доступ на уровне глифов поставляются в составе HotPDF Delphi Component для Delphi и C++Builder как чистый Object Pascal без внешних DLL и текстовых служб ОС, так что когда в вашу очередь попадёт странный файл, вы сможете зайти отладчиком в декодер и увидеть, какая стратегия ответила за каждый код