У вас есть PDF на диске, клиент отсканировал в него пачку счетов, и ваша задача состоит в том, чтобы извлечь изображения страниц обратно в bitmap для прохода OCR. Вы загружаете файл, находите image XObjects, а затем сталкиваетесь с тем, о чем никто не предупреждает: байты в этих потоках не являются пикселями. Это может быть codestream JPEG, blob JPEG 2000 с вейвлетным сжатием, факс Group 4 или индексированный растр за палитрой и фильтром Flate. Объект изображения знает свою ширину и высоту, но реальные сэмплы запечатаны внутри того фильтра, который выбрал создатель PDF. Чтобы получить пригодный TBitmap, нужно снять этот фильтр, а PDF предлагает примерно восемь разных способов, которыми эти байты могут быть упакованы
Именно этот пробел закрывает ExtractLoadedImage в HotPDF — нативном VCL PDF-компоненте для Delphi и C++Builder. Он перечисляет image XObjects в загруженном документе, сообщает, что представляет собой каждый из них, и декодирует те, которые может, обратно в 24-битный bitmap. Интересна здесь не поверхность API — она состоит из трёх методов. Интересно то, почему вообще должен существовать отдельный путь декодирования и какие фильтры он превращает обратно в пиксели
Почему загруженные изображения не декодируются заранее
Загрузчик HotPDF построен вокруг точной сквозной передачи. Когда вы вызываете LoadFromFile, потоки изображений сохраняются ровно в том виде, в каком они присутствуют в исходном файле: исходный фильтр, исходные сжатые байты, исходный словарь. Это сделано намеренно. Обычно смысл загрузки документа состоит в том, чтобы копировать страницы, объединять файлы, ставить штампы, заново назначать права и записывать документ обратно, а для всего этого самый дешевый и безопасный вариант состоит в том, чтобы вообще не трогать каждый поток изображения. Декодирование каждого изображения в растр при загрузке тратило бы память и CPU на работу, которая большинству вызывающих сторон вообще не нужна, а повторное кодирование при сохранении ухудшало бы изображения, которые следовало скопировать дословно
Следствие состоит в том, что загруженный граф объектов не несёт в себе пикселей. Image XObject, у которого /Filter равно /DCTDecode, содержит байты JPEG; HotPDF никогда не запускал над ним JPEG-декодер, потому что в пути копирования и переписывания это было не нужно. Поэтому, когда вам действительно нужны пиксели, API извлечения должен выполнить декодирование сам, с нуля, для того фильтра, который использует конкретное изображение. По той же причине кодеки на стороне кодирования независимы от загрузчика: статья о добавлении изображений JPEG 2000 в PDF в Delphi описывает, как движок JPX подключается на стороне создания, и API извлечения подсоединяет тот же движок к пути чтения
API из трех методов
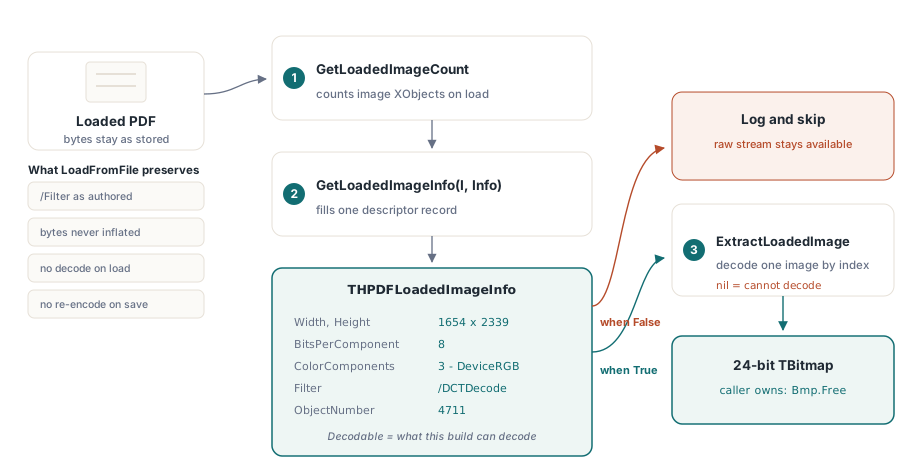
Поверхность здесь небольшая. GetLoadedImageCount возвращает количество image XObjects в загруженном документе. GetLoadedImageInfo заполняет запись-дескриптор для одного из них по индексу. ExtractLoadedImage возвращает декодированный bitmap или nil, если не может декодировать это изображение. Перечисление основано на индексах и стабильно для конкретной загрузки: внутри компонент обходит таблицу косвенных объектов и собирает каждый поток, у которого /Subtype разрешается в /Image, поэтому индекс, который вы передаете в GetLoadedImageInfo, является тем же индексом, который вы передаете в ExtractLoadedImage
var
  Pdf: THotPDF;
  Info: THPDFLoadedImageInfo;
  Bmp: TBitmap;
  I, Count: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('scanned-invoices.pdf', '') <= 0 then
      Exit;
    Count := Pdf.GetLoadedImageCount;
    for I := 0 to Count - 1 do
    begin
      if not Pdf.GetLoadedImageInfo(I, Info) then
        Continue;
      if not Info.Decodable then
        Continue;                       // filter или цветовое пространство не поддерживаются
      Bmp := Pdf.ExtractLoadedImage(I);
      if Bmp <> nil then
      try
        Bmp.SaveToFile(Format('img_%d.bmp', [I]));
      finally
        Bmp.Free;                       // владелец bitmap — вызывающий код
      end;
    end;
  finally
    Pdf.Free;
  end;
end;
Здесь важны две детали контракта. Во-первых, возвращенный TBitmap вы освобождаете сами, документ его не кэширует и не владеет им. Во-вторых, проверяйте Decodable перед вызовом и сравнивайте результат с nil после него. Метод не выбрасывает исключение при неподдерживаемом фильтре, он возвращает nil, а тихий nil в пакетном цикле это именно тот сценарий, из-за которого одна страница из задания на тысячу страниц исчезает незаметно для всех
Чтение дескриптора перед декодированием
THPDFLoadedImageInfo сообщает, что представляет собой изображение, не вынуждая выполнять полное декодирование. Его поля считываются прямо из словаря изображения: Width и Height в сэмплах, BitsPerComponent, ColorComponents и ColorSpace, описывающие интерпретацию после декодирования, 1 для gray, 3 для RGB, 4 для CMYK, Filter как именованное сжатие, IsImageMask для трафаретных масок, ObjectNumber для базового косвенного объекта и Decodable
Этот последний флаг и есть честный индикатор. Decodable равно True только тогда, когда текущая сборка действительно может превратить именно это сочетание фильтра и цветового пространства в bitmap. Он кодирует реальную матрицу поддержки, а не пожелание: изображение, у которого Filter текущая сборка не понимает, сообщает Decodable = False, и по этому признаку можно решать, логировать ли его, пропускать или переходить к собственному извлечению сырого потока. Относитесь к этому как к предусловию, а не как к подсказке
// Проверить каждое изображение перед переходом к декодированию
var
  Pdf: THotPDF;
  Info: THPDFLoadedImageInfo;
  I: Integer;
begin
  // ... Pdf loaded ...
  for I := 0 to Pdf.GetLoadedImageCount - 1 do
  begin
    if not Pdf.GetLoadedImageInfo(I, Info) then
      Continue;
    if Info.Decodable then
      // ExtractLoadedImage(I) will return a TBitmap
    else
      // неподдерживаемый filter/цветовое пространство: записать объект в журнал и пропустить
      Writeln(Format('Image %d obj %d: %dx%d %s/%s not decodable',
        [I, Info.ObjectNumber, Info.Width, Info.Height,
         String(Info.Filter), String(Info.ColorSpace)]));
  end;
end;
Одна деталь реализации регулярно ловит людей, которые собирают записи-дескрипторы вручную. THPDFLoadedImageInfo содержит два поля AnsiString, Filter и ColorSpace. Это управляемые типы со счетчиком ссылок, поэтому рефлекторное обнуление записи через FillChar(Info, SizeOf(Info), 0) здесь неверно: оно перезаписывает ссылку на строку, не уменьшая счетчик, что приводит к утечке или порче состояния. HotPDF инициализирует запись поле за полем именно по этой причине, и если вы когда-нибудь повторите этот шаблон в своем коде, делайте так же
Один диспетчер, восемь путей фильтрации
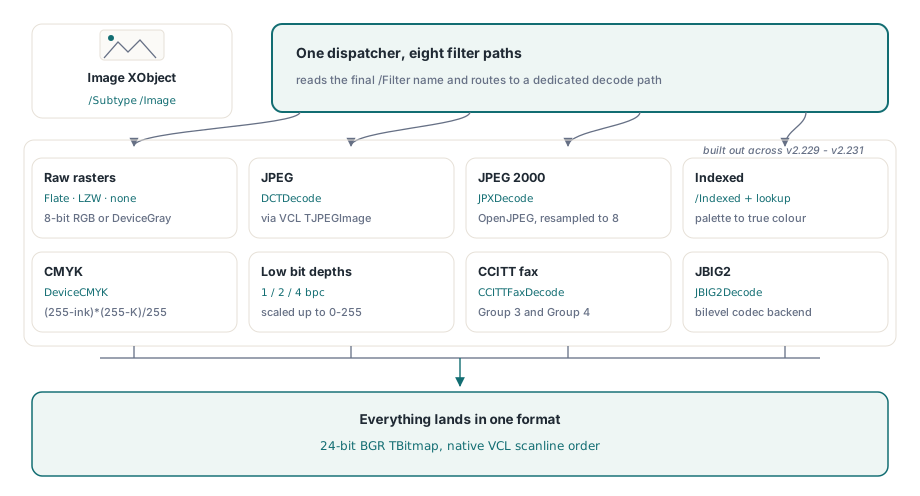
Причина, по которой извлечению вообще нужен диспетчер, состоит в том, что у PDF нет формата изображения. Есть фильтры, и §8.9.5 ISO 32000-1 разрешает image XObject указать любой из них в /Filter, а интерпретация сэмплов отдельно задается через /ColorSpace, /BitsPerComponent и необязательный массив /Decode. ExtractLoadedImage читает имя фильтра и направляет обработку в специализированный декодер для каждого случая. Поддерживаемый набор покрывает восемь разных путей
- Сырые растры, FlateDecode, LZWDecode или отсутствие фильтра в 8-битном DeviceRGB или DeviceGray. Байты распаковываются в плотный растр, и единственным преобразованием остается перестановка каналов, о которой сказано ниже
- DCTDecode, JPEG. Codestream передается в VCL-овский
TJPEGImage, который восстанавливает геометрию и цвет, после чего результат присваивается 24-битному bitmap - JPXDecode, JPEG 2000. Декодирование выполняется через backend OpenJPEG, тот же движок, который описан в статье про JPEG 2000, с пересэмплированием компонентов высокой битности до 8 бит
- Индексированный цвет. Палитра считывается из массива
[/Indexed base hival lookup], а каждый сэмпл раскрывается через lookup table в истинный цвет - DeviceCMYK. Четырехканальные сэмплы преобразуются в RGB по стандартной формуле ink-on-white
- DeviceGray и Indexed с глубиной ниже 8 бит при 1, 2 или 4 битах на компонент, где значения распаковываются по одному сэмплу и масштабируются в диапазон 0–255
- CCITTFaxDecode, фильтры факса Group 3 и Group 4, которые декодируются выделенным backend T.4/T.6
- JBIG2Decode, высокоэффективный bilevel-фильтр, декодируемый через зарегистрированный backend JBIG2, который статья о нативном сжатии JBIG2 рассматривает со стороны кодирования
Все в итоге приходит в одну и ту же точку: 24-битный BGR bitmap, потому что именно так VCL TBitmap хранит данные нативно и именно этого ожидает любой последующий потребитель
Преобразования, которые незаметно меняют пиксели
Два из этих путей включают преобразование, которое легко реализовать с тонкой ошибкой, и его стоит понимать, даже если вы никогда не будете трогать сам декодер. Первое связано с перестановкой порядка цветов. Растр PDF DeviceRGB хранит сэмплы в порядке red-green-blue, начиная с верхней строки. VCL 24-bit scanline хранит их в порядке blue-green-red. Поэтому декодирование обычного RGB-изображения не сводится к memcpy, первый и третий байты каждого пикселя нужно поменять местами при записи в scanline. Перепутаете направление, и красный с синим поменяются местами. На сером тестовом изображении это выглядит нормально, а на цветном дает катастрофически неверный результат. Что касается порядка строк, он совпадает напрямую: top-down растр в PDF соответствует ScanLine[0] VCL как верхнему визуальному ряду, поэтому вертикальный переворот не нужен
Второе преобразование связано с CMYK. Изображения PDF DeviceCMYK несут четыре краски, и преобразование в RGB является вычислением по каналам, а не lookup table: каждый выходной канал вычисляется как (255 - ink) * (255 - K) / 255. Это приближение на уровне устройства, а не управляемое по цвету преобразование через ICC profile, поэтому результат достаточно корректен для отображения и повторной растеризации, но это не тот путь, который нужен для цветоточного вывода на печать. Если вашему процессу нужна максимальная точность, рассматривайте извлеченный bitmap как preview и сохраняйте исходный поток CMYK для color-managed pipeline
Путь Indexed скрывает и собственную ловушку разбора. Палитра в цветовом пространстве /Indexed может храниться как literal string или как hexadecimal string, а HotPDF хранит значение hex string как hex текст, а не как уже декодированные байты. Поэтому, когда палитра задана hex string, lookup table сначала нужно прогнать через декодирование hex-to-bytes. Для literal string байты уже являются сырыми. Если пропустить эту ветку, индексированное изображение с четырьмя цветами превращается в мусор, потому что каждая запись палитры читается со смещением по неправильной границе байтов
Цепочки фильтров, собственным фильтром изображения является последний
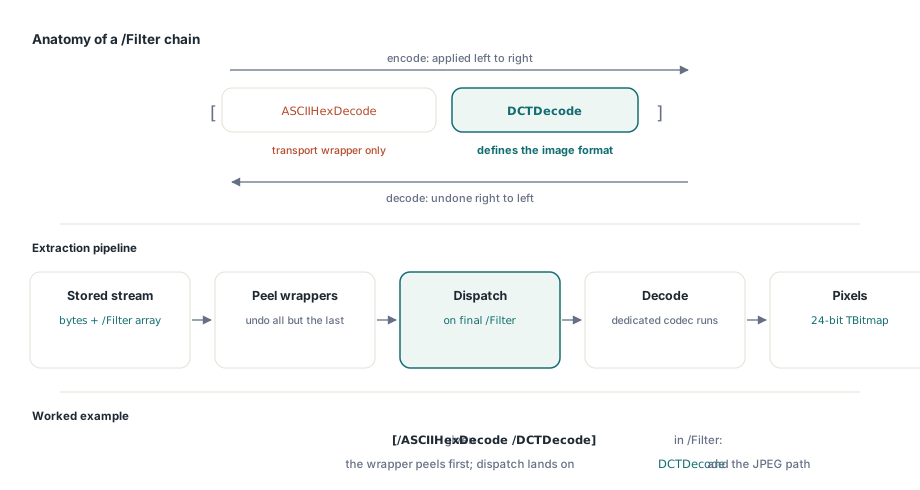
Одно имя /Filter это простой случай. PDF также допускает цепочку фильтров, где поток последовательно проходит через несколько этапов и они перечисляются по порядку в массиве /Filter, например [/ASCII85Decode /FlateDecode] или [/ASCIIHexDecode /DCTDecode], ISO 32000-1 §7.4. Семантика здесь точная: фильтры применяются слева направо при кодировании, значит, при декодировании вы снимаете их справа налево, и именно последний фильтр в массиве фактически определяет формат изображения. Все предыдущие фильтры являются лишь транспортными оболочками вокруг него
Экстрактор обрабатывает это поэтапно. Перед запуском любого декодера изображения каждый фильтр в цепочке, кроме последнего, применяется для получения того входа, который ожидает финальный фильтр, и только после этого диспетчеризация идет по последнему фильтру. Поэтому [/ASCII85Decode /DCTDecode] сначала снимает с потока ASCII85, а затем направляет результат в путь JPEG. [/FlateDecode] вокруг сырого растра сначала распаковывается, а затем запускает растровый путь. Именно это позволяет всем восьми декодерам оставаться простыми. Ни одному из них не нужно знать что-либо про ASCII85 или оболочки hex-передачи, потому что к моменту, когда декодер видит байты, оболочки уже сняты. Это также означает, что цепочка, чей финальный фильтр не поддерживается, все равно завершается чистым отказом на этапе диспетчеризации, а не где-то посередине
Что возвращается и когда брать сырой поток
Вы получаете базовое изображение, как его декодирует собственный поток, а не скомпонованный результат с применённым soft mask. Компоненты JPEG 2000 глубже 8 бит пересэмплируются до 8, что подходит для отображения и OCR, а image mask — однобитный трафарет без собственного цвета — помечается флагом IsImageMask, чтобы вы обращались с ним как с трафаретом, а не с фотографией. Изображение, чей финальный фильтр или цветовое пространство не входит в набор выше, возвращает nil, поэтому защита через Decodable принадлежит каждому циклу
Когда нужны alpha, полная битовая глубина или color-managed вывод, сырой поток по-прежнему лежит прямо в загруженном графе объектов, со всеми фильтрами, и вы можете вынуть его побайтно и передать собственному специализированному кодеку. Это тот fallback, который сквозной дизайн сохраняет намеренно: исходные байты никогда не выбрасываются, поэтому худший случай — декодировать их самому, а не потерять данные. Для большинства реальных задач, впрочем, поддерживаемые восемь фильтров покрывают то, что фактически выдают сканеры, офисные пакеты и движки отчетов, а цикл по GetLoadedImageCount с защитой через Decodable за несколько строк превращает загруженный PDF обратно в папку с bitmap
API извлечения загруженных изображений вместе с полным набором описанных здесь фильтров декодирования поставляется в HotPDF Delphi Component для Delphi и C++Builder