Фрагмент потока контента [(Reference)-333(Manual)] TJ рисует два слова с явным зазором между ними, но не содержит ни одного символа пробела. Зазор — движение пера: ISO 32000-1 §9.4.3 велит читателю сдвинуть следующий глиф вправо на 333 тысячных размера шрифта, прежде чем рисовать Manual. Экстрактор, копирующий символы и игнорирующий геометрию, вернёт ReferenceManual, и поисковый индекс, кормящийся от него, никогда не совпадёт с фразой “Reference Manual”. Вывод TeX, многие файлы Distiller и большинство выключенных наборов разделяют слова именно так
Разрывы строк ломаются с другой стороны. Поднятый верхний индекс режет свою строку надвое, диагональная watermark DRAFT приезжает по символу на строку, а обрезанная сигнатурка начинается с printer’s slug line, которую не показывает ни один просмотрщик. Ни один из этих файлов не битый. Каждый использует легальный способ размещения текста, который экстрактор-копировальщик символов читает неверно
Словные пробелы, восстановленные из геометрии глифов
HotPDF’s THotPDF.ExtractLoadedPageText из HotPDF Delphi Component решает словные разрывы по позициям глифов, и символ пробела в потоке — лишь один из читаемых им сигналов. По направлению письма предыдущего глифа он меряет дистанцию от конца собственной ширины того глифа до origin текущего и вставляет один пробел, когда дистанция превышает 0.15 высоты бокса текущего глифа, отмеренной от ascent до descent в user space. Для фрагмента TJ выше треть эм с запасом сидит за той чертой для любого обычного начертания, поэтому текст страницы читается Reference Manual
Два условия придерживают пробел. Ничего не добавляется, когда текст на данный момент уже кончается пустым местом или следующий глиф — оно (пробел, таб, неразрывный пробел, идеографический пробел), поэтому производители, которые пробелы показывают, задвоенных не получают. Ничего не добавляется и между двумя CJK-символами. Иероглифы, кана, хангыль и полноширинные формы считаются все, потому что выключка растягивает китайскую или японскую строку, и эта растяжка не означает границу слова. Отдельно от обоих: глиф-бокс нулевой высоты откатывается к размеру Tf как к своей высоте. Каждое число, которым пользуется правило, хранится на записях глифов, так что файл с подозрительными пробелами можно переиграть глиф за глифом
uses
  SysUtils, HPDFDoc, HPDFContentStream;

// Печатает зазоры, которые ExtractLoadedPageText превратил бы в пробелы.
// Только горизонтальный текст; ExtractLoadedPageGlyphs возвращает поток
// контента страницы без текста Form XObject и без crop-фильтра
procedure DumpWordGaps(Pdf: THotPDF; PageIndex: Integer);
var
  Glyphs: THPDFGlyphArray;
  I: Integer;
  Height, Gap: Double;
begin
  if not Pdf.ExtractLoadedPageGlyphs(PageIndex, Glyphs) then
    Exit;
  for I := 1 to High(Glyphs) do
  begin
    if Glyphs[I].Vertical or Glyphs[I - 1].Vertical then
      Continue;
    // высота бокса глифа от ascent до descent, в user space
    Height := Sqrt(Sqr(Glyphs[I].QuadX[3] - Glyphs[I].QuadX[0]) +
      Sqr(Glyphs[I].QuadY[3] - Glyphs[I].QuadY[0]));
    if Height <= 0 then
      Height := Abs(Glyphs[I].FontSize);
    // зазор от конца собственной ширины предыдущего глифа
    Gap := Glyphs[I].BaselineStartX - Glyphs[I - 1].GlyphEndX;
    if (Height > 0) and (Gap > 0.15 * Height) then
      Writeln(Format('U+%.4x gap %.2f height %.2f: space',
        [Glyphs[I].Unicode, Gap, Height]));
  end;
end;
Зачем мерить от glyph’s own width, а не от позиции пера?
Потому что позиция пера после глифа уже содержит шпак, которая к словным разрывам отношения не имеет. ISO 32000-1 §9.4.4 определяет горизонтальное смещение как ширину глифа, умноженную на размер шрифта, плюс межсимвольный сдвиг Tc, плюс межсловный Tw, всё помноженное на горизонтальное масштабирование Tz. Каждая запись глифа несёт оба конца: BaselineEndX / BaselineEndY держат полное смещение, а GlyphEndX / GlyphEndY — только font’s advance при текущем размере и Tz. Расходятся они на файлах, которые поджимают трекинг отрицательным Tc и возвращают пробел через TJ-adjustment после каждого глифа. Меришь от пера — каждая компенсация выглядит зазором, и китайский термин вроде “95后” выходит как “9 5 后”. Меришь от glyph’s own width — adjustment возвращает лишь то, что забрал Tc, и термин остаётся целым
Порог привязан к высоте бокса глифа, а не к размеру Tf, по смежной причине. Word-экспорты часто пишут 1 Tf и несут настоящий размер в промасштабированном Tm, так что операнд размера шрифта читается 1, а текст в высоту 10 пунктов. Правило, привязанное к тому операнду, опустило бы порог до 0.15 пункта на такой странице, и ординарные кернинговые пары начали бы читаться словными разрывами. Высота бокса меряется после применения всех матриц, поэтому 1 Tf с масштабированной матрицей и честный 10 Tf дают одинаковый текст
Два краевых случая следуют из геометрии напрямую. Заголовок, набранный с очень редким межбуквенным сдвигом, где один Tc открывает между буквами больше 0.15 высоты текста, извлекается как S P A C E D. Так страница и выглядит, и мы предпочли бы вернуть это, чем добавлять эвристику, угадывающую, какие широкие зазоры — трекинг, а какие — слова; такая догадка начинает глотать настоящие словные разрывы в плотно выключенных колонках, а для поиска это провал похуже. Куски, нарисованные не по порядку на одной базовой линии, дают отрицательный зазор и склеиваются без пробела. В бегущем основном тексте случай редкий
Когда в извлечённом тексте начинается новая строка?
HotPDF’s ExtractLoadedPageText открывает новую строку, когда сдвиг от origin предыдущего глифа к текущему, спроецированный на нормаль предыдущего направления письма, превышает половину большей из двух высот боксов. Движение вдоль базовой линии никогда не считается за разрыв строки, как бы ни прыгало перо
Правило, сравнивающее сырой сдвиг Y с половиной размера Tf, проваливается в обе стороны. При 1 Tf и масштабированном Tm порог сжимается до половины единицы, поэтому верхний индекс, поднятый text rise на 0.4, рвёт строку. Так же поступает и мелкая дрожь базовой линии, которую оставляют некоторые движки вёрстки между прогонами. То же правило полностью игнорирует X. Текст под повёрнутым Tm — та самая диагональная watermark — ступает вниз по странице с каждым глифом и выходит по символу на строку, тогда как проекция обращается с 45-градусным прогоном ровно как с горизонтальным
Взятие большей из двух высот важно, когда на одной строке мешаются размеры. Слово-витрина в 36 пунктов, за которым следует подпись в 8 пунктов на пару пунктов ниже, оценивается против половины высоты крупного глифа, поэтому пара остаётся вместе; против малого глифа в одиночку подпись уехала бы на собственную строку. Text rise — часть origin глифа, вот почему поднятая базовая линия верхнего индекса меряется против той же половинной высоты
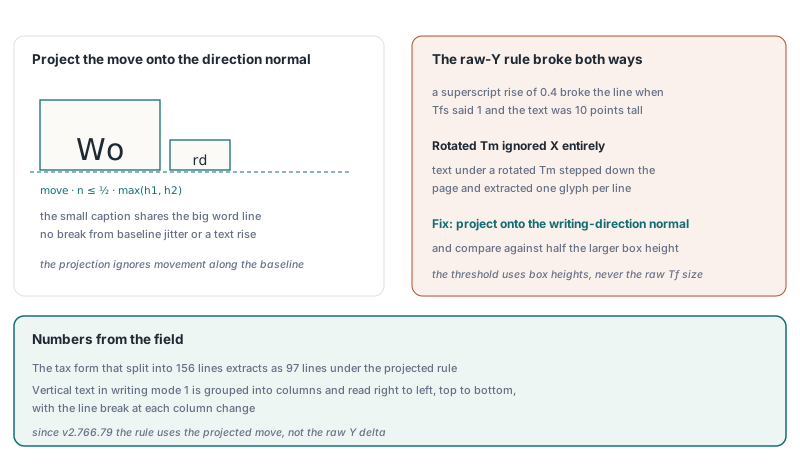
Vertical text в writing mode 1 (§9.7.4.3) идёт отдельным путём. Те глифы группируются в колонки по origin X с половиной размера шрифта в качестве толеранса колонки, затем читаются справа налево и сверху вниз, с разрывом строки при каждой смене колонки. Страница, смешивающая вертикальный японский корпус с горизонтальным бегущим колонтитулом, тоже получает разрыв строки при каждом переключении между направлениями
Какие глифы попадают в текст страницы
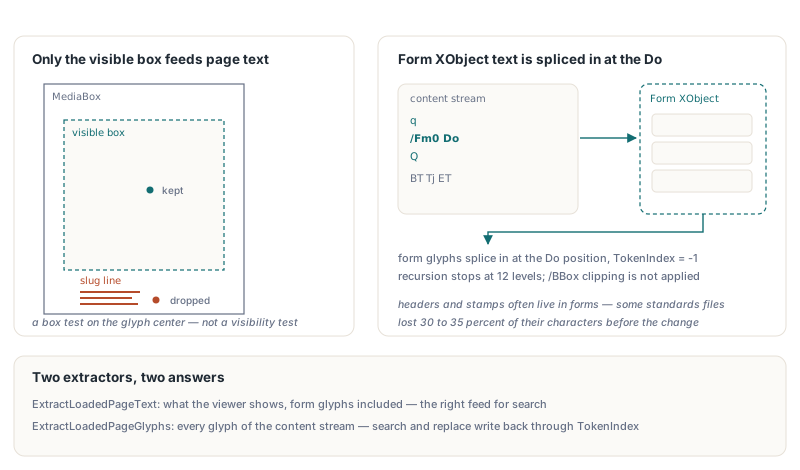
ExtractLoadedPageText возвращает текст, который показывает просмотрщик. Он держит только глифы, чей центр бокса падает внутрь GetLoadedPageVisibleBox — CropBox, клипнутого MediaBox (§14.11.2), — поэтому slug-строки и прочие printer’s marks, набранные текстом вне зоны обрезки, выпадают. ExtractLoadedPageGlyphs продолжает возвращать каждый глиф потока контента страницы, slug-строку включительно, для задач, которым это нужно. Фильтр — геометрический тест одной точки на глиф. Текст, спрятанный clipping path, покрашенный белым или накрытый изображением, всё равно выходит, потому что решать реальную видимость значило бы рендерить страницу
uses
  SysUtils, HPDFDoc, HPDFContentStream;

var
  Pdf: THotPDF;
  Raw, Merged: THPDFGlyphArray;
  PageText: UnicodeString;
  L, B, R, T: Single;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.LoadFromFile('trimmed-proof.pdf');
    if Pdf.GetLoadedPageVisibleBox(0, L, B, R, T) then
      Writeln(Format('Visible box: %.1f %.1f %.1f %.1f', [L, B, R, T]));
    // каждый глиф потока контента страницы, slug-строка включительно
    if Pdf.ExtractLoadedPageGlyphs(0, Raw) then
      Writeln(Length(Raw), ' glyphs in the page content stream');
    // поток страницы плюс текст Form XObject, в порядке рисования, до кропа
    if Pdf.ExtractLoadedPageGlyphsWithForms(0, Merged) then
      Writeln(Length(Merged), ' glyphs including forms');
    // то, что показывает страница: формы врезаны, вне-кроповые глифы выброшены
    if Pdf.ExtractLoadedPageText(0, PageText) then
      Writeln(PageText);
    // те же правила пробелов на нефильтрованном потоке, для диффа
    Writeln(HPDFAssemblePageText(Raw));
  finally
    Pdf.Free;
  end;
end.
Текст, нарисованный через Form XObject, — часть текста страницы. Колонтитулы, штампы и watermark чаще всего живут в формах, и экстрактор, читающий только поток контента страницы, никогда их не видит. HotPDF записывает каждый Do вместе с действующим CTM, интерпретирует форму при её /Matrix поверх того CTM (§8.10.1) и врезает form’s glyphs в позицию Do, рекурсируя во вложенные формы. Форма без собственных /Resources занимает чужие — те, что у рисующего её потока, — это старая раскладка, которую описывает §7.8.3. Глифы, чей центр падает вне form’s /BBox, выбрасываются, поскольку тот бокс клипает форму при отрисовке. Форма, рисующая саму себя — напрямую или через другую форму, — не входится второй раз, а вложенность останавливается на 12 уровнях
Глифы форм несут TokenIndex = -1 и ItemIndex = -1. Та же причина держит ExtractLoadedPageGlyphs на глифах потока страницы: поиск, замена и редактирование пишут изменения обратно через TokenIndex, и глиф формы в том массиве указал бы им на байты другого потока. Когда нужен объединённый список на уровне глифов, HotPDF’s ExtractLoadedPageGlyphsWithForms возвращает его в порядке рисования, до того как фильтр visible-box заработает
Ещё один проход идёт перед правилами пробелов. Оверпечатые логотипы и fake bold, сымитированный рисованием того же текста дважды с малым сдвигом, иначе извлекались бы с каждой буквой дважды. Когда глиф рисует тот же символ того же размера в пределах десятой доли этого размера вдоль базовой линии и пятой доли поперёк её — от более раннего глифа, — остаётся только одна копия; пробелы так никогда не убираются. В статье о fake bold и дубль-глифах при извлечении текста тот случай разобран по шагам
Текстовое состояние через q и Q
Текст после Q декодируется неверно в любом экстракторе, сохраняющем на q только CTM. Параметры текстового состояния — шрифт, размер, Tc, Tw, Tz, TL, режим рендеринга и подъём — принадлежат графическому состоянию (§9.3.1), поэтому Q обязан восстановить их вместе со всем остальным на стеке (§8.4.2). Один паттерн быстро разоблачает ошибку: двухбайтовый Identity-H шрифт выбирается внутри q … Q ради одной табличной ячейки, а текст после Q показывает однобайтовые WinAnsi-строки без собственного Tf. Интерпретатор, оставляющий внутренний шрифт, читает те байты парами, и отточия оглавления превращаются в строку посторонних CJK-символов. HotPDF’s интерпретатор кладёт все восемь значений текстового состояния вместе с CTM на каждый q и снимает на каждый Q
Всё выше применимо на каждой странице, поэтому целый документ уезжает в UTF-8 файл одним вызовом. HotPDF’s ExtractLoadedPagesTextToStream принимает диапазон страниц с 1-базной нумерацией (пустая строка значит все страницы), разделитель, записываемый между страницами, и флаг маркера порядка байтов, а возвращает число извлечённых страниц. Вывод дописывается с текущей позиции потока, так что в памяти не держится ничего крупнее текста одной страницы
uses
  SysUtils, Classes, HPDFDoc;

var
  Pdf: THotPDF;
  Output: TFileStream;
  Pages: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.LoadFromFile('report.pdf');
    Output := TFileStream.Create('report.txt', fmCreate);
    try
      // пустой диапазон = все страницы; form feed между страницами; UTF-8 BOM
      Pages := Pdf.ExtractLoadedPagesTextToStream(Output, '', #12, True);
      Writeln(Pages, ' pages extracted');
    finally
      Output.Free;
    end;
  finally
    Pdf.Free;
  end;
end.
Выбор текстового API под задачу
Для поиска и индексации правильная кормушка — HotPDF’s ExtractLoadedPageText: он следует порядку потока контента и отражает то, что показывает страница. Расшифровочная цепь под ним, от /ToUnicode-карт до CID-шрифтов, разобрана в материале об извлечении текста из загруженных PDF с HotPDF. Порядок потока контента слабее всего на тегированных документах, чей производитель записал бегущий колонтитул последним или чередовал две колонки; для них извлечение текста в структурном порядке идёт по дереву структуры в авторском порядке, вместо того выводить его из геометрии. Данные, запертые в таблицах, лучше обслуживает типизированное извлечение таблиц через разрывы страниц, возвращающее ячейки со значениями. Код, правящий страницу, обязан сидеть на ExtractLoadedPageGlyphs, чьи токен-индексы указывают на байты, которые он перепишет
Поля записей глифов из этих примеров, вместе с остальным текстовым API и пробной сборкой, документированы на странице продукта HotPDF Delphi PDF Component