Поле поиска вьюера подсвечивает "Acme Corp" на странице 2 счета, но байтовый поиск по декомпрессированному потоку страницы тех же девяти символов возвращается пустым. Уже для первого слова поток может держать что-то вроде <0024004600500048> Tj: двухбайтовые коды глифов во встроенном субсетном шрифте, где зазор между двумя словами произведен смещением позиционирования, а не пробелом. Заменить это имя значит декодировать те коды в Unicode, сматчить там, вернуться к точным байтам, произведшим попадание, и записать новые коды, которые тот же шрифт понимает. Когда субсет никогда не содержал глиф, нужный новому тексту, кодов для записи нет
Запросы за этим — обычное обслуживание документов. Компания переименовалась, и три тысячи архивных счетов все еще несут старое имя. Шаблон договора ушел с прошлогодней датой истечения. Снятый с производства артикул должен стать преемником в каждом даташите. В текстовом процессоре каждое из этого занимает тридцать секунд; в PDF каждое упирается в то, как страницы реально хранятся
Что страница PDF хранит вместо текста
Страница PDF держит позиционированные глифы, а не редактируемый текст. По ISO 32000-1 §9.4 поток содержимого ведет операторы показа текста вроде Tj и TJ, которые рисуют последовательности кодов символов в позициях, заданных текстовой матрицей. Те коды — индексы в какую бы кодировку ни объявил текущий шрифт. Дорога назад к читаемым символам может идти через /ToUnicode CMap (§9.10.3), /Encoding с массивом /Differences или цепочку CID-отображений для шрифтов Type0. Нет объекта абзаца и нет текстового потока, и ничто не обязывает производителя хранить одно видимое слово одной строкой: [(Ac) -12 (me)] TJ — совершенно обычный способ трекнуть слово
Замена добавляет второе требование поверх декодирования. Экстрактор текста может выбросить байтовые позиции, как только вытащил Unicode. Заменяльщику они нужны, потому что он должен знать, какие байты какого операнда строки произвели каждый глиф, чтобы переписать ровно тот диапазон и не тронуть все остальное. Поэтому простой StringReplace по байтам потока — неверный инструмент даже на файлах, которые случайно используют кодировку WinAnsi. Он понятия не имеет, какая ( принадлежит строке и какой Tf выбирает шрифт, дающий тем байтам их смысл
Поиск по декодированной последовательности глифов
HotPDF Delphi Component ищет по загруженному документу через SearchLoadedPageText и SearchLoadedDocumentText, которые матчят иглу против декодированной последовательности глифов Unicode каждой страницы, никогда против сырых байтов потока. Попадание — значит попадание, как бы шрифт его ни закодировал. При декодировании каждый глиф хранит запись об операнде строки, элементе массива TJ и байтовом смещении, откуда он пришел, — на этом позже строится шаг замены. Тот же интерпретатор глифов ведет API из статьи про извлечение текста из загруженного PDF в Delphi; поиск просто хранит исходные позиции, которые извлечение выбрасывает
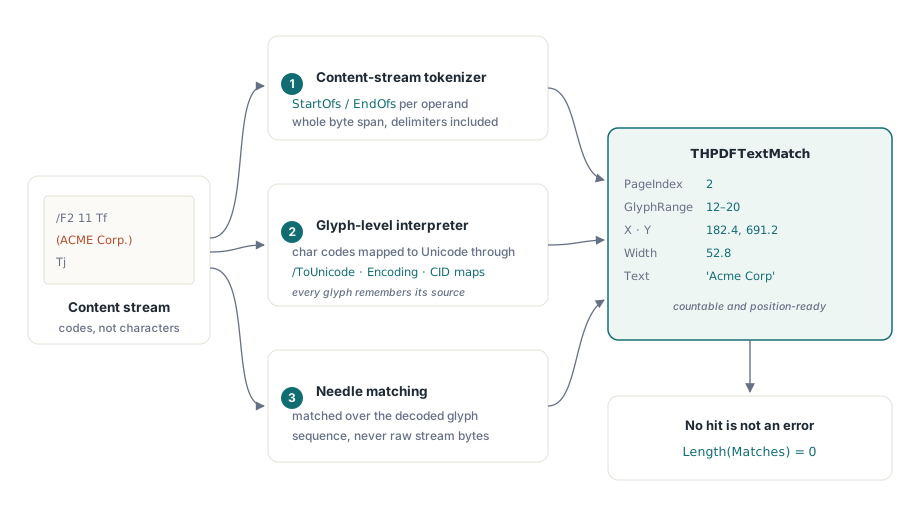
Каждое попадание возвращается записью THPDFTextMatch: PageIndex, включающий диапазон глифов в GlyphStart и GlyphEnd, начало в пользовательском пространстве в X и Y, Width попадания, исходные TokenIndex и ItemIndex и сматченный Text. PageIndex считается с нуля. Игла, которая не встречается, дает пустой массив и результат True, так что вызывающему коду не нужен спецслучай для «ничего не найдено»
var
  Pdf: THotPDF;
  Matches: THPDFTextMatchArray;
  I: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('invoices-2025.pdf') > 0 then
      if Pdf.SearchLoadedDocumentText('Acme Corp', False, Matches) then
        for I := 0 to High(Matches) do
          WriteLn(Format('page %d at (%.1f, %.1f), width %.1f: "%s"',
            [Matches[I].PageIndex + 1, Matches[I].X, Matches[I].Y,
             Matches[I].Width, Matches[I].Text]));
  finally
    Pdf.Free;
  end;
end;
Напечатает ли тот цикл что-нибудь, зависит прежде всего остального от пробелов. Поисковый текст строится из глифов, которые страница реально рисует, один символ на глиф, а TJ-смещение, визуально разделяющее два слова, — число в массиве, а не глиф. Производитель, задающий межсловные зазоры смещениями вместо символа пробела, выдает «AcmeCorp» в последовательности глифов, и игла «Acme Corp» не сматчится. Когда видимая фраза отказывается матчиться, ищите сначала ее самое длинное одиночное слово и смотрите на Text того, что возвращается
Регистр — второе, что стоит проверить. С CaseSensitive равным False сборки от Delphi XE2 и далее сравнивают символы через Unicode-отображение simple lowercase, независимое от локали, так что É матчится с é, а греческие или кириллические заглавные — со своими строчными. Сборки со старыми компиляторами фолдят только A–Z. Отображение — один символ к одному символу, что держит каждую позицию иглы выровненной ровно с одним глифом; следствие: ß не матчится с SS. Для whole-word потоков UI SearchLoadedPageTextWholeWord отбрасывает попадания, сидящие внутри более длинного слова, а GetLoadedSearchHitRect превращает попадание в единственный прямоугольник для отрисовки подсветки
Поиск и замена работают на собственных потоках /Contents страницы. Текст, нарисованный внутри Form XObject — туда многие инструменты кладут штампованные колонтитулы, — живет в отдельном потоке, который страница вызывает через Do, и он вне обеих операций
Переписывание сматченных байтов через ReplaceLoadedDocumentText
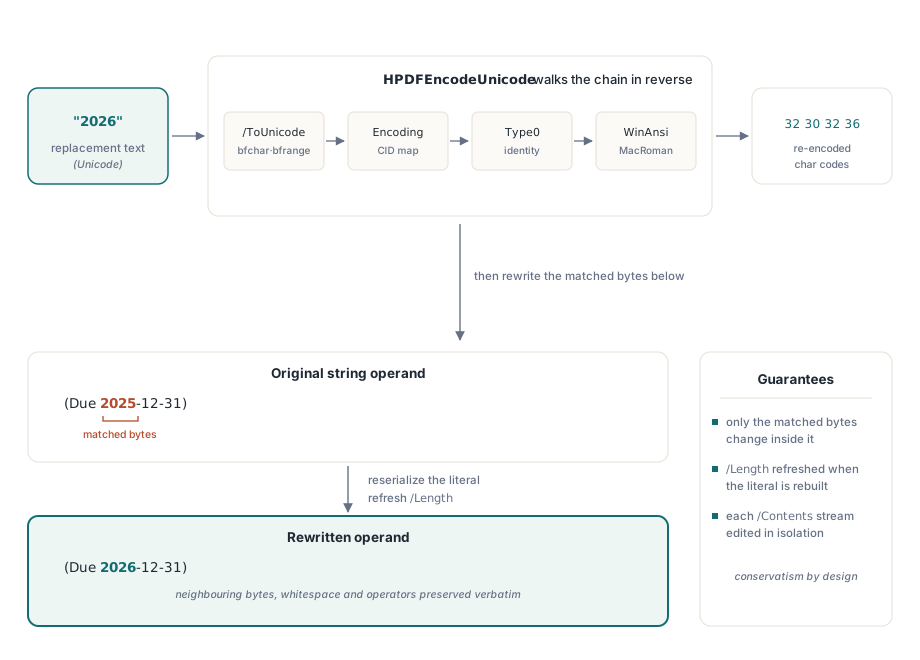
ReplaceLoadedPageText и ReplaceLoadedDocumentText переписывают каждое вхождение иглы, прогоняя декодирование шрифта назад. Каждый символ замены ищется по той же цепочке, которой пользуется декодер, в обратную сторону: записи bfchar и bfrange в /ToUnicode, CID-отображения для шрифтов Type0, тождественные отображения и предопределенные таблицы WinAnsi и MacRoman. Получившиеся коды символов записываются назад литеральной строкой или hex-строкой, когда какой-либо байт выпадает из печатаемого ASCII, следуя тем же правилам экранирования, которые читает парсер потока содержимого
Меняются только байты, накрытые попаданием. Несматченные байты того же операнда, пробелы между токенами, комментарии и каждый окружающий операнд проходят нетронутыми. Замена bca внутри abcabc дает a + replacement + bc. Замена может быть короче или длиннее иглы, и каждый поток в массиве /Contents страницы обрабатывается сам по себе, так что страница остается well-formed. Когда попадание сидит поперек нескольких операндов строк, как Hello, хранящееся как [(He) -20 (llo)] TJ, замена пишется в операнд, где попадание началось, а сматченные байты удаляются из операндов, идущих следом
var
  Pdf: THotPDF;
  Rewrites: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('contract-draft.pdf') > 0 then
    begin
      if Pdf.ReplaceLoadedDocumentText('2025-12-31', '2026-12-31',
        True, Rewrites) then
        WriteLn(Format('%d operand rewrites', [Rewrites]));
      Pdf.SaveLoadedDocument('contract-final.pdf');
    end;
  finally
    Pdf.Free;
  end;
end;
Страница не переверстана. В PDF нет reflow, поэтому замена, более широкая оригинала, просто занимает больше горизонтального места и может врезаться в то, что нарисовано справа от нее; позиция следующего глифа была зафиксирована производителем и не двигается. Даты, строки версий, артикулы и правки орфографии сходной длины — та работа, для которой метод построен. Переформулировать абзац значило бы переверстать все ниже по потоку, так что такое изменение — дело исходного документа
Почему субсет шрифта не может взять символы, которых никогда не содержал?
Символ замены, который встроенный субсет никогда не включал, не имеет кода символа, в который можно развернуться. Когда производитель делает субсет шрифта, его /ToUnicode CMap и кодировка покрывают только глифы, которые использовал исходный документ, а контуры глифов для всего остального просто отсутствуют в файле. Если документ никогда не печатал заглавную E этим шрифтом, никакая байтовая последовательность ее не выберет. Это ограничение сидит в файле, а не в инструменте, делающем замену
ReplaceLoadedDocumentText обращается с некодируемой заменой консервативно: если хоть один символ не может быть перекодирован, то вхождение пропускается целиком. Нет исключения и нет наполовину замененной строки, а исходный текст остается читаемым. В примере с датой выше цифра 6 должна существовать где-то в том же шрифте, чтобы перезапись удалась. Положим, шрифт печатал только «2025» и несколько сумм заказов без шестерки: даты останутся как есть
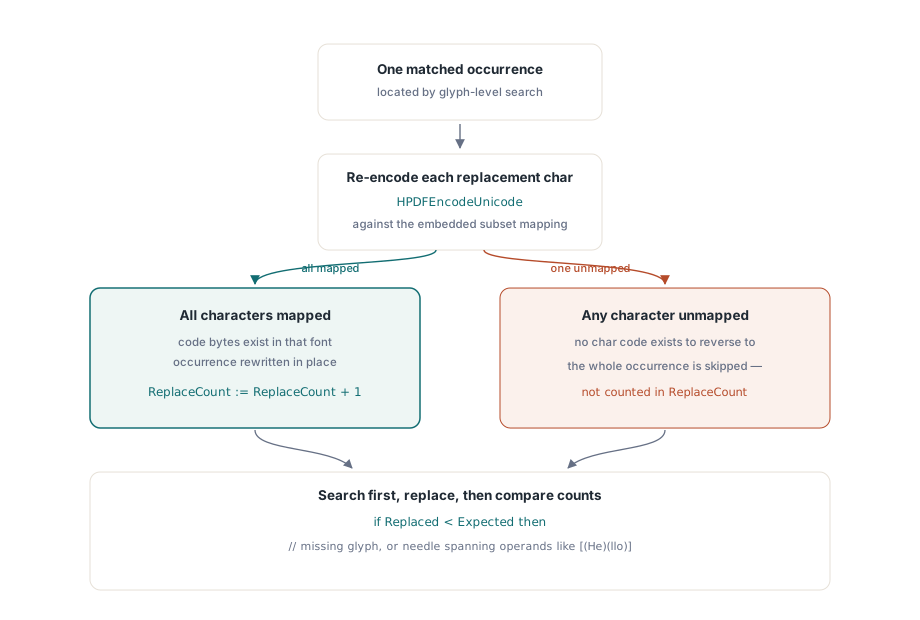
ReplaceCount репортит перезаписи операндов, и попадание, размазанное по нескольким операндам, может дать больше одной перезаписи. Счет ниже числа попаданий все еще значит, что что-то пропущено, но точный ответ дает повторный поиск после замены. Что находит второй поиск — то и осталось, со страницей и позицией прилагательно
procedure ReplaceAndAudit(Pdf: THotPDF; const OldText, NewText: UnicodeString);
var
  Before, After: THPDFTextMatchArray;
  Rewrites, I: Integer;
begin
  // Повторный поиск работает, только когда NewText сам не содержит OldText
  Pdf.SearchLoadedDocumentText(OldText, True, Before);
  Pdf.ReplaceLoadedDocumentText(OldText, NewText, True, Rewrites);
  Pdf.SearchLoadedDocumentText(OldText, True, After);
  WriteLn(Format('%d found, %d operand rewrites, %d left',
    [Length(Before), Rewrites, Length(After)]));
  for I := 0 to High(After) do
    WriteLn(Format('  left on page %d at (%.1f, %.1f)',
      [After[I].PageIndex + 1, After[I].X, After[I].Y]));
end;
Когда субсет короток: предпросмотр и применение с новым шрифтом
Для вхождений, которые байтовый метод не может закодировать, PreviewLoadedPageTextReplacement и ApplyLoadedPageTextReplacement идут другим маршрутом: они удаляют сматченные глифы и рисуют замену на месте шрифтом по вашему выбору, в исходном размере и на исходной базовой линии. Умолчание THPDFLoadedTextReplacementOptions берет Arial в размере шрифта сматченного текста, подгоняет бокс под ширину сматченного текста и держит Atomic включенным. Единственный отвергнутый матч на странице тогда откатывает остальные. Предпросмотр возвращает план с одним результатом на матч, каждый несет Status и при отвержении — Reason
var
  Opts: THPDFLoadedTextReplacementOptions;
  Plan, Applied: THPDFLoadedTextReplacementPlan;
  I: Integer;
begin
  // Pdf — загруженный THotPDF; PageIndex — страница с нуля, отмеченная аудитом
  Opts := THPDFLoadedTextReplacementOptions.Default;
  Opts.Appearance.FontName := 'Arial';
  Opts.Appearance.OverflowPolicy := ltopShrinkToFit;
  Opts.Appearance.MinFontSize := 6;
  if not Pdf.PreviewLoadedPageTextReplacement(PageIndex, 'Acme Corp',
    'Apex Corporation', True, Opts, Plan) then
    for I := 0 to High(Plan.Results) do
      if Plan.Results[I].Status = ltrsRejected then
        WriteLn(Format('match %d at (%.1f, %.1f): %s',
          [I, Plan.Results[I].X, Plan.Results[I].Y, Plan.Results[I].Reason]));
  if (Plan.RejectedCount = 0) and (Plan.ReadyCount > 0) then
  begin
    Pdf.ApplyLoadedPageTextReplacement(Plan, Applied);
    WriteLn(Format('%d of %d matches applied',
      [Applied.AppliedCount, Applied.MatchedCount]));
  end;
end;
Причины отвержения стоит печатать, потому что они отображаются прямо в геометрию страницы. Матч, пересекающий из одной текстовой строки в следующую, отвергается, как и вертикальный текст. С умолчанием ltopReject политики переполнения отвергается и замена, не умещающаяся в ширину матча. ltopShrinkToFit вместо этого ступает размером вниз к MinFontSize — почему пример и выставляет его для замены на пять символов длиннее иглы. Замена, содержащая символы, которые выбранный шрифт не может показать, тоже отвергается
План несет отпечаток содержимого страницы и шрифтов. Если что-то меняет страницу между предпросмотром и применением, ApplyLoadedPageTextReplacement бросает EInvalidOpException вместо записи в страницу, которую предпросмотр никогда не видел. Страницы с несбалансированными парами q/Q или BT/ET и документы с полями подписей бросают EArgumentException; подписанным документам нужны инкрементальные обновления, чтобы подписанная ревизия оставалась целой
Байтовая замена идет первой, а путь со сменой шрифта запускается только на страницах, где аудит все еще находит старый текст. Байтовая перезапись хранит оригинальный шрифт, его метрики и кернинг, так что отредактированный текст совпадает с соседями по строке. Путь предпросмотра рисует другой гарнитурой, и на строке, набранной узким или серифным шрифтом, внимательный читатель увидит смену. Когда цель — заставить текст исчезнуть, а не переформулировать его, настоящее удаление содержимого — лучший инструмент; редактирование и реструктуризация загруженных PDF в Delphi разбирает тот путь
Что меняется в сохраненном файле
Поток содержимого, отредактированный ReplaceLoadedPageText, сохраняется несжатым. Поток декодируется для правки, и когда перестроенные байты пишутся назад, его записи /Filter и /DecodeParms сбрасываются, а /Length обновляется. PDF валиден и рендерится нормально; цена — больший файл для каждого отредактированного потока. Батч-задание по тысячам счетов должно закладывать этот рост или гонять проход сжатия afterward
Путь предпросмотра и применения меняет чуть больше. Примененная страница получает единственный новый несжатый поток содержимого вместо оригинального /Contents, плюс собственную копию словаря ресурсов с добавленным шрифтом замены. Все остальное в документе оставлено в покое: нетронутые потоки хранят сжатие, существующие шрифты и изображения не переписываются, а страницы без попаданий никогда не открываются на запись. Как переписанные объекты ложатся в структуру перекрестных ссылок при сохранении, разобрано в объектных потоках и инкрементальных обновлениях в HotPDF
Поиск, байтовая замена, замена с предпросмотром и применением, извлечение и редактирование идут на одном интерпретаторе потоков содержимого, от Delphi 5 до текущего RAD Studio, без внешних зависимостей. Справочник методов, опции замены и пробная сборка — на странице продукта HotPDF Delphi Component