표준 Macintosh 글리프 순서를 지키는 TrueType 폰트에서 "Total"이라는 단어는 PDF 콘텐츠 스트림에서 <0037005200570044004F> Tj로 앉아 있을 수 있습니다. 그 다섯 2바이트 값은 임베디드 폰트 안의 글리프 번호이고, 문자열 어디에도 그것들이 T, o, t, a, l을 그린다는 말은 없습니다. 그 바이트들을 UTF-16으로 읽으면 7RWDO라는 문자열을 얻는 반면, 페이지 자체는 화면에 Total을 보여줍니다. 글리프를 그리는 데는 코드-글리프 사상만 필요하고, 텍스트를 되찾는 데는 파일이 애초에 운반하지 않았을 수 있는 코드-유니코드 사상이 필요하기 때문입니다
추출된 텍스트가 왜 널더미로 나올까
콘텐츠 스트림은 문자 코드를 기록하고, 그 의미는 전적으로 폰트에 삽니다. Tj와 TJ 연산자(ISO 32000-1 §9.4.3)는 바로 앞의 Tf가 선택한 폰트를 통해 해석되는 바이트 문자열을 나릅니다. 바이트 0x41은 WinAnsi 아래에서는 글자 A, 서브셋 폰트에서는 임의의 글리프, 컴포지트 CJK 폰트에서는 2바이트 CID의 절반입니다. ISO 32000-1 §9.10은 텍스트 추출을 정확히 이 디코딩 문제, 즉 폰트 사전이 제공하는 무엇이든에서 각 코드를 유니코드로 되돌리는 일로 다루고, 적합한 파일이 그것을 할 만큼 충분한 정보를 제공할 요구가 없다고 못박습니다
그 조항이 "이 PDF에서 복사-붙여넣기 하면 쓰레기가 나온다"는 모든 보고의 뒤에 있습니다. /ToUnicode 테이블 없이 서브셋 폰트를 임베드하는 생산자는 올바르게 렌더링되는 유효한 파일을 쓴 것입니다. 글리프는 전부 있습니다. 없는 것은 역방향 맵이고, 추출기는 그것을 2차 증거에서 다시 만들어야 합니다. 폰트의 선언된 인코딩, 글리프 이름, Adobe의 공개 문자 컬렉션, 임베디드 폰트 프로그램 안의 cmap 테이블. API가 그중 몇 개를 시도하는가, 전부 실패했을 때 무엇을 건네주는가가 실무에서 추출 라이브러리를 갈라놓습니다
ExtractLoadedPageText로 읽기 흐름 텍스트 얻기
HotPDF Delphi Component는 function ExtractLoadedPageText(PageIndex: Integer; out AText: UnicodeString): boolean을 통해 로드된 페이지의 읽기 흐름 텍스트를 반환합니다. 페이지 인덱스는 0 기반이고, 결과는 네이티브 Delphi UnicodeString이며, 페이지에 읽을 만한 콘텐츠 스트림이 없으면 예외 대신 False를 반환합니다. 로드하는 어떤 PDF에든 동작합니다. 고객이 이메일로 보낸 송장, 스캔 업체가 전달한 보고서, 이제는 이름을 알 수 없는 소프트웨어가 만든 계약서입니다
var
  Pdf: THotPDF;
  PageCount, I: Integer;
  PageText, AllText: UnicodeString;
begin
  Pdf := THotPDF.Create(nil);
  try
    PageCount := Pdf.LoadFromFile('invoice.pdf');  // 페이지 수를 반환합니다
    AllText := '';
    for I := 0 to PageCount - 1 do
      if Pdf.ExtractLoadedPageText(I, PageText) then
        AllText := AllText + PageText + #13#10;
  finally
    Pdf.Free;
  end;
end;
문서 전체를 하나의 문자열로는 ExtractLoadedPagesText(PageRange, PageSeparator)가 '1,3-5,7-' 같은 1 기반 범위를 받아(빈 문자열은 모든 페이지) 페이지 사이에 PageSeparator, 기본값은 폼 피드 #12,를 넣습니다. 큰 문서는 ExtractLoadedPagesTextToStream이 낫습니다. TStream에 UTF-8로 페이지마다 쓰고 처리한 페이지 수를 반환합니다
텍스트는 페이지가 보여주는 것을 담습니다. 박스 중심이 가시 영역(미디어 박스 안의 크롭 박스) 밖에 있는 글리프는 빠지므로, 절단된 페이지의 인쇄 표식이 인덱스로 새지 않습니다. 페이지가 칠하는 Form XObject 안의 텍스트는 각 폼의 /BBox로 클립되어 포함됩니다. 같은 자리에 두 번 칠해진 문자, 굵은 서체를 흉내 내던 옛 트릭,은 한 번 읽힙니다. 텍스트 추출의 가성 볼드와 중복 글리프가 그 경우의 탐지 방법을 안내합니다
줄바꿈은 간단한 기하 규칙을 따릅니다. 글리프 원점이 쓰기 방향을 가로질러 텍스트 높이의 절반보다 많이 움직이면 새 줄이 시작되고, 높이는 이 글리프와 이전 글리프의 어센트-디센트 높이 중 큰 것을 페이지 단위로 잡습니다. Tf 크기 피연산자 대신 글리프 박스를 재는 것이 중요한 부분입니다. 수많은 생산자가 텍스트 행렬로 크기를 정하고 Tf에는 1을 넘기며, 그 피연산자 위에 세운 임계값은 올려진 위첨자마다 무너지고 회전된 텍스트의 글자 하나하나를 별도 줄에 놓습니다. 단어 공백도 같은 식입니다. 생산자가 공백을 보여주는 대신 TJ 조정이나 Td로 텍스트 위치를 옮겨 단어를 갈라 놓은 곳에서는, 이전 글리프 자체 폭 뒤의 간격이 글리프 높이의 0.15를 넘으면 공백이 더해지고, 중국어·일본어·한국어 문자 두 개 사이에는 결코 더해지지 않습니다. 디코더가 해석하지 못한 코드는 공백이 되어, 개별 글리프가 실패해도 단어 경계는 살아남습니다. 가로 텍스트는 콘텐츠 스트림 순서로 나오고, 세로 CJK 런은 오른쪽에서 왼쪽으로, 위에서 아래로 읽는 열로 재편성됩니다. 페이지 텍스트의 단어 공백과 줄바꿈이 그 임계값들을 다룹니다
그리드, 열, 구조 순서
위치가 의미를 나르는 곳, 즉 표와 폼, 코드 목록, 열 단위로 diff하거나 grep하거나 파싱할 모든 것에는 ExtractLoadedPageTextLayout이 더 낫습니다. 글리프를 베이스라인으로 묶고, 각 베이스라인을 X순으로 정렬하고, 페이지의 중앙값 전진폭과 폰트 크기로 크기 정해진 등폭 문자 격자에서 가로와 세로 공백을 재현합니다. 베이스라인 위의 넓은 간격은 공백 런이 되고, 베이스라인 사이의 큰 간격은 빈 줄이 됩니다
uses System.IOUtils;
...
var
  Grid: UnicodeString;
begin
  if Pdf.ExtractLoadedPageTextLayout(0, Grid) then
    TFile.WriteAllText('page1.txt', Grid, TEncoding.UTF8);
  // 열, 들여쓰기, 표 정렬이 문자 격자 위의
  // 공백과 빈 줄로 살아남습니다
end;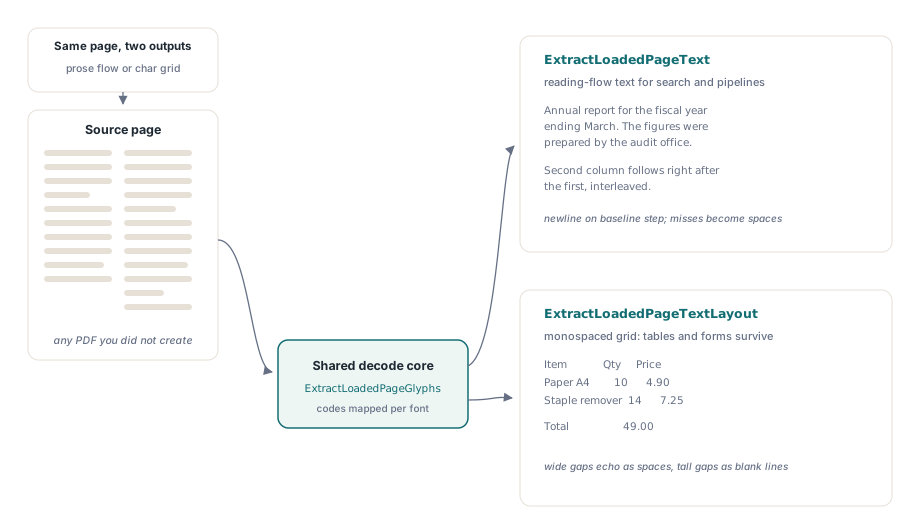
두 호출은 같은 장치를 통해 디코드하므로 어느 쪽을 고르는 데도 충실도 비용은 없습니다. 격자가 하지 않는 것은 산문의 재유동입니다. 두 단짜 글은 두 열이 나란히 나오는데, diff에는 맞고 요약기에는 틀립니다. 그 간극을 메우는 호출이 둘 더 있습니다. ExtractLoadedPageTextColumns(PageIndex, AText, ColumnGapMultiplier)는 이웃 글리프 사이의 간격이 중앙값 전진폭의 배수(기본 3.0)를 넘을 때마다 각 행을 갈라 탭으로 조각들을 구분합니다. ExtractLoadedPageStructureText(PageIndex, AText, UntaggedGlyphCount)는 태그된 PDF(ISO 32000-1 §14.8.4)의 구조 트리를 걷고 marked-content 런을 저작 순서로 반환합니다. 페이지에 쓸 만한 구조 트리가 없으면 False를 반환하고, UntaggedGlyphCount는 놓아준 글리프가 몇 개인지 알려줍니다
사람이나 언어 모델이 읽을 텍스트라면 구조 순서를 먼저 시도하고 ExtractLoadedPageText로 폴백하세요. 구조 트리는 저자가 의도적으로 선언한 유일한 순서이고, 모든 기하적 방법은 그에 비하면 추측입니다. 격자는 열이 데이터인 작업에 남겨 두세요. 구조 순서 텍스트 추출에 marked content가 트리와 짝지어지는 방법의 세부가 있습니다
HotPDF는 문자 코드를 어떻게 유니코드로 디코드하나
HotPDF Delphi Component는 각 문자 코드를 우선순위 순 폴백 체인으로 해석하고, 답하지 못하는 전략은 코드를 다음 전략에 넘깁니다. 폰트의 /ToUnicode CMap(ISO 32000-1 §9.10.3)이 첫머리입니다. 생산자가 추출을 위해 특별히 쓴 유일한 사상이기 때문입니다. 그다음은 /Encoding /Differences 배열의 글리프 이름으로, Adobe Glyph List를 통해 읽힙니다. 그다음 /Encoding CMap 자체로, 스트림으로 임베드되거나 이름으로 주어지며, Uni…-UTF16 이름은 코드가 이미 UTF-16임을 뜻합니다. 컴포지트 폰트는 Adobe 문자 컬렉션(Adobe-GB1, Adobe-CNS1, Adobe-Japan1, Adobe-Korea1, Adobe-KR)을 통해 CID에서 유니코드로, 이어 /CIDToGIDMap을 통해 임베디드 폰트 프로그램의 cmap 테이블로, 글리프에서 유니코드로 거꾸로 읽어 계속합니다. 심플 폰트는 WinAnsi, MacRoman, Standard, MacExpert 테이블로 폴백하고 마지막으로 같은 임베디드 cmap으로 갑니다. 체인을 소진한 코드는 0으로 해석됩니다
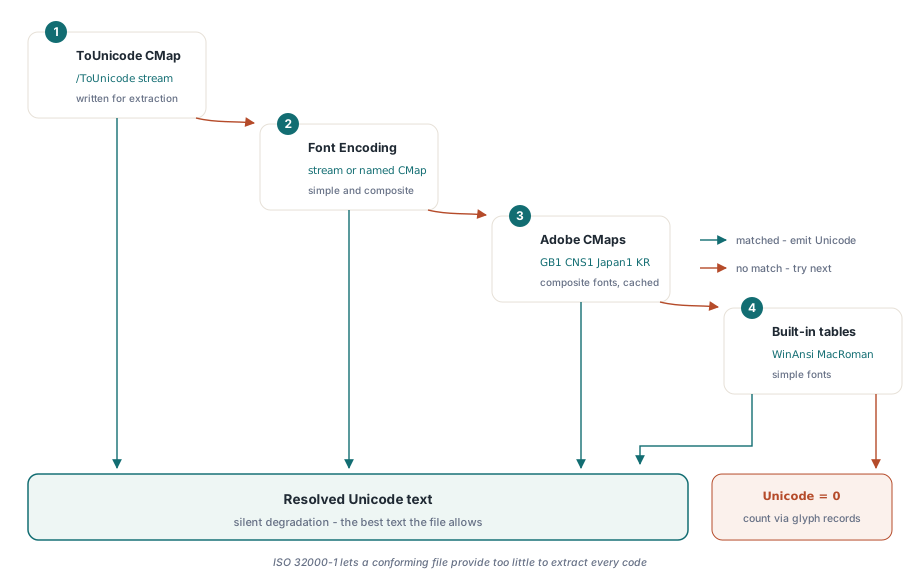
임베디드-cmap 단계가 /ToUnicode 없이 배송되는 많은 서브셋 폰트를 구하는 단계입니다. 폰트 프로그램에는 보통 자체 유니코드 cmap이 아직 들어 있고, 그것을 뒤집으면 텍스트 대부분이 회복됩니다. 다만 그것은 재구성입니다. 하나의 글리프를 공유하는 두 유니코드 문자는 cmap이 나열한 쪽으로 모두 돌아오므로, 회복된 텍스트는 검색과 인덱싱에 좋다고 치고, 법적 기록으로 쓰기 전에는 확인하세요
Adobe 컬렉션 데이터는 디스크에 삽니다. HotPDF는 resources\CMap 폴더 아래에 CMap과 cid2code.txt 파일을 실어 나르고, 프로세스당 파일을 최대 한 번 파싱해 결과를 캐시합니다. Adobe-GB1 맵 하나만 해도 페이지마다 파싱하고 싶지 않은 약 2MB의 텍스트입니다. 사전 정의된 CMap은 내장 테이블로도 존재하므로, UniGB-UTF16-H 같은 이름 붙은 CMap으로 인코딩된 폰트는 폴더 없이도 디코드됩니다. Identity-H CJK 폰트의 CID-유니코드 테이블은 폴더가 필요합니다. CMapResourcePath 속성이 컬렉션 하위 폴더를 담은 폴더를 이름 대고, 비워 두면 HotPDF는 실행 파일 곁과 그 위 한두 단계에서 resources\CMap을 찾습니다
Pdf := THotPDF.Create(nil);
try
  // Adobe-GB1-6, Adobe-CNS1-7, Adobe-Japan1-7 ...을 담은 폴더입니다
  Pdf.CMapResourcePath := 'C:\MyService\resources\CMap';
  Pdf.LoadFromFile(FileName);
  ...
finally
  Pdf.Free;
end;
서비스, ISAPI 모듈, 플러그인 DLL이라면 경로를 명시적으로 두세요. 그런 호스트에서 ParamStr(0)은 호스트 프로세스를 이름 대는데, 그것은 여러분이 배포한 폴더와 다른 경우가 많고, 폴더가 없어도 예외는 일어나지 않습니다. CJK 페이지가 컬렉션 테이블이 채웠을 구멍을 남긴 채 돌아올 뿐입니다. HotPDF의 복합 스크립트 텍스트 셰이핑이 같은 코드 대 글리프 분할을 쓰는 시점에서 만납니다
CMap 구문 함정 두 개
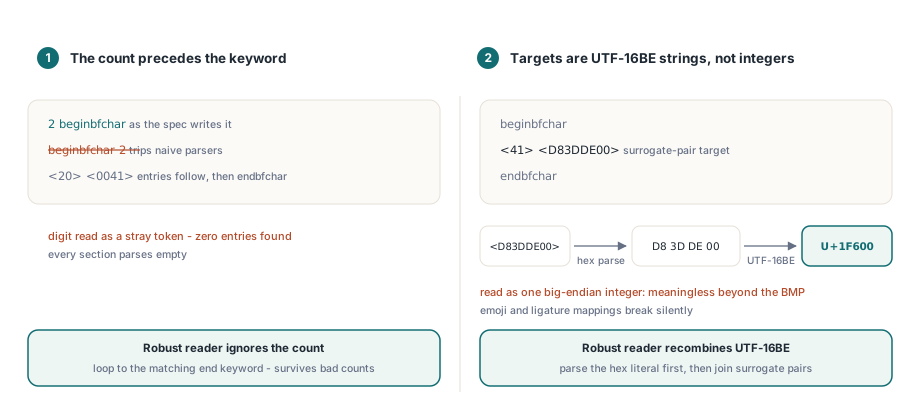
CMap 파일은 무난히 파싱될 것처럼 보이고, 두 디테일이 첫 시도 대부분을 넘어뜨립니다. 레코드 수는 섹션 키워드 앞에 옵니다. 섹션은 2 beginbfchar로 읽히지 beginbfchar 2가 아닙니다. 키워드 뒤의 수를 기대하는 파서는 그 숫자를 잡동사니 토큰으로 삼킨 뒤 모든 섹션에서 항목 0개를 발견합니다. HotPDF의 리더는 수를 완전히 무시하고 맞는 endbfchar나 endbfrange까지 루프하는데, 선언된 수가 틀린 실무 파일까지 견딥니다
두 번째 함정은 bfchar와 bfrange 대상이 UTF-16BE 문자열이라는 것입니다. 대상 <D83DDE00>은 U+1F600, 하나의 코드 포인트로 재조합해야 하는 서러게이트 쌍이며, 그 네 바이트를 빅엔디안 정수로 읽으면 기본 다국어 평면 밖의 모든 문자, 이모지 포함,에서 무의미한 값을 내놓습니다. HotPDF는 hex 리터럴을 먼저 날 바이트로 파싱한 다음 UTF-16BE 코드 유닛을 재조합하는데, 이는 합자 사상이 만드는 다중 문자 대상, 예컨대 하나의 fi 글리프가 두 글자로 사상되는 것,도 처리합니다
ExtractLoadedPageGlyphs로 미해결 글리프 세기
ExtractLoadedPageGlyphs(PageIndex, AGlyphs)는 텍스트 호출 아래의 글리프 레코드를 THPDFGlyphArray로 노출합니다. 각 THPDFGlyphRecord는 날 Code와 그것의 CodeByteWidth(CMap의 codespacerange가 정하는 1, 2, 4), 해석된 Unicode 코드 포인트와 합자를 위한 UnicodeSequence, 활성 FontKey와 FontSize, 사용자 공간 X, Y 원점, Advance, 네 코너 글리프 사각형, 그리고 단어 공백 규칙이 재는 기준인 글리프 자체 폭의 끝인 GlyphEndX / GlyphEndY를 나릅니다. 위치 잡은 하이라이트나 여러분만의 레이아웃 알고리즘에 충분한 데이터입니다
var
  Glyphs: THPDFGlyphArray;
  I, Unresolved: Integer;
begin
  if Pdf.ExtractLoadedPageGlyphs(0, Glyphs) then
  begin
    Unresolved := 0;
    for I := 0 to High(Glyphs) do
      if Glyphs[I].Unicode = 0 then
        Inc(Unresolved);
    if Unresolved > 0 then
      ShowMessageFmt('%d of %d glyphs have no Unicode mapping',
        [Unresolved, Length(Glyphs)]);
  end;
end;
Unicode = 0 레코드를 세는 것이 텍스트를 하류로 흘려보내기 전 문서를 판단하는 정직한 방법입니다. 그 수가 텍스트 호출이 보는 것과 조금 다를 것을 예상하세요. 이 호출은 페이지 자신의 콘텐츠 스트림의 모든 글리프를 반환합니다. 크롭 박스 밖의 것과 가성 볼드를 위해 칠해진 중복 포함이며, Form XObject로는 내려가지 않습니다. 각 레코드는 문자를 그 소스 피연산자에 묶는 TokenIndex, ItemIndex, ByteOffset도 저장합니다. 기존 PDF에서의 검색과 치환은 그 세 필드 위에 세워져 있습니다
줄 텍스트가 아예 없는 파일도 있습니다. 스캔된 페이지는 텍스트 연산자 없는 하나의 큰 이미지이므로 추출은 올바르게 빈 문자열을 반환하고, 앞으로 갈 길은 OCR입니다. 로드된 PDF에서 페이지 이미지 추출하기부터 시작하세요. 암호화된 문서는 LoadFromFile(FileName, Password)으로 열리면 정상적으로 추출됩니다. 스트림이 인터프리터가 읽기 전에 복호화되기 때문입니다. 폰트와 콘텐츠 스트림은 로드된 문서의 나머지와 같은 필터 체인으로 디코딩되고, 디코딩할 수 없는 /ToUnicode 스트림은 다음 전략으로 떨어지며 페이지의 나머지는 계속 추출됩니다. 같은 오브젝트 리더가 로드된 문서의 메타데이터 편집을 받치므로, 수집 패스 한 번에 텍스트를 읽고 메타데이터를 고칠 수 있습니다
읽기 흐름, 격자, 열, 구조 순서 추출과 글리프 수준 접근은 모두 외부 DLL이나 OS 텍스트 서비스 없는 순수 Object Pascal인 Delphi 및 C++Builder용 HotPDF Delphi Component에 실려 제공됩니다. 기묘한 파일이 큐에 도착했을 때 디코더로 들어가 각 코드에 어느 전략이 응답했는지 볼 수 있습니다