콘텐츠 스트림 조각 [(Reference)-333(Manual)] TJ는 두 단어 사이에 뚜렷한 간격을 그리지만 정작 공백 문자는 하나도 담고 있지 않습니다. 간격은 펜 이동입니다. ISO 32000-1 §9.4.3은 리더에게 Manual을 그리기 전 다음 글리프를 폰트 크기의 333/1000만큼 오른쪽으로 옮기라고 말합니다. 문자를 복사하고 기하를 무시하는 추출기는 ReferenceManual을 돌려주고, 그것을 먹인 검색 인덱스는 “Reference Manual”이라는 구문을 영영 못 맞춥니다. TeX 출력, 수많은 Distiller 파일, 대부분의 양쪽 정렬 레이아웃이 이런 식으로 단어를 갈라 놓습니다
줄바꿈은 반대쪽에서 엉터리가 됩니다. 올라간 윗첨자는 한 줄을 둘로 찢고, 비스듬한 DRAFT 워터마크는 글자 하나당 한 줄로 도착하며, 재단된 교정쇄는 어떤 뷰어도 표시하지 않는 printer’s slug line으로 시작합니다. 이 파일들 중 깨진 것은 하나도 없습니다. 각자 문자 복사식 추출기가 오해하는 합법적인 텍스트 배치 방식을 쓸 뿐입니다
글리프 기하에서 재건한 워드 스페이스
HotPDF Delphi Component의 THotPDF.ExtractLoadedPageText는 단어 경계를 글리프 위치로 판정하고, 스트림 안의 공백 문자는 그것이 읽는 신호 중 하나일 뿐입니다. 이전 glyph’s writing direction을 따라 그 glyph’s own width의 끝부터 현재 글리프의 원점까지 거리를 재고, 그 거리가 사용자 공간에서 ascent부터 descent까지 잰 현재 glyph’s box height의 0.15를 넘으면 공백 하나를 넣습니다. 위의 TJ 조각에서 1/3 em은 평범한 텍스트 폰트라면 그 선을 여유 있게 넘으므로 페이지 텍스트는 Reference Manual로 읽힙니다
공백을 보류하는 조건이 둘 있습니다. 지금까지의 텍스트가 이미 공백으로 끝나거나 다음 글리프가 공백이면(스페이스, 탭, no-break space, 전각 스페이스) 아무것도 더하지 않으므로 공백을 실제로 쓰는 생산 도구가 공백 두 배를 얻는 일은 없습니다. CJK 문자 둘 사이에도 더하지 않습니다. 한자, 가나, 한글, 전각 형태가 모두 해당하는데, 조판은 중국어·일본어 줄을 단어 경계와 무관하게 벌리기 때문입니다. 이 둘과 별도로 높이 0의 글리프 상자는 Tf 크기를 높이로 대신 씁니다. 규칙이 쓰는 모든 숫자는 글리프 레코드에 저장되므로 간격이 이상한 파일은 글리프 단위로 재현해 볼 수 있습니다
uses
  SysUtils, HPDFDoc, HPDFContentStream;

// ExtractLoadedPageText가 공백으로 바꿀 간격들을 출력한다.
// 수평 텍스트 전용. ExtractLoadedPageGlyphs는 Form XObject 텍스트와
// crop 필터가 빠진 페이지 콘텐츠 스트림을 돌려준다
procedure DumpWordGaps(Pdf: THotPDF; PageIndex: Integer);
var
  Glyphs: THPDFGlyphArray;
  I: Integer;
  Height, Gap: Double;
begin
  if not Pdf.ExtractLoadedPageGlyphs(PageIndex, Glyphs) then
    Exit;
  for I := 1 to High(Glyphs) do
  begin
    if Glyphs[I].Vertical or Glyphs[I - 1].Vertical then
      Continue;
    // 글리프 상자의 ascent-descent 높이, 사용자 공간 기준
    Height := Sqrt(Sqr(Glyphs[I].QuadX[3] - Glyphs[I].QuadX[0]) +
      Sqr(Glyphs[I].QuadY[3] - Glyphs[I].QuadY[0]));
    if Height <= 0 then
      Height := Abs(Glyphs[I].FontSize);
    // 이전 글리프 자체 폭의 끝부터의 간격
    Gap := Glyphs[I].BaselineStartX - Glyphs[I - 1].GlyphEndX;
    if (Height > 0) and (Gap > 0.15 * Height) then
      Writeln(Format('U+%.4x gap %.2f height %.2f: space',
        [Glyphs[I].Unicode, Gap, Height]));
  end;
end;
펜 위치가 아니라 glyph’s own width에서 재는 이유
글리프 뒤의 펜 위치에는 단어 경계와 무관한 간격이 이미 포함돼 있기 때문입니다. ISO 32000-1 §9.4.4는 수평 변위를 글리프 폭 × 폰트 크기 + 문자 간격 Tc + 워드 스페이스 Tw로 정의하고 모두 수평 스케일링 Tz를 곱합니다. 각 글리프 레코드는 양 끝을 모두 들고 있습니다. BaselineEndX / BaselineEndY는 그 전체 변위를 담고, GlyphEndX / GlyphEndY는 현재 크기와 Tz만 적용한 font’s advance만 담습니다. 음의 Tc로 트래킹을 조이고 글리프마다 TJ 조정으로 간격을 되돌려 주는 파일에서 둘은 갈라집니다. 펜에서 재면 그 되돌림마다 갭처럼 보여서 중국어 표현 “95后”가 “9 5 后”로 흩어집니다. glyph’s own width에서 재면 조정은 Tc가 가져간 것을 돌려줄 뿐이고 표현은 온전히 유지됩니다
임계값이 Tf 크기 대신 글리프 상자 높이에 묶인 데에는 짝이 되는 이유가 있습니다. Word는 흔히 1 Tf를 쓰고 실제 크기를 스케일된 Tm에 실으므로 폰트 크기 피연산자는 1인데 텍스트는 10포인트입니다. 그 피연산자에 묶인 규칙은 그런 페이지에서 임계값을 0.15포인트에 두고 평범한 커닝 쌍이 단어 경계로 읽히기 시작합니다. 상자 높이는 모든 행렬이 적용된 뒤에 잰 것이므로 스케일된 행렬을 얹은 1 Tf와 평범한 10 Tf가 같은 텍스트를 냅니다
엣지 케이스 둘은 기하에서 곧장 나옵니다. 아주 느슨한 자간으로 놓인 제목, 곧 Tc 하나만으로 글자 사이가 텍스트 높이의 0.15를 넘어서는 제목은 S P A C E D로 추출됩니다. 페이지가 보이는 그대로이고, 어느 넓은 간격이 트래킹이고 어느 것이 단어인지 추측하는 휴리스틱을 얹는 것보다 그대로 돌려주는 편을 택합니다. 그런 추측은 촘촘히 정렬된 단에서 진짜 단어 경계를 삼키기 시작하고, 검색에는 그쪽 실패가 더 나쁩니다. 한 베이스라인 위에서 순서 어긋나게 그려진 조각은 음의 간격을 만들어 공백 없이 붙습니다. 본문 흐름에서는 드문 사례입니다
추출 텍스트에서 새 줄은 언제 시작되는가
ExtractLoadedPageText는 이전 glyph’s origin에서 현재 origin으로의 이동을 이전 쓰기 방향의 법선에 사영한 값이 두 글리프 중 더 큰 상자 높이의 절반을 넘을 때 새 줄을 엽니다. 베이스라인을 따라가는 이동은 펜이 아무리 멀리 뛰어도 줄바꿈으로 안 칩니다
날 Y 이동을 Tf 크기의 절반과 비교하는 규칙은 두 방향으로 실패합니다. 1 Tf와 스케일된 Tm에서는 임계값이 반 단위로 줄어들어 0.4의 텍스트 rise로 올린 윗첨자도 줄을 끊습니다. 일부 조판 엔진이 런 사이에 남기는 작은 베이스라인 떨림도 그렇습니다. 같은 규칙은 X를 전혀 보지 않습니다. 그 비스듬한 워터마크처럼 회전된 Tm 아래의 텍스트는 글리프마다 페이지를 내려가며 글자당 한 줄로 나오는데, 사영은 45도 런을 수평 런과 똑같이 취급합니다
두 높이 중 큰 쪽을 택하는 것이 중요해지는 경우는 한 줄에 크기가 섞일 때입니다. 36포인트 전시 단어 뒤에 몇 포인트 아래 8포인트 캡션이 이어지면 큰 글리프’s height의 절반을 기준으로 판정해 쌍이 붙어 있고, 작은 글리프만 기준으로 삼으면 캡션이 자기 줄로 떨어집니다. 텍스트 rise는 글리프 원점의 일부라 superscript’s raised baseline 역시 그 같은 절반 높이와 비교되는 것입니다
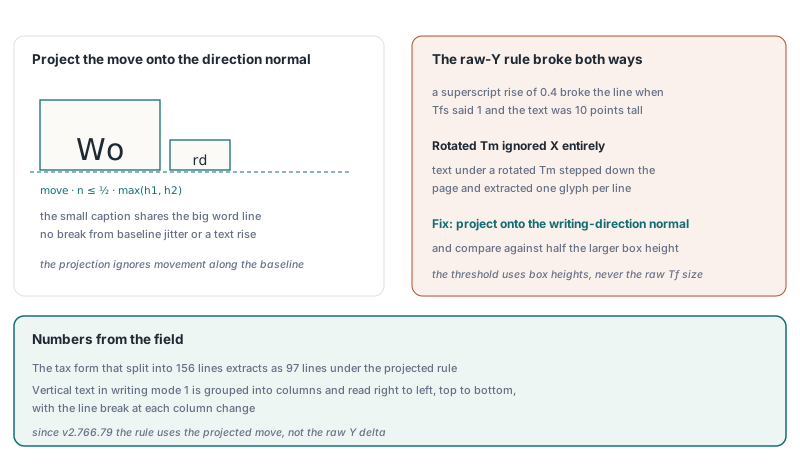
쓰기 모드 1(§9.7.4.3)의 수직 텍스트는 별도 경로를 따릅니다. 그 글리프들은 원점 X를 기준으로 폰트 크기의 절반을 열 허용오차 삼아 열로 묶인 뒤 오른쪽에서 왼쪽으로, 위에서 아래로 읽히고 열이 바뀔 때마다 줄바꿈이 옵니다. 수직 일본어 본문과 수평 러닝 헤더를 섞은 페이지도 두 방향이 전환될 때마다 줄바꿈을 받습니다
어떤 글리프가 페이지 텍스트에 들어가는가
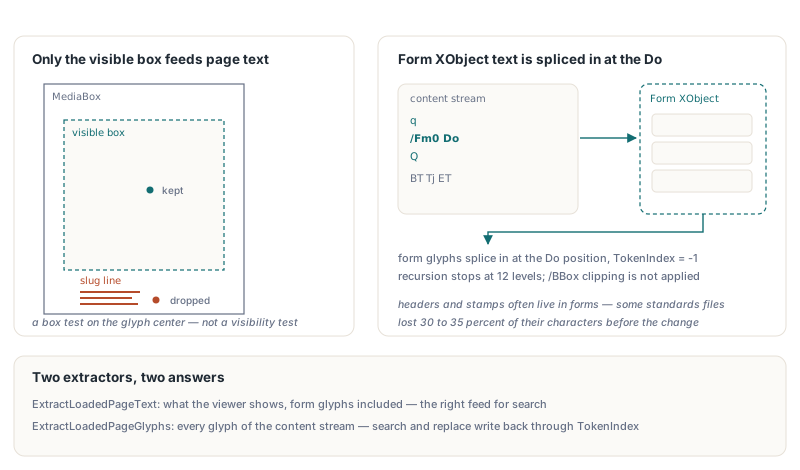
ExtractLoadedPageText는 뷰어가 보여주는 텍스트를 돌려줍니다. MediaBox로 잘린 CropBox, 곧 GetLoadedPageVisibleBox(§14.11.2) 안에 상자 중심이 떨어지는 글리프만 유지하므로, 재단 영역 밖에 텍스트로 세팅된 slug line과 그 외 printer’s marks는 떨어져 나옵니다. 필요한 작업을 위해 ExtractLoadedPageGlyphs는 slug line까지 포함해 페이지 콘텐츠 스트림의 모든 글리프를 계속 돌려줍니다. 필터는 글리프당 점 하나에 대한 기하 검사입니다. 클리핑 패스에 가려진 텍스트, 흰색으로 그린 텍스트, 이미지에 덮인 텍스트도 나옵니다. 진짜 가시성을 판정하려면 페이지를 렌더링해야 하기 때문입니다
uses
  SysUtils, HPDFDoc, HPDFContentStream;

var
  Pdf: THotPDF;
  Raw, Merged: THPDFGlyphArray;
  PageText: UnicodeString;
  L, B, R, T: Single;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.LoadFromFile('trimmed-proof.pdf');
    if Pdf.GetLoadedPageVisibleBox(0, L, B, R, T) then
      Writeln(Format('Visible box: %.1f %.1f %.1f %.1f', [L, B, R, T]));
    // slug line까지 포함한 페이지 콘텐츠 스트림의 모든 글리프
    if Pdf.ExtractLoadedPageGlyphs(0, Raw) then
      Writeln(Length(Raw), ' glyphs in the page content stream');
    // crop 이전, 그리기 순서대로 페이지 스트림 + Form XObject 텍스트
    if Pdf.ExtractLoadedPageGlyphsWithForms(0, Merged) then
      Writeln(Length(Merged), ' glyphs including forms');
    // 페이지가 보여주는 것: 폼 삽입, crop 밖 글리프 제외
    if Pdf.ExtractLoadedPageText(0, PageText) then
      Writeln(PageText);
    // 필터 전 스트림에 같은 간격 규칙을 적용해 diff 용으로
    Writeln(HPDFAssemblePageText(Raw));
  finally
    Pdf.Free;
  end;
end.
Form XObject를 통해 그려진 텍스트도 페이지 텍스트의 일부입니다. 헤더, 스탬프, 워터마크는 아주 흔히 폼 안에 살고 페이지 콘텐츠 스트림만 읽는 추출기는 그것들을 영영 못 봅니다. HotPDF는 각 Do를 그 시점의 CTM과 함께 기록해 두었다가 폼을 /Matrix × 그 CTM으로 해석하고(§8.10.1) form’s glyphs를 Do 위치에 끼워 넣으며 중첩 폼으로 재귀합니다. 자체 /Resources가 없는 폼은 자신을 그리는 스트림의 것을 빌리는데, §7.8.3이 기술하는 예전 배치입니다. 중심이 form’s /BBox 밖으로 나가는 글리프는 제외됩니다. 그 상자가 폼이 그려질 때 폼을 클리핑하기 때문입니다. 직접이든 다른 폼을 통해서든 자기 자신을 그리는 폼은 두 번째로 들어가지 않고 중첩은 12단계에서 멈춥니다
폼 글리프는 TokenIndex = -1과 ItemIndex = -1을 실어 다닙니다. ExtractLoadedPageGlyphs가 페이지 스트림 글리프에 머무는 이유도 같습니다. 검색·치환·redaction이 변경 사항을 TokenIndex로 되돌려 쓰는데 그 배열 안의 폼 글리프가 다른 스트림의 바이트를 가리켜 버립니다. 글리프 수준의 병합 목록이 필요하면 ExtractLoadedPageGlyphsWithForms가 visible-box 필터가 돌기 전 그리기 순서대로 돌려줍니다
간격 규칙 전에 한 패스가 더 돕니다. 같은 텍스트를 작은 오프셋으로 두 번 그려 만든 과다 인쇄 로고와 가짜 볼드는 그렇지 않으면 모든 글자가 두 배로 추출됩니다. 어떤 글리프가 앞선 글리프와 같은 문자를 같은 크기로, 베이스라인을 따라 그 크기의 1/10 이내, 그 수직으로 1/5 이내에서 그리면 한 벌만 남고, 공백은 이런 식으로 절대 제거되지 않습니다. 텍스트 추출의 가짜 볼드와 중복 글리프 글이 그 사례를 자세히 걸어 보입니다
q와 Q를 넘나드는 텍스트 상태
q에서 CTM만 저장하는 추출기라면 Q 뒤의 텍스트를 엉터리 디코딩합니다. 폰트, 크기, Tc, Tw, Tz, TL, 렌더링 모드, rise 등 텍스트 상태 매개변수는 그래픽 상태에 속하고(§9.3.1), 그러므로 Q는 스택의 나머지 전부와 함께 그것들을 복원해야 합니다(§8.4.2). 실수를 빨리 드러내는 패턴이 하나 있습니다. 표 셀 하나를 위해 2바이트 Identity-H 폰트가 q … Q 안에서 선택되고, Q 뒤의 텍스트가 자체 Tf 없이 1바이트 WinAnsi 문자열을 보여줍니다. 안쪽 폰트를 유지한 인터프리터는 그 바이트들을 쌍으로 읽고 목차의 점 리더가 엉뚱한 CJK 문자열로 변합니다. HotPDF 인터프리터는 모든 q에서 텍스트 상태 여덟 값을 CTM과 함께 푸시하고 모든 Q에서 팝합니다
위의 모든 것은 모든 페이지에 적용되므로 문서 전체가 한 번의 호출로 UTF-8 파일에 갈 수 있습니다. ExtractLoadedPagesTextToStream은 1 기반 페이지 범위(빈 문자열은 모든 페이지), 페이지 사이에 기록되는 구분자, 바이트 순서 표식 플래그를 받고 추출한 페이지 수를 돌려줍니다. 출력은 stream’s current position에 append되므로 one page’s text보다 큰 것이 메모리에 머무는 일은 없습니다
uses
  SysUtils, Classes, HPDFDoc;

var
  Pdf: THotPDF;
  Output: TFileStream;
  Pages: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.LoadFromFile('report.pdf');
    Output := TFileStream.Create('report.txt', fmCreate);
    try
      // 빈 범위 = 모든 페이지. 페이지 사이 form feed. UTF-8 BOM
      Pages := Pdf.ExtractLoadedPagesTextToStream(Output, '', #12, True);
      Writeln(Pages, ' pages extracted');
    finally
      Output.Free;
    end;
  finally
    Pdf.Free;
  end;
end.
작업에 맞는 텍스트 API 고르기
검색과 인덱싱에는 ExtractLoadedPageText가 맞는 먹이입니다. 콘텐츠 스트림 순서를 따르고 페이지가 보여주는 것을 반영합니다. 그 아래의 디코딩 사슬, /ToUnicode 맵부터 CID 폰트까지는 HotPDF로 로드된 PDF에서 텍스트 추출하기에서 다룹니다. 콘텐츠 스트림 순서가 가장 약한 곳은 running header를 마지막에 쓰거나 두 단을 끼워 놓은 태그 문서입니다. 그런 문서는 구조 순서 텍스트 추출이 기하에서 추측하는 대신 구조 트리를 저작 순서로 걷습니다. 표에 갇힌 데이터는 페이지 나눔을 넘는 타입 인지 표 추출이 더 잘 처리하며 셀과 값을 함께 돌려줍니다. 페이지를 편집하는 코드는 ExtractLoadedPageGlyphs에 가야 합니다. 토큰 인덱스가 앞으로 다시 쓸 바이트를 가리키고 있으니까요
이 예제에 쓴 글리프 레코드 필드와 나머지 텍스트 추출 API, 그리고 평가판 빌드는 HotPDF Delphi PDF Component 제품 페이지에 문서화되어 있습니다