뷰어의 찾기 상자는 인보이스 2페이지에서 "Acme Corp"를 하이라이트하는데, 압축을 푼 페이지 스트림에서 같은 아홉 글자를 바이트 검색하면 빈 결과가 돌아옵니다. 첫 단어만 해도 스트림에는 <0024004600500048> Tj 같은 것이 들어 있을 수 있습니다. 임베디드 서브셋 폰트의 2바이트 글리프 코드이고, 두 단어 사이의 간격은 공백 문자가 아니라 위치 오프셋이 만들어 낸 것입니다. 그 이름을 바꾸려면 그 코드들을 유니코드로 디코딩하고, 거기서 매치하고, 그 히트를 만들어 낸 정확한 바이트로 거슬러 올라가, 같은 폰트가 이해할 새 코드를 써야 합니다. 서브셋이 새 텍스트에 필요한 글리프를 한 번도 담은 적이 없다면 쓸 코드 자체가 없습니다
이 뒤에 있는 요청들은 평범한 문서 관리입니다. 회사가 이름을 바꿨는데 보관된 인보이스 3천 장이 여전히 낡은 이름을 달고 있습니다. 계약서 템플릿이 작년 만료일로 나갔습니다. 단종된 부품 번호를 모든 데이터시트에서 후속 번호로 바꿔야 합니다. 워드 프로세서에서는 각각 30초짜리 일이지만, PDF에서는 페이지가 실제로 저장되는 방식과 정면충돌합니다
PDF 페이지가 텍스트 대신 저장하는 것
PDF 페이지는 편집 가능한 텍스트가 아니라 위치가 정해진 글리프를 담습니다. ISO 32000-1 §9.4 아래에서 콘텐츠 스트림은 Tj와 TJ 같은 텍스트 표시 연산자를 구동하며, 이들은 텍스트 행렬이 정한 위치에 문자 코드 나열을 칠합니다. 그 코드들은 현재 폰트가 선언한 인코딩에 대한 인덱스입니다. 읽을 수 있는 문자로 돌아가는 길은 /ToUnicode CMap(§9.10.3), /Differences 배열을 지닌 /Encoding, Type0 폰트의 CID 매핑 체인을 지날 수 있습니다. 문단 객체도 텍스트 흐름도 없고, 생산자가 보이는 한 단어를 하나의 문자열로 저장할 의무도 없습니다. [(Ac) -12 (me)] TJ는 단어를 커닝하는 완전히 평범한 방식입니다
치환은 디코딩 위에 두 번째 요구를 얹습니다. 텍스트 추출기는 유니코드만 뽑아내면 바이트 위치를 버려도 됩니다. 치환기는 그것이 필요합니다. 어떤 문자열 피연산자의 어떤 바이트가 각 글리프를 만들었는지 알아야 정확히 그 범위만 다시 쓰고 나머지는 그대로 둘 수 있기 때문입니다. 그래서 우연히 WinAnsi 인코딩을 쓰는 파일이라 해도 스트림 바이트에 대한 단순 StringReplace는 잘못된 도구입니다. 어느 (가 문자열에 속하는지, 어느 Tf가 그 바이트들에 의미를 부여하는 폰트를 고르는지 알 길이 없습니다
디코딩된 글리프 시퀀스 검색하기
HotPDF Delphi Component는 SearchLoadedPageText와 SearchLoadedDocumentText로 로드된 문서를 검색하며, 검색어를 각 페이지의 디코딩된 유니코드 글리프 시퀀스와 대조하지 결코 raw 스트림 바이트와 대조하지 않습니다. 따라서 폰트가 어떻게 인코딩했든 히트는 히트입니다. 디코딩하는 동안 모든 글리프는 자기가 나온 문자열 피연산자, TJ 배열 항목, 바이트 오프셋의 기록을 유지하는데, 이것이 나중 치환 단계가 기대는 것입니다. 같은 글리프 인터프리터가 로드된 PDF에서 텍스트 추출하기가 다루는 API를 구동하고, 검색은 추출이 버리는 소스 위치만 쥐고 있을 뿐입니다
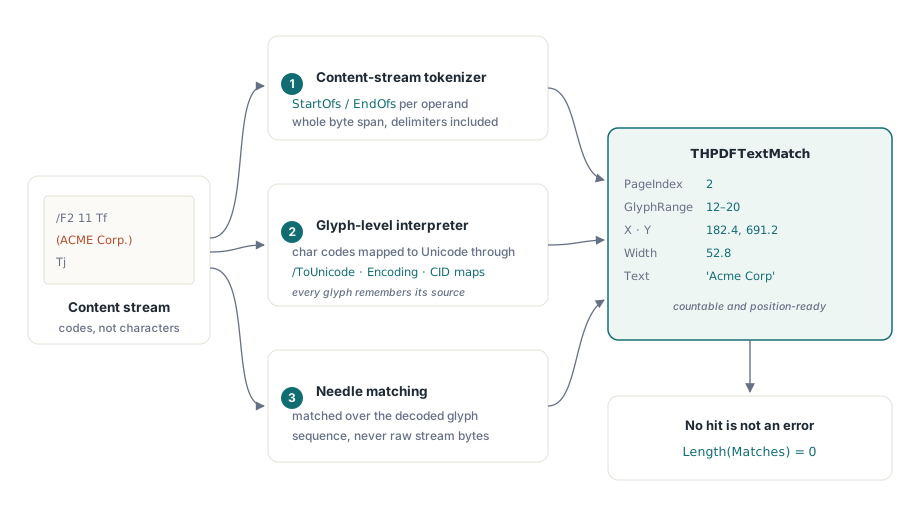
각 히트는 THPDFTextMatch 레코드로 돌아옵니다. PageIndex, GlyphStart와 GlyphEnd의 포함 글리프 범위, X와 Y의 사용자 공간 원점, 히트의 Width, 소스 TokenIndex와 ItemIndex, 그리고 매치된 Text입니다. PageIndex는 0 기반입니다. 존재하지 않는 검색어는 빈 배열과 True 결과를 주므로 호출 코드에 "못 찾음" 특수 사례가 필요 없습니다
var
  Pdf: THotPDF;
  Matches: THPDFTextMatchArray;
  I: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('invoices-2025.pdf') > 0 then
      if Pdf.SearchLoadedDocumentText('Acme Corp', False, Matches) then
        for I := 0 to High(Matches) do
          WriteLn(Format('page %d at (%.1f, %.1f), width %.1f: "%s"',
            [Matches[I].PageIndex + 1, Matches[I].X, Matches[I].Y,
             Matches[I].Width, Matches[I].Text]));
  finally
    Pdf.Free;
  end;
end;
그 루프가 무언가를 인쇄할지는 무엇보다 공백이 결정합니다. 검색 텍스트는 페이지가 실제로 칠한 글리프에서 글리프당 문자 하나로 만들어지고, 두 단어를 시각적으로 떼어놓는 TJ 오프셋은 글리프가 아니라 배열 속의 숫자입니다. 단어 간격을 공백 문자 대신 오프셋으로 잡은 생산자의 글리프 시퀀스는 "AcmeCorp"이고, 검색어 "Acme Corp"는 그것과 매치되지 않습니다. 보이는 구절이 매치를 거부하면 가장 긴 단어 하나만 먼저 검색하고 돌아온 것의 Text를 들여다보세요
대소문자가 두 번째 확인 대상입니다. CaseSensitive를 False로 두면 Delphi XE2 이상 빌드는 로캘과 무관한 유니코드 simple lowercase 매핑으로 문자를 비교하므로, É가 é와 매치되고 그리스어나 키릴 대문자도 소문자 형태와 매치됩니다. 더 오래된 컴파일러의 빌드는 A–Z만 접습니다. 매핑은 문자 하나에 문자 하나라서 검색어의 각 위치가 정확히 하나의 글리프와 정렬되고, 그 대가로 ß는 SS와 매치되지 않습니다. 단어 단위 UI 흐름에는 SearchLoadedPageTextWholeWord가 더 긴 단어 안에 앉은 히트를 떨어뜨리고, GetLoadedSearchHitRect는 매치를 하이라이트를 그릴 하나의 사각형으로 바꿉니다
검색과 치환은 모두 페이지 자신의 /Contents 스트림에서 동작합니다. 많은 도구가 도장 찍은 머리글과 바닥글을 넣어 두는 Form XObject 안에서 칠해지는 텍스트는 페이지가 Do로 부르는 별도의 스트림에 살고, 두 연산 모두의 밖입니다
ReplaceLoadedDocumentText로 매치된 바이트 다시 쓰기
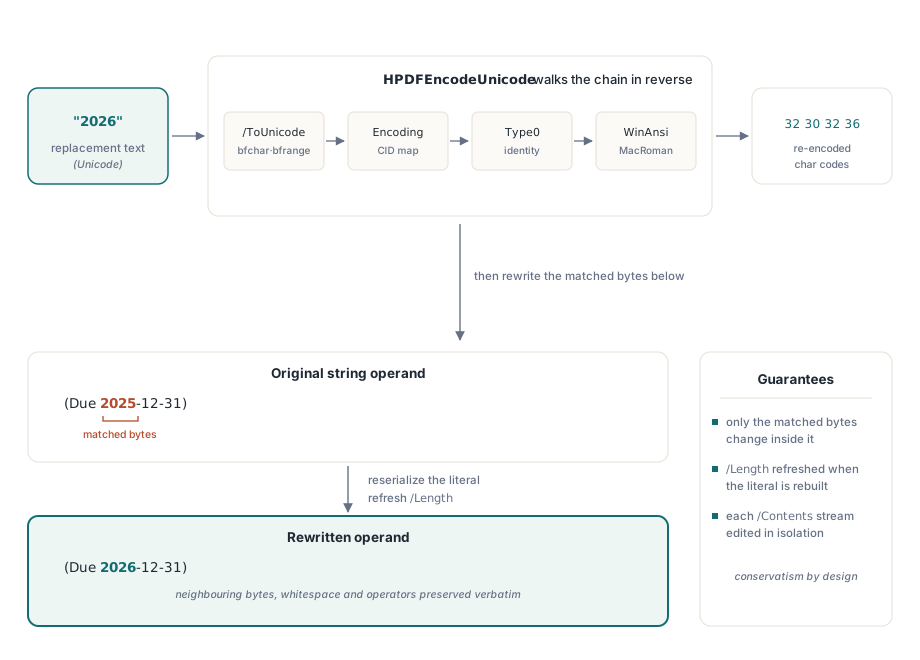
ReplaceLoadedPageText와 ReplaceLoadedDocumentText는 폰트 디코딩을 거꾸로 돌려 검색어의 모든 출현을 다시 씁니다. 각 치환 문자는 디코더가 쓰는 것과 같은 체인을 반대로 통과합니다. /ToUnicode의 bfchar와 bfrange 항목, Type0 폰트의 CID 매핑, 동일 매핑, 미리 정의된 WinAnsi와 MacRoman 테이블이 그 대상입니다. 결과 char 코드는 리터럴 문자열로, 어떤 바이트든 인쇄 가능한 ASCII 밖이면 16진수 문자열로 다시 쓰이며, 콘텐츠 스트림 파서가 읽는 것과 같은 이스케이프 규칙을 따릅니다
매치가 커버하는 바이트만 바뀝니다. 같은 피연산자의 매치되지 않은 바이트, 토큰 사이의 공백, 주석, 주변의 모든 연산자는 그대로 지나갑니다. abcabc 안의 bca를 바꾸면 a + 치환 + bc가 됩니다. 치환은 검색어보다 짧아도 길어도 되며, 페이지 /Contents 배열의 각 스트림은 독립적으로 처리되므로 페이지는 계속 잘 만들어진 상태를 유지합니다. Hello가 [(He) -20 (llo)] TJ로 저장된 것처럼 매치가 여러 문자열 피연산자에 걸치면, 치환은 매치가 시작된 피연산자에 기록되고 뒤따르는 피연산자들에서는 매치된 바이트가 제거됩니다
var
  Pdf: THotPDF;
  Rewrites: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('contract-draft.pdf') > 0 then
    begin
      if Pdf.ReplaceLoadedDocumentText('2025-12-31', '2026-12-31',
        True, Rewrites) then
        WriteLn(Format('%d operand rewrites', [Rewrites]));
      Pdf.SaveLoadedDocument('contract-final.pdf');
    end;
  finally
    Pdf.Free;
  end;
end;
페이지는 다음 조판되지 않습니다. PDF에는 reflow가 없으므로 원본보다 넓은 치환은 그저 가로 공간을 더 차지하고 오른쪽에 칠해진 것과 부딪힐 수 있습니다. 다음 글리프의 위치는 생산자가 정해 둔 것이라 움직이지 않습니다. 날짜, 버전 문자열, 부품 번호, 비슷한 길이의 맞춤법 수정이 이 메서드가 노린 작업입니다. 문단을 다시 쓰는 일은 하류 전부를 다시 조판해야 하므로, 그 변경은 소스 문서의 몫입니다
폰트 서브셋은 한 번도 담지 않은 문자를 왜 받지 못할까?
임베디드 서브셋이 한 번도 포함하지 않은 치환 문자에게는 되돌아갈 char 코드가 없습니다. 생산자가 폰트를 서브셋하면 /ToUnicode CMap과 인코딩은 원본 문서가 쓴 글리프만 커버하고, 나머지 전부의 글리프 외곽선은 파일에 없습니다. 그 문서가 그 폰트로 대문자 E를 한 번도 인쇄하지 않았다면, 그것을 고르는 바이트 시퀀스는 존재하지 않습니다. 이 한계는 치환을 수행하는 도구가 아니라 파일 안에 앉아 있습니다
ReplaceLoadedDocumentText는 인코딩 불가능한 치환을 보수적으로 다룹니다. 문자 하나라도 재인코딩할 수 없으면 그 출현은 통째로 건너뜁니다. 예외도 없고 절반만 바뀐 문자열도 없으며 원본 텍스트는 읽을 수 있게 남습니다. 위 날짜 예제에서는 그 재작성이 성공하려면 숫자 6이 같은 폰트 어딘가에 존재해야 합니다. 폰트가 "2025"와 6이 없는 몇 개의 주문 합계만 인쇄했다고 해 봅시다. 날짜는 그대로 머뭅니다
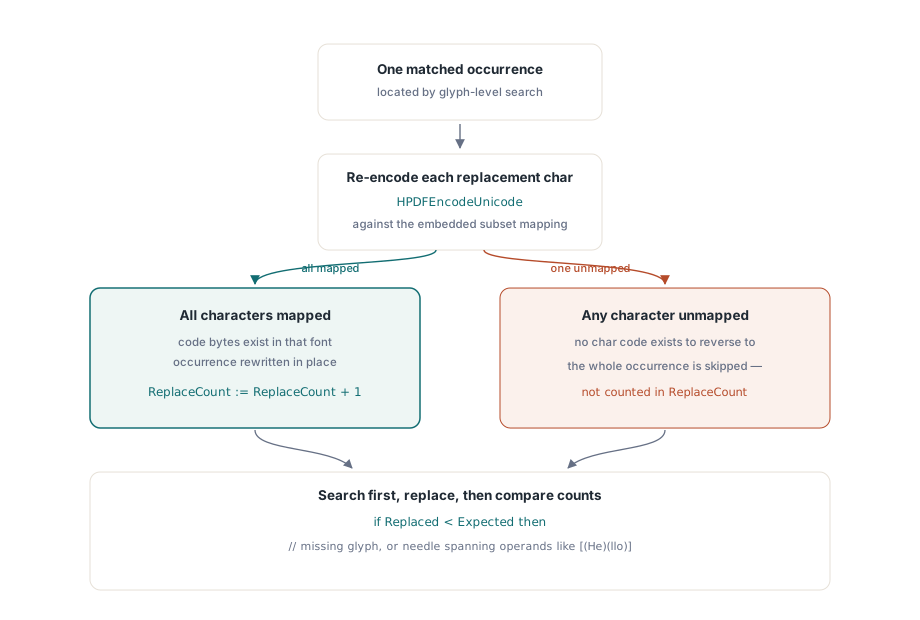
ReplaceCount는 피연산자 재작성 수를 보고하고, 여러 피연산자에 걸친 매치는 재작성 두 개 이상으로 잡힐 수 있습니다. 히트 수보다 낮은 카운트는 여전히 무언가가 건너뛰어졌다는 뜻이지만, 정확한 답은 치환 뒤의 재검색에서 나옵니다. 두 번째 검색이 찾는 것이 페이지와 위치가 붙은 채 남은 것입니다
procedure ReplaceAndAudit(Pdf: THotPDF; const OldText, NewText: UnicodeString);
var
  Before, After: THPDFTextMatchArray;
  Rewrites, I: Integer;
begin
  // 재검색은 NewText 자체가 OldText를 담지 않을 때만 통한다
  Pdf.SearchLoadedDocumentText(OldText, True, Before);
  Pdf.ReplaceLoadedDocumentText(OldText, NewText, True, Rewrites);
  Pdf.SearchLoadedDocumentText(OldText, True, After);
  WriteLn(Format('%d found, %d operand rewrites, %d left',
    [Length(Before), Rewrites, Length(After)]));
  for I := 0 to High(After) do
    WriteLn(Format('  left on page %d at (%.1f, %.1f)',
      [After[I].PageIndex + 1, After[I].X, After[I].Y]));
end;
서브셋이 부족할 때: 새 폰트로 미리보기와 적용
바이트 수준 방법이 인코딩할 수 없는 출현에는 PreviewLoadedPageTextReplacement와 ApplyLoadedPageTextReplacement가 다른 길을 갑니다. 매치된 글리프를 제거하고 여러분이 고른 폰트로 원본 크기, 원본 베이스라인에 치환을 그 자리에 그리는 것입니다. 기본 THPDFLoadedTextReplacementOptions는 매치된 텍스트의 폰트 크기로 Arial을 쓰고, 상자를 매치된 텍스트의 폭으로 잡으며, Atomic을 켜 둡니다. 그러면 페이지의 단일 거부 매치가 나머지를 롤백합니다. 미리보기는 매치당 결과 하나씩 든 계획을 반환하고, 각 결과는 Status를, 거부 시 Reason을 실립니다
var
  Opts: THPDFLoadedTextReplacementOptions;
  Plan, Applied: THPDFLoadedTextReplacementPlan;
  I: Integer;
begin
  // Pdf는 로드된 THotPDF; PageIndex는 감사가 지적한 0 기반 페이지
  Opts := THPDFLoadedTextReplacementOptions.Default;
  Opts.Appearance.FontName := 'Arial';
  Opts.Appearance.OverflowPolicy := ltopShrinkToFit;
  Opts.Appearance.MinFontSize := 6;
  if not Pdf.PreviewLoadedPageTextReplacement(PageIndex, 'Acme Corp',
    'Apex Corporation', True, Opts, Plan) then
    for I := 0 to High(Plan.Results) do
      if Plan.Results[I].Status = ltrsRejected then
        WriteLn(Format('match %d at (%.1f, %.1f): %s',
          [I, Plan.Results[I].X, Plan.Results[I].Y, Plan.Results[I].Reason]));
  if (Plan.RejectedCount = 0) and (Plan.ReadyCount > 0) then
  begin
    Pdf.ApplyLoadedPageTextReplacement(Plan, Applied);
    WriteLn(Format('%d of %d matches applied',
      [Applied.AppliedCount, Applied.MatchedCount]));
  end;
end;
거부 이유는 페이지 기하와 직결되므로 인쇄해 둘 가치가 있습니다. 한 텍스트 줄에서 다음 줄로 넘어가는 매치는 거부되고, 수직 텍스트도 그렇습니다. 기본 ltopReject 오버플로 정책에서는 매치된 폭에 맞지 않는 치환도 거부됩니다. ltopShrinkToFit은 대신 크기를 MinFontSize 쪽으로 낮추는데, 예제가 검색어보다 다섯 글자 긴 치환에 이것을 설정한 이유입니다. 고른 폰트가 보여줄 수 없는 문자를 담은 치환 역시 거부됩니다
계획은 페이지 콘텐츠와 폰트의 지문을 실립니다. 미리보기와 적용 사이에 페이지를 바꾸는 것이 하나라도 있으면 ApplyLoadedPageTextReplacement는 미리보기가 본 적 없는 페이지에 쓰는 대신 EInvalidOpException을 raise합니다. 불균형한 q/Q나 BT/ET 쌍을 지닌 페이지와 서명 필드를 지닌 문서는 EArgumentException을 raise합니다. 서명된 문서는 증분 업데이트가 필요한 일이므로 서명된 리비전이 온전히 유지됩니다
바이트 수준 치환이 먼저 가고, 폰트 교체 경로는 감사가 아직 낡은 텍스트를 발견하는 페이지에서만 돕니다. 바이트 수준 재작성은 원본 폰트와 그 메트릭, 커닝을 유지하므로 편집된 텍스트가 줄 위의 이웃들과 어울립니다. 미리보기 경로는 다른 서체로 그리므로, 콘덴스드나 세리프 폰트로 짜인 줄에서는 눈 밝은 독자가 변화를 봅니다. 목표가 문구 교체가 아니라 텍스트를 없애는 것이라면 진짜 콘텐츠 제거가 더 나은 도구입니다. Delphi에서 로드된 PDF의 레닉션과 구조 변경이 그 경로를 다룹니다
저장된 파일에서 무엇이 바뀌나
ReplaceLoadedPageText가 편집한 콘텐츠 스트림은 압축되지 않은 상태로 저장됩니다. 편집을 위해 스트림을 디코딩하고, 재구성된 바이트를 되쓸 때 /Filter와 /DecodeParms 항목을 떼어 내고 /Length를 갱신합니다. PDF는 유효하고 정상 렌더링됩니다. 대가는 편집된 스트림마다 커지는 파일입니다. 수천 장의 인보이스를 도는 배치 잡이라면 그 성장을 예산에 넣거나 뒤에 압축 패스를 돌리세요
미리보기-적용 경로는 조금 더 바꿉니다. 적용된 페이지는 원래 /Contents 대신 새로운 압축되지 않은 콘텐츠 스트림 하나를 얻고, 치환 폰트가 추가된 리소스 딕셔너리의 자기 사본도 얻습니다. 문서의 다른 것들은 그대로입니다. 손대지 않은 스트림은 압축을 유지하고, 기존 폰트와 이미지는 재작성되지 않으며, 히트 없는 페이지는 쓰기 위해 열리는 일 자체가 없습니다. 재작성된 객체가 저장 시 교차 참조 구조에 어떻게 착지하는지는 HotPDF의 객체 스트림과 증분 업데이트에서 다룹니다
검색, 바이트 수준 치환, 미리보기-적용 치환, 추출, 레닉션이 모두 같은 콘텐츠 스트림 인터프리터 위에서 돕니다. Delphi 5부터 최신 RAD Studio까지, 외부 의존성 없이요. 메서드 레퍼런스, 치환 옵션, 평가판 빌드는 HotPDF Delphi Component 제품 페이지에 있습니다