「tagged PDF」ボックスにチェックが入らないままワープロから書き出された契約書は、画面の上ではそれなりに構造化して見えます。24ポイントの太字タイトル、番号付き条項、罫線で囲まれた料金表。リフロー可能なHTMLへ変換すると、料金表はちゃんとした<table>として戻る一方、タイトルは脚注とまったく同じ格の<p>になります。その出力は正しいのです。ISO 32000-1 §14.8は、PDFに「このテキストの連なりは見出しである」と言える場所を1つしか与えておらず、それが構造ツリーであり、タグなしファイルにはそれがありません。フォントサイズと太字は組版の選択であり、大きな太字の行をすべて<h1>に昇格させるコンバーターは、プルクォート、テーブルの合計、レターヘッドの社名まで昇格させます
ですから、PDFからHTMLへのどんなパイプラインにも問う価値のある質問は、出力の各見出し、各リスト項目、各テーブルがどこから来たのか、そしてスマホのレイアウトやスクリーンリーダーや検索インデクサーがそれぞれをどこまで信用できるのか、です。見出しとテーブルは、違う答えを返します。書き出し段階は、改行、文字エンコーディング、メモリについて、さらに自分自身の選択を積み上げます
見出しとリストはどこから来るのか
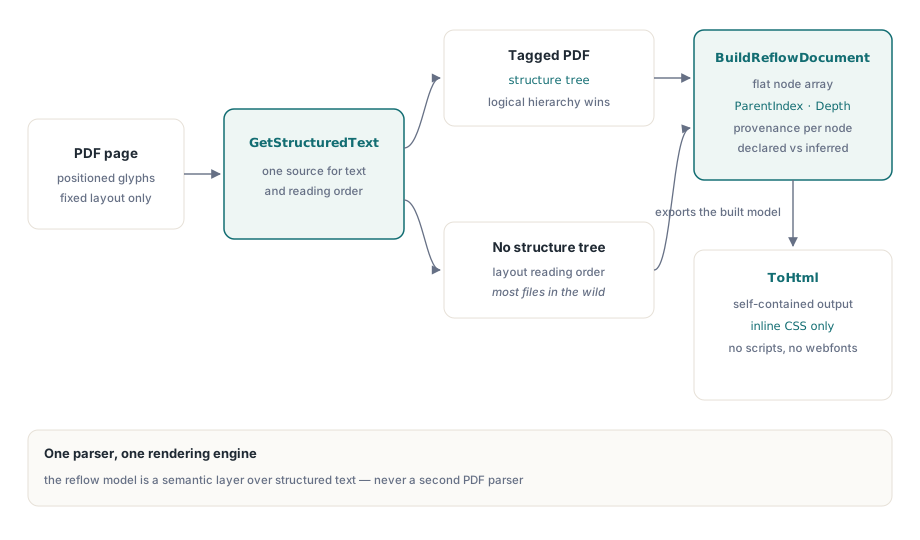
PDFium Componentは、TPdf.BuildReflowDocumentでリフローモデルを組み立てます。このメソッドは、すべての単語、ブロック、意味のヒントをGetStructuredTextから受け取ります。構造化テキストブロックと読み取り順序で述べた、あの構造化テキスト層です。背後に2つ目のパーサーや2つ目のテキスト抽出器はありません。要求範囲の各ページについて、ブロックを物理レイアウト順に収集します。GetStructuredTextはすでに各ブロックを、重なり面積でページのタグ付きコンテンツと突き合わせており、BuildReflowDocumentは見つかった役割をブロックへ写します。HからH6はレベル付きの見出しになり、LI、Lbl、LBodyはリスト項目に、Figureは代替説明をテキストとする図に、Captionはキャプションになります
帰結は2つあり、どちらも簡単に確かめられます。ブロックの順序は、タグ付きファイルであっても常にページレイアウトに従います。タグはブロックが何であるかを決め、ジオメトリがどこへ行くかを決めるのです。そしてタグのないページでは、すべてのブロックが段落になります。見出しとリストがフォントサイズから推測されることはありません
すべてのノードは、TPdfReadingOrderSource型のSourceフィールドを運びます。役割が構造ツリーから来たときはrosStructure、レイアウトだけから来たときはrosHeuristicです。書き出されるHTMLはこれを、すべての要素のdata-source="structure"かdata-source="inferred"として繰り返し、ドキュメントレベルのTPdfReflowDocument.Sourceは、範囲内の全ページがタグ付きだったときにだけrosStructureになります。テーブルは常にrosHeuristicです。幾何検出から来るのであって、Tableタグからではないからです。下流の工程が見出しをナビゲーションのランドマークとして扱うなら、まずこのフィールドを検査してください。タグ付きドキュメントは、作者が選んだランドマークを渡してくれます
オブジェクトツリーではなくフラットなノード配列
TPdfReflowDocument.Nodesは行きがけ順に平坦化されたツリーです。1つのTPdfReflowNodeレコードの動的配列で、各レコードがParentIndexとDepthを持ちます。ページノードは深さ0で親インデックス-1。段落、見出し、図、キャプション、リスト、テーブルは深さ1でページにぶら下がり、リスト項目は自分のリストの下の深さ2、テーブルセルは行の下の深さ3に届きます。連続するリスト項目は1つのリストノードを共有し、間に来た他のブロックやテーブルは新しいリストを始めます
フラットな配置は移植性の決断です。自分自身の動的配列を含む再帰レコードは、Delphi、C++Builder、Free Pascalでコンパイルは通りますが、3社ともパッケージやDLLの境界を越える再帰マネージ型の扱いが違います。素のレコードのフラット配列は3つすべてで同じ振る舞いをし、再帰なしの1つのforループでストリームできます
uses
  SysUtils, PDFium;

var
  Pdf: TPdf;
  Options: TPdfReflowOptions;
  Doc: TPdfReflowDocument;
  Node: TPdfReflowNode;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'contract.pdf';
    Pdf.LoadDocument;

    Options := TPdfReflowOptions.Default;   // 全ページ、テーブルあり、CSSあり
    Doc := Pdf.BuildReflowDocument(Options);

    for I := 0 to High(Doc.Nodes) do
    begin
      Node := Doc.Nodes[I];
      case Node.Kind of
        prnkHeading:
          Writeln(Format('%sH%d [%s] %s', [StringOfChar(' ', Node.Depth * 2),
            Node.HeadingLevel,
            BoolToStr(Node.Source = rosStructure, True), Node.Text]));
        prnkTable:
          // テーブルノードではRowSpan/ColumnSpanがテーブルの行数と列数を保持する
          Writeln(Format('%stable %dx%d, page %d, confidence %.2f',
            [StringOfChar(' ', Node.Depth * 2), Node.RowSpan, Node.ColumnSpan,
             Node.PageNumber, Node.Confidence]));
      end;
    end;

    Writeln(Format('%d node(s), %d table(s), %d character(s), pages %d-%d',
      [Length(Doc.Nodes), Doc.TableCount, Doc.CharacterCount,
       Doc.FirstPage, Doc.LastPage]));
  finally
    Pdf.Free;
  end;
end;冒頭のタグなし契約書でこのループを走らせると、H行は1つも印刷されず、検出された料金表ごとにテーブル行が1つ出ます。同じドキュメントのタグ付きコピーで走らせると、見出しがTrue付きで現れます。オプションのFirstPageとLastPageのデフォルトは0で、ドキュメントの最初と最後のページを意味します。ページ数の外の範囲は、どのページも読む前にEPdfErrorを上げます
テーブルのテキストが2回現れないのはなぜか
テーブル検出は、構造化テキストの収集の後にページごとに走るため、テーブルの内側の単語は2回存在します。テキストブロックとして1回、セルとして1回です。両方を出すと、HTMLのすべてのテーブルの後に、その内容がバラの段落としてもう1度続きます。素朴な「テーブルをテキストへ足す」マージが生むのは、まさにそれです
モデルはこれを幾何で解決します。外接箱が検出されたテーブルの境界の内側に半分以上入るテキストブロックは落とされ、テーブルノードがその場所を取ります。テーブルはその後、残りのブロックと縦位置で織り込まれます(ページの上のほうが先、上端が半ポイント以内なら左から右がタイブレーク)。したがってテーブルは、上の段落と下の段落の間に着地し、ページの末尾へ付け足されたりしません
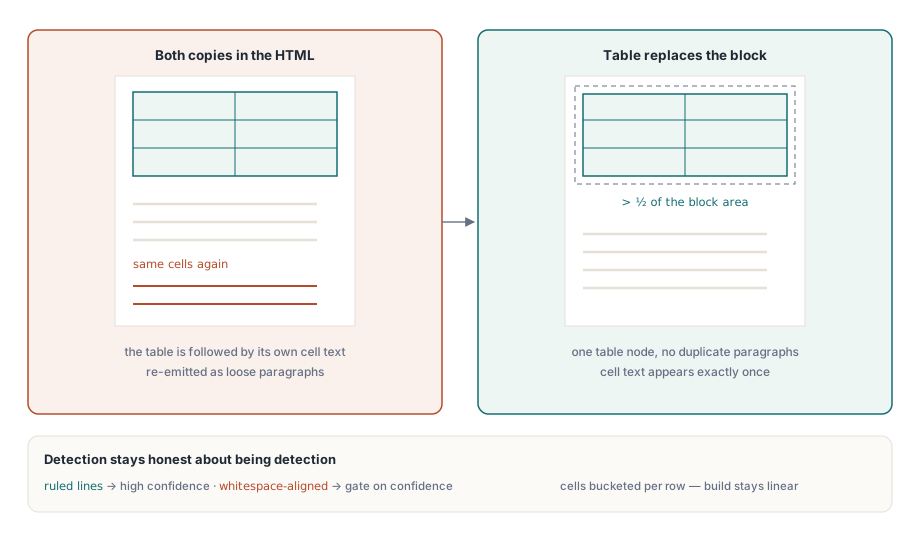
半分面積のしきい値には、目に見える縁があります。テーブルの境界にまたがり、その大部分が外にいるブロックは無事に生き残るため、1行のテキストが、最終行とその後の段落の両方に現れることがあります。これは間違え方として正しい側です。重なるブロックをすべて取り除くほど低いしきい値は、テーブルの外接箱に触れただけの本文も消します。重複した1行は気づいて許すのが簡単ですが、欠けた1文はそうではありません
検出されたテーブルは信頼度も運び、2つの検出戦略は違う帯に着地します。罫線から見つかったテーブルは、セルにテキストが入っている割合に応じて0.88〜1.0のスコアを持ちます。空白の整列だけから推測されたテーブルは0.58〜0.88です。テーブルノードのConfidenceがそのスコアを持ち、各セルノードがそれを繰り返し、HTMLは<table>要素にdata-confidenceとして書きます。TableOptions.MinConfidence(デフォルト0.5)を下回るテーブルは決して作られず、拒否されたテーブルの単語は、ごく普通の段落としてモデルに留まります
検索インデックスやモバイルの読書ビューでは、間違ったテーブルのコストは小さく、正しく検出されたテーブルは大きな改善なので、デフォルトのままにしてください。アーカイブ変換では、2列の住所ブロックの周りに作り上げられた格子は格子なしより悪いので、検出を罫線テーブルに限定します:
Options := TPdfReflowOptions.Default;
Options.DetectTables := True;
Options.TableOptions.DetectWhitespaceTables := False; // 罫線テーブルのみ
Options.TableOptions.MinConfidence := 0.9;            // まばらな罫線グリッドも落とす
Options.TableOptions.MaxTables := 200;                // ドキュメント全体の上限
Options.TableOptions.MaxCells := 50000;               // ドキュメント全体の上限

Doc := Pdf.BuildReflowDocument(Options);
if Doc.TableCount = 0 then
Writeln('No ruled tables; all page text is emitted as paragraphs');リフロー構築の内側では、MaxTablesとMaxCellsはページごとではなくページ範囲全体で数えられます。全ページに罫線テーブルを持つ300ページの明細書は、MaxTablesを少なくとも300にしないと、上限を越えた最初のテーブルでEPdfErrorとともに構築が止まります。デフォルトは1,000テーブルと100,000セルです
検出側そのもの、境界として描かれた細い塗りつぶし矩形やページにまたがる継続を含めて、テーブル検出と抽出をご覧ください
ほかに何も要らないHTMLのエクスポート
TPdfReflowDocument.ToHtmlは、すでに組み立てられたモデルをたどるだけで、PDFiumに再び触れません。したがって同じモデルの2回の書き出しは同じ文字列になります。FullDocumentが立っていると(デフォルト)、結果は完全なページです。doctype、<meta charset="utf-8">、ビューポートmetaタグ、ドキュメントのTitleエントリーから取った<title>(空なら「PDF document」)、そしてドキュメントの言語からのlang属性。FullDocumentを切ると、自分のテンプレートへ落とし込む1つの<div class="pdf-reflow">断片が得られます
IncludeCssのオプションのスタイルシートは、1つのインライン<style>ブロックです。72remの読書コラム、IncludePageSectionsが有効なときの白いカードとしての各PDFページ、崩したテーブル境界、そして40rem未満でカードのパディングを取り除きテーブルテキストを縮めるメディアクエリーです。スクリプトもWebフォントも外部URLもなく、これがファイルを、メールの中、CHM式のヘルプビューアーの中、サンドボックス化されたブラウザーコントロールの中に住まわせてくれます。1〜6の外の見出しレベルはh2として書かれ、ヘッダーセルはthになり、RowSpanやColumnSpanが1を超えるセルにはrowspanとcolspanが付きます。IncludeGeometryを有効にすると、PDFポイントでdata-left、data-top、data-right、data-bottomが加わり、検索ヒットをレンダリング済みページの上でハイライトするのに便利です
PreserveLineBreaksは、意図的な選択に値します。PDF段落の内側の改行は、1つの固定コラム幅のために作られたものです。それを360ピクセルの画面に持ち込むと、すべての行が2回折れ、リフローが取り除くために存在するギザギザのパターンが生まれます。地の文ではオフ(デフォルト)のままにします。改行が意味を運ぶドキュメント、住所、詩、コードリストではオンにすると、スペースの代わりに<br>を書きます
長いドキュメントでは、ページ全体を1つのWStringとして組み立ててからエンコードすると、メモリのピークが2倍になります。WriteHtmlは、代わりに同じマークアップをTPdfReportWriterへストリームし、ASCIIで書きながら非ASCII文字をすべて数値文字参照にするため、受け手がエンコーディングをどう推測してもバイトは妥当です:
uses
  Classes, SysUtils, PDFium, FPdfAsync, FPdfReport;

procedure ExportReflowHtml(Pdf: TPdf; const FileName: string;
  const Token: IPdfCancellationToken);
var
  Options: TPdfReflowOptions;
  Doc: TPdfReflowDocument;
  Limits: TPdfReportLimits;
  Stream: TFileStream;
  Writer: TPdfReportWriter;
begin
  Options := TPdfReflowOptions.Default;
  Options.MaxNodes := 500000;
  Options.MaxCharacters := 20000000;
  Doc := Pdf.BuildReflowDocument(Options, Token);   // ページ状態は後で復元される

  Limits := TPdfReportLimits.Default;
  Limits.MaxCharacters := 64 * 1024 * 1024;  // 出力バイトの上限、最大64 MiB
  Limits.MaxItems := Options.MaxNodes;       // ノードごとに1項目、最大1048576

  Stream := TFileStream.Create(FileName, fmCreate);
  try
    Writer := TPdfReportWriter.Create(Limits, Stream);  // ストリームの所有権は呼び出し側のまま
    try
      Doc.WriteHtml(Writer);
    finally
      Writer.Free;
    end;
  finally
    Stream.Free;
  end;
end;WriteHtmlはToHtmlより多くを検査します。Options.MaxNodesより多いノードのモデルを拒否し、書くテキストにOptions.MaxCharactersを強制し、ネストをMaxDepth引数(デフォルト64)に制限し、すべてのParentIndexがより前のノードを指すことを検証します。この最後の検査が効くのは、書き出しの前に自分のコードがNodesをフィルターや書き換えする場合です。前方の親インデックスを持つ編集済み配列は、タグの不一致したマークアップを作る代わりにEPdfReportLimitを上げます
予算、キャンセル、ページの状態
PDFは信頼できない入力であり、不正で敵対的なファイルは、小さなテキストの何千ページもの宣言をしてきます。BuildReflowDocumentは、ノードを追加する前に文字、ノード、テーブル、セルの各予算を検査するため、超えたファイルは、メモリ使用がまだ有界のうちに、予算を名指すメッセージ(たとえば「Reflow node budget exceeded」)つきのEPdfErrorで止まります。MaxCharactersとMaxNodesはどちらも正でなければならず、デフォルトは1,000万文字と100万ノードです
オプションのIPdfCancellationTokenは、ページの前、ブロックの間、テーブルの前、テーブル行の前に検査されます。フォームが所有するTPdfCancellationTokenSourceのTokenを渡し、ボタンハンドラーからCancelを呼ぶと、構築は次のチェックポイントでEPdfOperationCancelledを上げます。EPdfErrorとは別に受け止めてください。ユーザーのキャンセルが壊れたファイルとしてログに載らないようにするためです。構築がどの例外で終わろうと、部分的なものは返されません。失敗が後段のWriteHtmlの内側で起きた場合は、宛先ファイルが切り詰められたページを抱えるので、自分の例外ハンドラーで削除してください
ページ状態は、GUIコードが依存する細部です。構築はPageNumberを動かして範囲内の全ページを訪ね、try/finallyが、成功でも、予算失敗でも、キャンセルでも、呼び出し元のページを戻します。ユーザーが340ページを読んでいる間に書き出しを始めたビューアーは、書き出しが戻ったときも340ページにいます
リフローが収まる場所
リフロー出力は、検索インデックス作成、アクセシブルな読書ビュー、スマホ表示、CMSへのコンテンツ移行の入力としてよく働きます。これは絶対位置、正確なフォント、ベクターアートワーク、ページジオメトリを、オプションのdata-*座標を除いて、意図的に落とします。ページを同一に見せたい仕事はレンダリングを、別の場所で言葉を読めるようにしたい仕事はリフローを使います
見出しとリストはタグからしか来ないため、HTMLの質は上流のタグ付けの質に追従します。PDF/UA構造ツリーの検証の検査を通るドキュメントは、本物の見出し階層を持つモデルを作り、同じタグ付きコンテンツが、アクセシブルなリーダーの構築の読み上げ機能も駆動します
リフロー、構造化テキスト、テーブル抽出、レンダリングは、Delphi、C++Builder、Lazarusで同じTPdfオブジェクトに対して走ります。オプションレコード、例外、レポートライターは、Delphi向けPDFium Component製品ページに文書化されています