プリフライトではそのファイルは PDF/UA 適合と出ます。ところが同じファイルを veraPDF で開くと、7.3 条違反として代替テキストのない Figure を指摘されます。どちらも正しく、この差こそがバイト走査によるアクセシビリティ検査の問題の核心です。バイトレベルのパスで確認できるのは、ファイルがタグ付けされていると自称しているという事実までです。/StructTreeRoot、/MarkInfo /Marked true、XMP パケット内の pdfuaid:part、文書タイトル、言語コードが見つかります。これらは書式マーカーであり、必要なものです。しかし 4 ページ目にある実際の Figure が、スクリーンリーダーが読み上げできる説明を運んでいるかどうかは、そこからは分かりません。その答えはタグツリーの中にあり、知るにはツリーをたどるしかありません
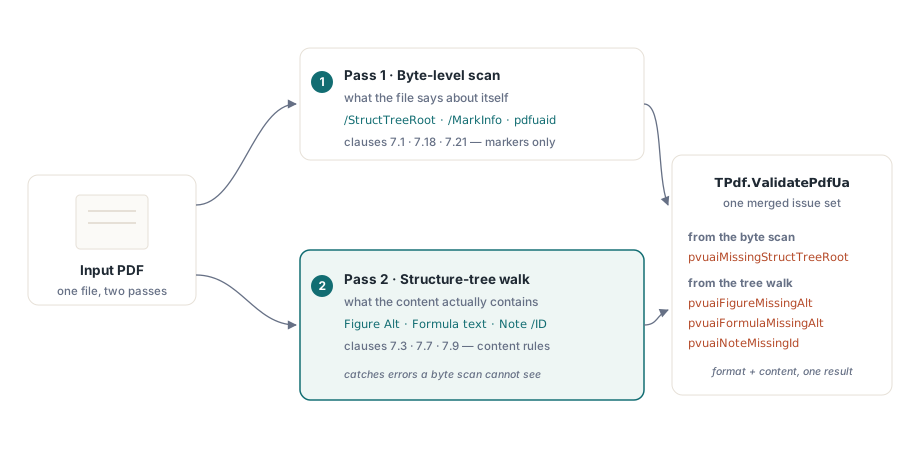
PDFium Component は Delphi と C++Builder 向けのネイティブ VCL PDF ライブラリで、その ValidatePdfUa は両方のパスを実行します。バイトレベルのパスが書式マーカーを担い、その上に構造ツリーパスが乗ります。構造ツリーパスは生きたタグツリーをロードして全要素をたどり、属性の欠落が単なるスタイル上の好みではなく現実のアクセシビリティ欠陥を意味する、少数の高信頼度コンテンツルールを検査します。本記事のテーマはこの 2 番目のパスです。何を検査するのか、なぜ規則ロジックが DLL を伴わない純粋関数なのか、そしてどこで意図的に手を止めているのかを解説します
なぜバイトスキャンでは Alt の欠落を見抜けないのか
ISO 14289-1 (PDF/UA-1) は ISO 32000 の上に重なる要件のレイヤーです。その要件の一部は構造に関わり、生のファイルからも確認できます。カタログは構造ツリーを宣言し、ビューア設定は DisplayDocTitle を設定し、フォントは埋め込まれていなければなりません。ストリーム本体を剥がし、名前トークンをデリミタ境界で照合するトークンスキャナなら、これらはすべて検証できます。PDFium の ValidatePdfUaCompliance はまさにその方式で、7.1、7.18、7.21 といった条項を検査します
しかし「すべての Figure に代替テキストがある」という条件は、ファイル構文の性質ではありません。これは論理構造、つまりコンテンツを意味に対応させるタグ付き要素のツリーの性質です。Figure の Alt エントリは構造要素辞書に入っていることもあれば、/ActualText スパンで供給されていることも、ロールマップされたカスタム型から来ていることもあります。バイトストリーム内の /Alt を grep しても確実には見つけられません。その文字列は無関係な文脈にも現れますし、オブジェクトストリーム内で圧縮されている場合もあり、どの 構造要素に属するのかを教えてはくれないからです。正直に答えるには、文書自身の構造ツリーに要素ごとに問い合わせるしかありません。veraPDF や PAC が評価しているのはまさにその面です。PDFium の Tier-1 検査が築いている線もここにあります。書式はバイトスキャンで、内容はツリー走査で確認するのです
生きたタグツリーを読む
元になるデータは TPdf.GetStructureElements(StructureElements プロパティとしても公開されています)が返す TPdfStructureElements、つまり文書順に並んだ TPdfStructureElement レコードのフラット配列です。各レコードは、PDFium のアクセサ関数を通して 1 つの構造要素を投影したもので、アクセシビリティルールが実際に必要とするフィールドだけを持ちます:
type
  TPdfStructureElement = record
    Level: Integer;            // タグツリー内の深さ
    ParentIndex: Integer;      // 親要素のインデックス、親なしは -1
    TypeName: WString;         // 標準の /S 名: Figure, Formula, Note...
    Title: WString;            // /T
    AlternateText: WString;    // /Alt   (FPDF_StructElement_GetAltText)
    ActualText: WString;       // /ActualText
    Expansion: WString;        // /E
    ID: WString;               // /ID    (FPDF_StructElement_GetID)
    Language: WString;         // /Lang
    MarkedContentIDs: TPdfIntegerArray;
    // ... 子要素管理用のフィールド ...
  end;
TypeName フィールドはバリデータが軸とする項目です。PDFium がロールマップを解決した後で FPDF_StructElement_GetType が返す、要素の標準構造型、すなわち /S 名が入ります。AlternateText は FPDF_StructElement_GetAltText から、ActualText は FPDF_StructElement_GetActualText から、ID は FPDF_StructElement_GetID から得られます。配列がフラットで順序付きであるため、バリデータは再帰なしで文書全体を一度に扱えます。これは、要素ごとではなく文書全体で判定したい唯一のルールにとって重要な点です
チェッカーが純粋関数であるのは意図的な設計です
規則ロジックは DLL とやり取りするメソッドの中にはありません。独立した公開の純粋関数として実装されています:
function ValidatePdfUaStructureElements(
  const Elements: TPdfStructureElements): TPdfUaValidationIssues;
フラットな要素配列を受け取り、問題セットを返します。PDFium の関数を一切呼ばず、文書を開かず、グローバル状態にも触れません。この分離は意図的なもので、2 度恩恵があります。第 1 にテスト容易性です。ユニットテストの中で合成の TPdfStructureElements 配列、たとえば Alt のない Figure、アクセシブルテキストが ActualText だけの Formula、同じ ID を共有する 2 つの Note を組み立てれば、pdfium.dll がなくても結果セットをアサートできます。規則ロジックはオフラインで検証され、DLL による走査は、ライブラリが存在しないときにスキップする実文書スモークテストで別途検証されます
第 2 に責務の明確さです。TPdf.ValidatePdfUa は面倒な処理、つまり各ページのロード、要素の取り出し、集約を担い、その後きれいな配列を純粋チェッカーへ渡します。「データを集める」側(DLL、副作用、ライフタイム)と「規則を判定する」側(純粋、決定論的)が絡むことはありません。ルールを変更したくなったら、I/O を一切含まない関数を書き換えるだけで済みます
3 つのルールが実際に検査するもの
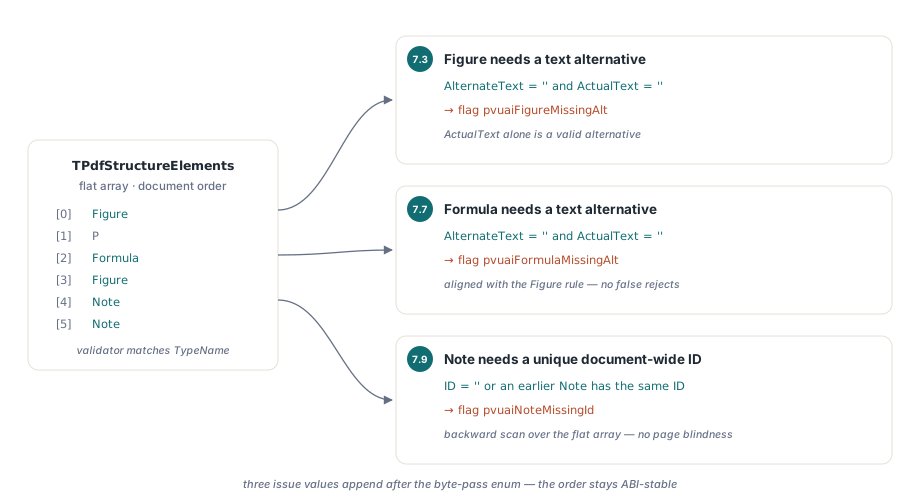
構造ツリーパスが報告する issue 値は 3 つで、既存の呼び出し側に対する ABI 互換を保てるよう TPdfUaValidationIssues 列挙の末尾に追加された pvuaiFigureMissingAlt、pvuaiFormulaMissingAlt、pvuaiNoteMissingId です。本体は全体を見通せるほど小さくなっています:
for I := 0 to High(Elements) do
begin
  T := string(Elements[I].TypeName);
  if T = 'Figure' then
  begin
    // §7.3 — Figure には代替表現が必要:
    // Alt エントリまたは ActualText。両方とも空のときだけフラグを立てる
    if (Elements[I].AlternateText = '') and (Elements[I].ActualText = '') then
      Include(Result, pvuaiFigureMissingAlt);
  end
  else if T = 'Formula' then
  begin
    // §7.7 — Figure と同じルール: Alt または ActualText
    if (Elements[I].AlternateText = '') and (Elements[I].ActualText = '') then
      Include(Result, pvuaiFormulaMissingAlt);
  end
  else if T = 'Note' then
  begin
    // §7.9 — すべての Note には一意な ID が必要
    NoteId := string(Elements[I].ID);
    if NoteId = '' then
      Include(Result, pvuaiNoteMissingId)
    else
      for J := 0 to I - 1 do
        if (string(Elements[J].TypeName) = 'Note') and
           (string(Elements[J].ID) = NoteId) then
        begin
          Include(Result, pvuaiNoteMissingId);
          Break;
        end;
  end;
end;
7.3 条は Figure を規定します。Figure 要素はテキスト代替を提供しなければなりません。安易な実装では Alt エントリだけを見ますが、それではリファレンスバリデータより厳しい検査になってしまいます。PDF/UA は、アクセシブルテキストを ActualText で供給する Figure も受け入れます。置換テキストもまた有効な代替表現だからです。そこでこのルールは、Alt と ActualText が両方とも空のときにだけ Figure をフラグします。7.7 条は Formula を扱い、Formula 枝も同一の Alt-or-ActualText テストを使います。アクセシブルテキストを ActualText だけで運ぶ Formula は同じく適合であり、Alt だけを見る検査では誤って拒否してしまうからです
7.9 条は性質の異なるルールです。Note には /ID が必須で、その ID は文書全体で一意でなければなりません。ID の欠落は要素単位の失敗です。一方、重複した ID は 2 つの要素の間の関係です。だからこそフラット配列が重要になります。チェッカーは Note ごとに、すでに読んだ要素を後ろ向きに走査し、同じ ID を持つ先行 Note との衝突をフラグします。計算量は Note 数に対する自明な O(n²) ですが、実際の文書では無視できるコストであり、補助インデックスを同期管理する必要のない、読みやすい単一ループのままで済みます
一意性を文書全体で判定できるよう、ページをまたいで集約する
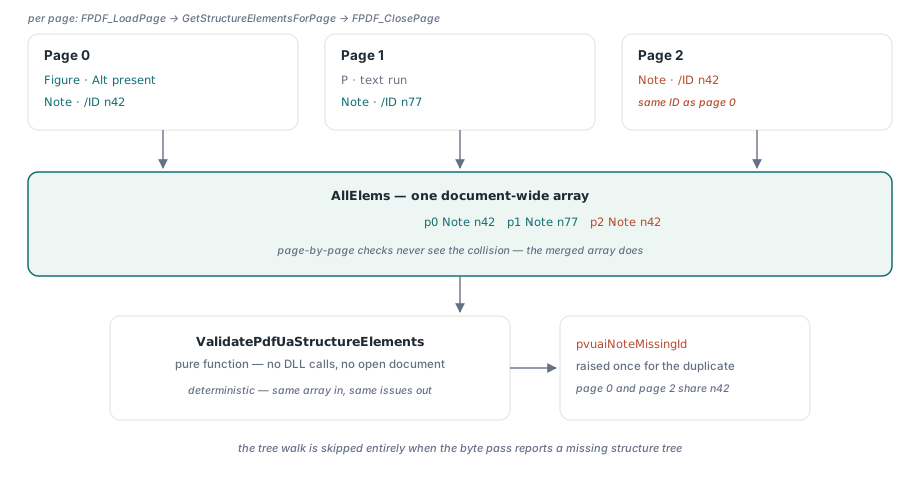
PDFium は構造要素を文書単位ではなくページ単位で公開するため、ValidatePdfUa のオーケストレーションは、ルールを実行する前に要素を集めなければなりません。FPDF_LoadPage / GetStructureElementsForPage / FPDF_ClosePage の順に各ページをたどります。コンポーネントが現時点で開いているページとは無関係に処理し、全ページの要素を 1 つの配列へ追記していきます。そのうえで初めて、純粋チェッカーを呼び出します:
// バイトレベルパスの後、TPdf.ValidatePdfUa 内
if (FDocument <> nil) and
   (not (pvuaiMissingStructTreeRoot in Result.Issues)) then
begin
  AllElems := nil;
  PageTotal := FPDF_GetPageCount(FDocument);
  for I := 0 to PageTotal - 1 do
  begin
    Page := FPDF_LoadPage(FDocument, I);
    if Page = nil then Continue;
    try
      PageElems := GetStructureElementsForPage(Page);
    finally
      FPDF_ClosePage(Page);
    end;
    // PageElems を AllElems に追記 ...
  end;
  Result.Issues := Result.Issues + ValidatePdfUaStructureElements(AllElems);
end;
この集約こそが、7.9 の一意性チェックを正しく機能させる仕組みです。異なるページに置かれた 2 つの Note は同じ ID を共有できます。ページ単位で検証していても衝突は見えません。各ページの要素セットは、それ単体では内部一貫しているように見えるからです。重複が見えるようにするには、ドキュメント全体の配列を 1 つ組み立てるしかありません。前段のガードにも注目してください。ツリー走査が実行されるのは、バイトレベルのパスが pvuaiMissingStructTreeRoot を報告していないときだけです。タグなし文書にはたどるべきツリーがなく、構造ルートの欠落としてすでにフラグが立っているため、ページ単位のロードは丸ごとスキップされます。恩恵を受けられない文書では、深い検査のコストはゼロです
設計は保守的:静かに見逃しても、誤検出は決して出さない
このバリデータで最も重要な性質は、あえて何をしないかです。判定の対象は、FPDF_StructElement_GetType が直接返す標準の /S 型名、すなわち Figure、Formula、Note だけです。カスタム型を定義して Figure にロールマップした文書では、PDFium が型をどう解決するかによって、その独自名がそのまま報告されることがあります。その場合チェッカーはそれを認識できず、沈黙します。これは見逃し(偽陰性)であり、意図された挙動です。設計原則は過少報告を優先し、偽陽性は決して出さないことです。適合ファイルに向かって狼少年を繰り返すプリフライトツールは、やがて利用者に無視されるようになります。無視されるバリデータは、存在しないのと同じか、それ以下だからです。装飾画像は構造ツリーではなく artifact ストリームに属するため、そもそも Figure として現れません。artifact として正しくマークされた背景罫線に「Alt がない」と指摘されることもありません
対象を 3 つのルールに絞っているのも同じ理由からです。見出しレベルの入れ子(7.4 条)、表ヘッダーのスコープ(7.5 条)、ロールマップの循環検出(7.1 条)はいずれも正当な PDF/UA 要件ですが、まじめに検査するには本格的なグラフ解析と属性解析が必要です。安易に実装すると、設計が禁じる偽陽性をまさに生みます。PDF/UA は H1、H2、H3、H3 のような見出しパターンを許容しますが、「厳密に増加すること」のような単純ルールはそれを誤って拒否してしまうからです。こうした検査は専用の適合ツールに委ねます。Tier-1 の対象は、属性の欠落が曖昧さなしに欠陥を意味するサブセットだけです
境界をはっきりと言っておく
リリースゲートに組み込む前に知っておくべき限界が 2 つあります。第 1 に、チェッカーの精度は PDFium が構造要素から読み取れる情報に律されます。リファレンスバリデータが通すファイルの一部は、PDFium のアクセサが表面化しないメカニズムで代替テキストを供給しているため、ファイルが適合していても FPDF_StructElement_GetAltText は空を返します。純粋チェッカーはその不完全なデータに対して「Alt 欠落」をフラグします。判定はエンジンが公開している範囲から出てくるのであり、規則ロジックから出てくるのではありません。こうしたケースを吸収するためにルールを緩めると、本来捕捉すべき現実の失敗にも気付けなくなります。だからルールは厳密なままです。フラグされたファイルの最終判断をフルバリデータに委ねるべきもう 1 つの理由がここにあります
第 2 に、これはプリフライトであって認証ではありません。Tier-1 は、バイトスキャンでは構造的に捉えられない高信頼度のコンテンツエラーを、誤検知なしに捕捉します。しかし見出しのセマンティクス、表の構造、読み順の正しさまで含む完全な PDF/UA 適合は、引き続きフルバリデータと、最終的には人間のレビュアーの仕事です。ValidatePdfUa で明白な欠陥を自分のパイプラインの中で安価に高速に落とし、最終判断は veraPDF か PAC に委ねてください。この同じ構造ツリー走査は、Delphi でアクセシブルな PDF リーダーを構築する土台にもなります。タグツリーが読み順と読み上げテキストを駆動するからです。さらに、Delphi から PDF 注釈をレビューするで扱うようなメタデータ層の作業とも補完関係にあります
ここで示した構造ツリー API と ValidatePdfUa バリデータは、Delphi と C++Builder(VCL)、Lazarus/FPC(LCL)向けの PDFium Component に同梱されています。製品ページでは完全な API リファレンスを参照できます。TPdfStructureElement レコードの全レイアウトや、これらのチェックの背後にある issue 列挙型も含まれています