垂直位置でソートされた2段組みの会議論文は、Abstract We measure the 2 Related work Earlier studiesのような1行目で返ってきます。左段の冒頭の語と右段の冒頭の語が、同じベースラインに座っているために貼り合わされたものです。パーサーに問題は起きていません。PDFページはテキストに対して2つの正当な順序を提供します。コンテンツストリームが描く順序と、ページ上のすべてのグリフの位置です。そして多くのレイアウトで、その2つの順序は食い違います。1つの文字列の代わりに位置情報つきのブロックを返す抽出器なら、どちらの順序が得られたかがわかり、目の前のページにとって間違っているときに切り替えられます
GetStructuredTextが返すもの
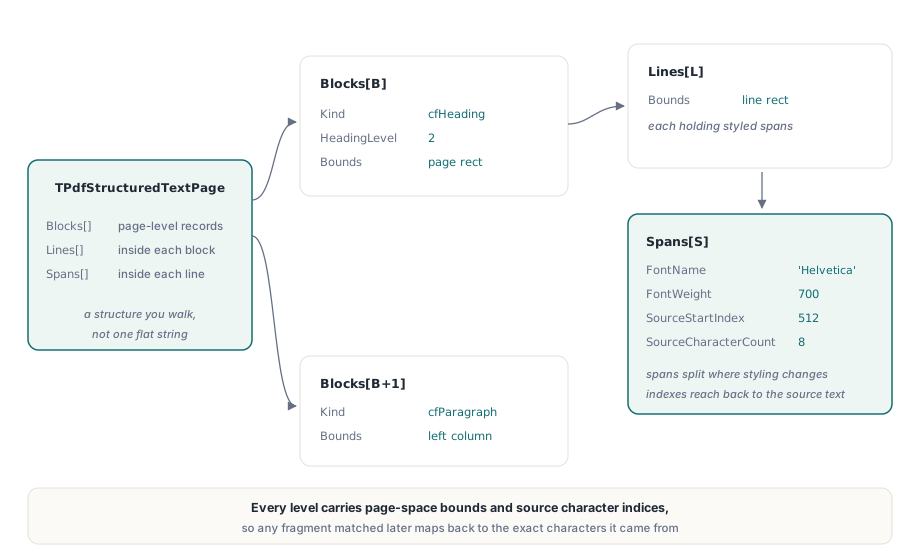
PDFium ComponentのTPdf.GetStructuredTextは、現在のページのためのTPdfStructuredTextPageを返します。ブロックの配列、各ブロックは行の配列、各行はスタイル付きスパンの配列です。どの階層も自分のTextと、PDFポイント単位のページ空間のBounds矩形を運ぶため、見出し、1行、太字のフレーズを、2度目のルックアップなしでページ上に位置づけられます。ページレコードはさらにWidth、Height、CharacterCountと、後で述べる2つの品質カウンターを加えます
フラット化されたPage.Textは、生の文字ストリームからではなくブロックから組み立てられます。ブロック内の行は単一のCRLFで結合され、ブロックは空行で区切られます。つまりPage.Textのプレーンテキストのダンプを見るだけで、抽出器がどこにブロック境界を引いたかがわかります。ページの読みがおかしいときに最初に出力すべきものです
これらすべては小さなオプションレコードが駆動します。TPdfStructuredTextOptions.DefaultはReadingOrderをroPhysicalLayoutに設定し、IncludeFontInfoとIncludeSemanticsを有効にし、MaxCharactersを1,000,000に設定します。出力の形を最も変えるのは、読み順のフィールドです
2つの読み順はどのように行とブロックを作るのか
roContentOrderは生成者の描画順を保ち、roPhysicalLayoutはグリフ位置から順序を再構築します。違いが最初に現れるのは、行の作られ方です。コンテンツ順では、文字はページが描く順に取られます。新しい行は、明示的な改行か、次の文字が現在の行と縦に重ならなくなったときに始まります。行は、2つの横の重なりが狭い方の幅の5分の1以上で、縦の隙間がおよそ2.25行の高さ以下のときにだけ、直前のブロックへ加わります。そうでなければ新しいブロックを開きます。ブロックは描画順に並びます
物理レイアウトは描画順を捨てます。既知のボックスを持つすべての文字は、そのボックスの垂直中心でソートされ、ページの上が先、次に左端です。垂直の範囲が十分に重なる文字は1行を共有します。この検査は高さだけを見ます。水平距離は関与しません。各行は、その後、同じ重なりと隙間の規則で、ページ上の既存のブロックの中から最もよく合うものへ加わります。完成したブロックは上端でソートされ、半ポイント以内の同点は左端で決まります
冒頭の例が生まれるのは、この2つ目の規則です。論文の2つの段がベースライングリッドを共有しているとき、左段の1行目と右段の1行目は縦に重なるため、物理レイアウトはそれらを1行に置きます。段の溝の隙間はフォントサイズの4分の1より広いため、抽出器はスペースを1つ入れて先へ進みます。本文のすべての行が同じことをされ、マージされた行は互いに横に重なり合い、2段組みの本文全体が、溝をまっすぐ横切って読む1つの幅広のブロックになります
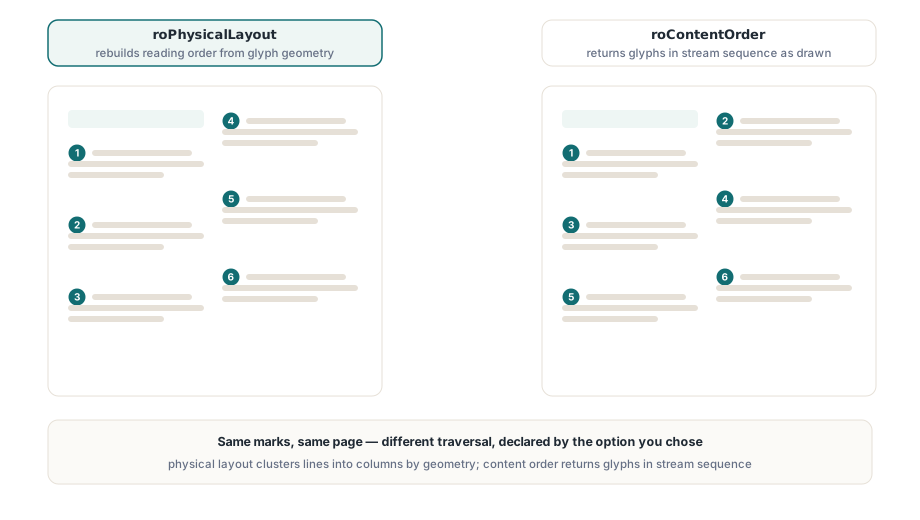
コンテンツ順は、生成者が第1段を第2段より先に書いている限り、そのページをうまく扱います。ワープロや組版システムはたいていそうします。左段の行はブロックに積み上がり、右段の1行目はそれらと横に重ならず新しいブロックを開き、ブロックは作者が書いた順に出てきます。物理レイアウトが真価を発揮するのは別種のページです。請求書、明細書、フォーム、スライドで、ラベルと値が同じベースラインに座り、行を左から右へ読むことがまさに欲しいものです。描画順が無意味なとき、たとえばフォントごとにテキストが描かれるページや、多くの小さなオーバーレイから組み立てられたページでも、こちらのモードを使います
混在するコレクションでは、選択をドキュメントタイプで分けます。既知のオーサリングツールが作った記事、レポート、マニュアルはroContentOrderを通し、フォームやトランザクション文書はroPhysicalLayoutのデフォルトに留めます。次のルーチンは、タグ付きファイルなら見出しを印付けしながら、1ページのブロックをコンテンツ順で出力します
uses
  SysUtils, PDFium;

procedure DumpBlocks(Pdf: TPdf; PageNumber: Integer);
var
  Options: TPdfStructuredTextOptions;
  Page: TPdfStructuredTextPage;
  B, L: Integer;
begin
  Pdf.PageNumber := PageNumber;                 // 1始まり
  Options := TPdfStructuredTextOptions.Default;
  Options.ReadingOrder := roContentOrder;      // 段ごとに書く生成者向け

  Page := Pdf.GetStructuredText(Options);
  if Page.Source = rosStructure then
    Writeln('block kinds come from the structure tree')
  else
    Writeln('block kinds are inferred from layout');

  for B := 0 to High(Page.Blocks) do
  begin
    if Page.Blocks[B].Kind = cfHeading then
      Writeln(Format('[%d] H%d  %s',
        [B, Page.Blocks[B].HeadingLevel, Page.Blocks[B].Text]))
    else
    begin
      Writeln(Format('[%d] x=%.0f..%.0f, %d line(s)',
        [B, Page.Blocks[B].Bounds.Left, Page.Blocks[B].Bounds.Right,
         Length(Page.Blocks[B].Lines)]));
      for L := 0 to High(Page.Blocks[B].Lines) do
        Writeln('      ', Page.Blocks[B].Lines[L].Text);
    end;
  end;
end;
溝をまたぐ行はどう検出するのか
マージされた行はスパンで自白します。GetStructuredTextは、次の文字がページの元の文字シーケンスで前の文字の直接の後継でないときはいつでも、下で述べるスタイルの変化に加えて、新しいスパンを始めます。1つの段の中では、連続する単語はソースでもたいてい連続です。マージされた行の溝では、ソースインデックスが数百文字飛び、2つのスパンの水平の隙間はどんなワードスペースよりはるかに広くなります
2つのシグナルを合わせれば信頼できる検査になり、ページが代わりにコンテンツ順を必要とするかを決める前に、デフォルトの出力に対して実行できます。GetStructuredTextが読む文字データのスナップショットはページごとにキャッシュされ、デフォルトで8ページ分です。同じページを異なるReadingOrderでもう一度要求すると、ページを抽出し直す代わりに、メモリにあるデータを再グループ化します
// LineCrossesGutterは自分で足すヘルパー:ページ上で遠く離れ、
// ソース文字シーケンスでも隣接しない2つの隣接スパンを
// 抱える行を印付ける
function LineCrossesGutter(const Line: TPdfStructuredTextLine;
  MinGap: Double): Boolean;
var
  S: Integer;
  Prev, Cur: TPdfStructuredTextSpan;
begin
  Result := False;
  for S := 1 to High(Line.Spans) do
  begin
    Prev := Line.Spans[S - 1];
    Cur := Line.Spans[S];
    if (Prev.SourceStartIndex < 0) or (Cur.SourceStartIndex < 0) then
      Continue;                                 // 代替テキストのブロック
    if (Cur.Bounds.Left - Prev.Bounds.Right > MinGap) and
       (Cur.SourceStartIndex <>
        Prev.SourceStartIndex + Prev.SourceCharacterCount) then
      Exit(True);
  end;
end;

function ExtractWithFallback(Pdf: TPdf): TPdfStructuredTextPage;
var
  Options: TPdfStructuredTextOptions;
  B, L, Lines, Crossing: Integer;
begin
  Options := TPdfStructuredTextOptions.Default;   // roPhysicalLayout
  Result := Pdf.GetStructuredText(Options);

  Lines := 0;
  Crossing := 0;
  for B := 0 to High(Result.Blocks) do
    for L := 0 to High(Result.Blocks[B].Lines) do
    begin
      Inc(Lines);
      if LineCrossesGutter(Result.Blocks[B].Lines[L], 18) then
        Inc(Crossing);
    end;

  // 4分の1の行がギャップをまたぐなら段組みであり、フォームの行ではない
  if (Lines > 0) and (Crossing * 4 >= Lines) then
  begin
    Options.ReadingOrder := roContentOrder;
    Result := Pdf.GetStructuredText(Options);
  end;
end;18ポイントは4分の1インチで、地の文のワードスペースより余裕で広く、たいていの溝より狭い値です。4行に1回のしきい値は、ラベルと金額の行をいくつか持つ請求書を物理レイアウトに留め、ほぼすべての行がまたぐ本物の2段組みの本文は切り替わります。生成者がページを両段にわたる行ごとに書いていた場合、ソースインデックスは連続のまま検査は決して発火せず、どちらの順序でも列を分けてくれません。そのようなページには、読み取り可能コンテンツAPIの段モードが必要で、広がる見出しで2列を読むで述べています
IncludeSemanticsは何を変え、何をそのままにするのか
IncludeSemanticsはブロックにラベルを付けます。並べ替えはしません。オプションを有効にすると、GetStructuredTextはページの読み取り可能コンテンツを読み、各ブロックに、最大面積で重なる断片の種類を与えます。利用できる種類は、cfParagraph、HeadingLevelつきのcfHeading、cfListItem、cfTableCell、cfCaption、cfFigure、cfLink、その他のタグのためのcfOther、そして何もマッチしなかったときのcfPlainです。各ブロックはさらに、Languageと、構造ツリーの要素へ結びつけるStructElementIndexを得ます
Sourceフィールドは、ラベルがどこから来たかを言います。ISO 32000-1 §14.7の意味で使える構造ツリーがページにあればrosStructure、種類が推定されたならrosHeuristicです。Page.Sourceはページ全体について同じ答えを与えます。rosStructureで報告された見出しは、作者がタグを付けたから見出しです。rosHeuristicで報告されたものは根拠ある推測であり、タイトルを重みづけするインデックスパイプラインは、2つを違って扱うべきです。どちらの場合もブロックの順序はやはりReadingOrderから来ます。セマンティックパスは読み取り可能コンテンツのデフォルトを使うため、ReadableContentOptionsで適用された段設定はGetStructuredTextには届きません
図にはもう1つの規則があります。タグ付きページでは、どのテキストブロックにもマッチしなかったFigure要素や代替テキストは、それ自身のブロックとして追加され、代替の説明をそのテキストとして保持します。そのようなブロックは1行と1スパンを持ち、SourceStartIndexは-1に設定されます。ページ上のどのグリフもそれを生んでいないからです。スパンを文字へ写像するコードはこの値をスキップしなければならず、上の溝の検査がそれを見るのはこのためです。構造ツリーの検査自体はPDF/UA構造ツリー検証で扱っています
スパン、境界、そして文字への帰り道
各TPdfStructuredTextSpanは、そのテキスト、境界、FontName、FontSize、FontWeight、Angleに加え、SourceStartIndexとSourceCharacterCountを運びます。IncludeFontInfoが有効なら、4つのスタイル値のどれかが変わるたびにスパンは終わり、中央に3つの太字の単語を持つ文は3つのスパンとして届き、強調はフォント名から推測する代わりにFontWeightから再構築できます。IncludeFontInfoが無効なら、スタイルのフィールドは空のままで、スパンはソースシーケンスが中断されたところでだけ切れます
角度はスタンプのあるページで効いてきます。斜めのDRAFT透かしは本文と同じ座標空間に住み、物理レイアウトでは、その文字は縦に交差する本文の行の上に着地できます。ゼロでないAngleを持つスパンは、インデックス用にテキストを結合する前に落とすのが簡単です
2つのソースフィールドこそ、検索のヒットを描けるものへ変えるものです。ページの文字シーケンスをインデックスするため、ブロックの中で見つかったフレーズは、ハイライト用の文字ボックスへ直接変換できます。その手法は文字ボックスによる視覚的なテキスト行選択にあります。ページのリフロー版やHTML版が目的なら、同じブロックがリフローモデルとHTMLエクスポートの入力になります
文字の予算と2つの品質カウンター
MaxCharactersは、許可より多くの文字を抱えるページを丸ごと拒否します。GetStructuredTextは作業配列を確保する前にカウントを検査し、大きすぎるページはStructured text character budget exceededというメッセージのEPdfErrorを出します。部分的なページが返されることはありません。値は正でなければなりません。メソッドが読むページごとの文字スナップショットには、それ自体のデフォルト上限として100万文字と100,000テキストオブジェクトがあり、Text snapshot budget exceededとして報告されるため、MaxCharactersを100万より上に設定しても、より大きなページは通りません
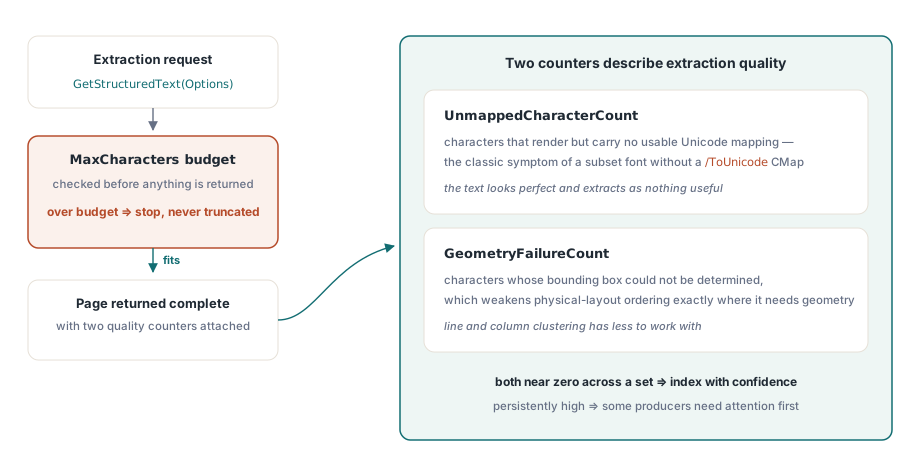
UnmappedCharacterCountは、PDFiumがまったくUnicode値を作れなかった文字を数えます。それらの文字はすべてのTextフィールドにU+FFFDとして現れます。よくある原因は、独自エンコーディングで/ToUnicode CMapのないサブセットフォント、ISO 32000-1 §9.10.2が記述するケースで、テキストは正しく描画されるのに確実には抽出できません。カウンターが測るのは欠落したマッピングだけです。/ToUnicodeエントリが間違ったコードポイントを名指しているグリフはマップ済みと数えられるため、もっともらしい見かけのゴミのページはゼロを報告することもあります
GeometryFailureCountは、使えるボックスのない文字を、改行を除いて数えます。コンテンツ順では、そのような文字は単に隣人に続きます。物理レイアウトではソートすべき位置がないため、位置を持つすべての文字の後に置かれ、ページの最終行にくっついて終わります。ジオメトリのカウントがゼロでなく、最終行に変な断片のあるページは、まさにそれを見せています
// LogRejectedとLogQualityは独自のログ出力ルーチン
function ExtractForIndex(Pdf: TPdf; PageNumber: Integer;
  out Page: TPdfStructuredTextPage): Boolean;
var
  Options: TPdfStructuredTextOptions;
begin
  Result := False;
  Pdf.PageNumber := PageNumber;
  Options := TPdfStructuredTextOptions.Default;
  Options.MaxCharacters := 200000;              // このパイプラインの取り込み上限
  try
    Page := Pdf.GetStructuredText(Options);
  except
    on E: EPdfError do
    begin
      LogRejected(PageNumber, E.Message);       // 文字またはスナップショットの予算
      Exit;
    end;
  end;

  if Page.UnmappedCharacterCount * 20 > Page.CharacterCount then
    LogQuality(PageNumber, Format('%d of %d characters have no Unicode value',
      [Page.UnmappedCharacterCount, Page.CharacterCount]));
  if (Options.ReadingOrder = roPhysicalLayout) and
     (Page.GeometryFailureCount > 0) then
    LogQuality(PageNumber, Format('%d characters without a box; check the last line',
      [Page.GeometryFailureCount]));
  Result := True;
end;文字列としてだけ必要なページには、PDFドキュメントからのテキスト抽出がより単純な呼び出しを扱い、BDCとMCIDマークコンテンツの読み書きは構造ツリーの1階層下に入ります。構造化ページモデル、読み取り可能コンテンツリーダー、リフローエクスポートはすべて、PDFium Component製品ページで述べられているDelphiとLazarusのコンポーネントに同梱されています