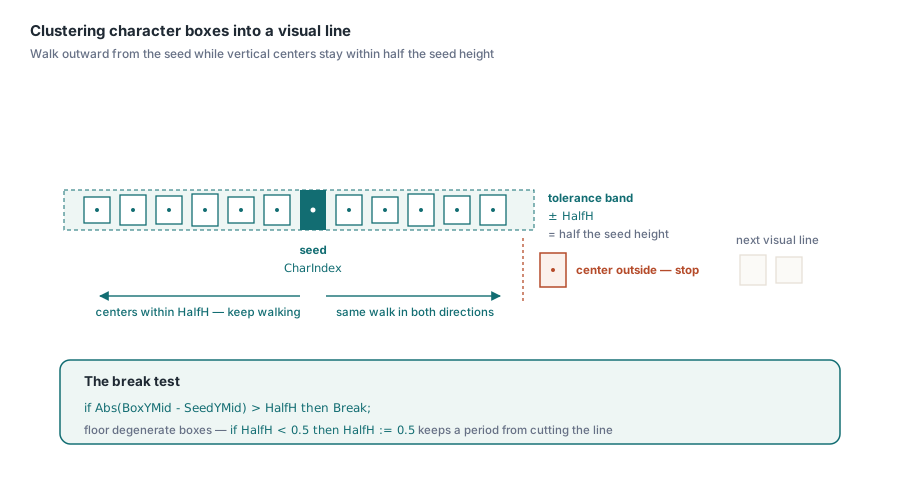
PDFテキストページは文字とボックスを公開するが、行は決して公開しない。PDFium Componentは、垂直方向の中心がシード文字の高さの半分以内にある文字ボックスをクラスタリングし、クリックされた文字から外側にスキャンして許容範囲を超えたところで止めることで、視覚的な行を構築する。ビューア内のすべての選択パスはその1つのヘルパーを呼び出すので、マウス、キーボード、コードは一致する
これを探すきっかけになる症状は具体的で不快なものだ。ユーザーが2段組レポートの段落をトリプルクリックすると、ページの半分が選択されてしまう。あるいはテーブルセルをトリプルクリックすると、選択がその行全体とフッターのページ番号まで飲み込んでしまう。ビューアが壊れているわけではない。ファイルが答えられない問いを尋ねているのだ。PDFには選択すべき行は存在せず、それがあるふりをする実装はどれも推測しているにすぎない。この記事は、その推測を意図的なものにし、一貫したものにすることについてだ。実際に必要なものがドキュメントからのテキスト抽出であればPDFiumでDelphiのPDFドキュメントからテキストを抽出するを、テキストをレイアウトして幅が必要ならテキスト計測と折り返しを見てほしい。ここでの主題はもっと狭い:視覚的な行がどこで始まりどこで終わるかを決め、まさにそこを選択することだ
なぜPDFテキストページには行オブジェクトがないのか
PDFのコンテンツストリームは、構造ではなく描画を記述しているからだ。ISO 32000-1 §9.4は、テキストオブジェクトを、位置決めと表示のオペレータを含むBT/ETのペアとして定義している。§9.4.2の位置決めオペレータ(Td、TD、Tm、T*)はテキスト行列をページの周りに動かし、§9.4.3の表示オペレータ(Tj、TJ、'、")はその行列が現在指しているところにグリフを描画する。そのモデルの中には「このグリフの並びは1つの行だ」と述べるものは何もない。行は、描画が終わったあとに人間が見るものなのだ
プロデューサーは、あなたが制御できない方法でこれを悪化させる。両端揃えの段落は、行ごとに1つのTJ配列として出力されるかもしれないし、明示的なTmを各単語の前に伴うTj1つずつとして出力されるかもしれないし、間隔をカーニング調整で運ぶ1回の表示操作として出力されるかもしれない。2段組レイアウトは、左の列を上から下まで出力し、それから右の列を出力するかもしれないし、生成アプリケーションが自身の内部オブジェクトリストを別の順序で歩いた場合は両者をインターリーブするかもしれない。PDFiumがあなたに渡す文字の並びはコンテンツストリームに従い、コンテンツストリームは生成アプリケーションがそのとき何をしたいと思ったかに従う。だから実際に得られる生の語彙はFPDFText_CountChars(ページが保持する文字数を報告する)とFPDFText_GetCharBox(1文字のバウンディングボックスをページ空間で返す)の2つの関数だ。それが生の語彙のすべてだ。その上にある単語、行、段落、列はすべて、あなたが幾何学に対して行う推論だ
なぜCRとLFの検出は間違ったテストなのか
テストしようとする文字が信頼できる形で存在せず、存在するときも信頼できる形であなたのものではないからだ。PDFiumは、抽出されたテキストを読みやすくするために、テキストページに合成文字を注入する:2つの実行部分が視覚的に分離されている箇所には空白を、次の実行部分が新しいベースラインで始まる箇所にはCRまたはLFを挿入する。FPDFText_IsGeneratedは、まさにファイルから出てきた文字とそれらを区別できるように存在しており、PDFium ComponentはそれをCharacterGeneratedプロパティとして公開している
これらの文字で分割すると、PDFiumが合成する際に下したあらゆる判断を引き継ぐことになる。折り返された段落の中の強制改行とソフトラップは、合成後は同一に見える。プロデューサーがセルごとに出力したテーブル行は、最後のセルと次の行の最初のセルの間に改行が一切ないかもしれない。ベースラインがたまたま十分近いからだ。一方、異なるサイズのボディテキストが続く見出しは、人間が1つと見るところに2つの改行を得るかもしれない。合成文字は全ページ抽出のためのレンダリングの便宜であり、行モデルではない。そして選択が最も重要になるまさにそのドキュメントで劣化する
垂直方向の中心で文字ボックスをクラスタリングする
信頼できるシグナルは幾何学だ。ユーザーがクリックした文字をシードとし、そのボックスの垂直方向の中心を計算し、隣接するボックスの垂直中心が許容範囲内に留まっている限り両方向へ歩を進める。PDFium Componentはその許容範囲としてシードボックスの高さの半分を使い、0.5ページ単位の下限を設ける。退化したボックス——句点、薄いスペース、高さほぼゼロのボックスを持つグリフ——が許容範囲をゼロに潰し、1文字で行を切ってしまわないためだ
function TPdfView.LineRangeAt(TxtPage: FPDF_TEXTPAGE; CharIndex: Integer;
  out StartIndex, Count: Integer): Boolean;
var
  Lo, Hi, Total: Integer;
  SeedBox, Box: TPdfRectangle;
  SeedYMid, BoxYMid, HalfH: Double;
begin
  Result := False;
  StartIndex := -1;
  Count := 0;
  Total := FPDFText_CountChars(TxtPage);
  if (CharIndex < 0) or (CharIndex >= Total) then
    Exit;

  if FPDFText_GetCharBox(TxtPage, CharIndex, SeedBox.Left, SeedBox.Right,
    SeedBox.Bottom, SeedBox.Top) = 0 then
    Exit;
  SeedYMid := (SeedBox.Top + SeedBox.Bottom) / 2;
  HalfH := Abs(SeedBox.Top - SeedBox.Bottom) / 2;
  if HalfH < 0.5 then          // 退化したボックスの下限
    HalfH := 0.5;

  Lo := CharIndex;
  Hi := CharIndex;
  while Lo > 0 do
  begin
    if FPDFText_GetCharBox(TxtPage, Lo - 1, Box.Left, Box.Right,
      Box.Bottom, Box.Top) = 0 then
      Break;
    BoxYMid := (Box.Top + Box.Bottom) / 2;
    if Abs(BoxYMid - SeedYMid) > HalfH then
      Break;
    Dec(Lo);
  end;
  while Hi < Total - 1 do
  begin
    if FPDFText_GetCharBox(TxtPage, Hi + 1, Box.Left, Box.Right,
      Box.Bottom, Box.Top) = 0 then
      Break;
    BoxYMid := (Box.Top + Box.Bottom) / 2;
    if Abs(BoxYMid - SeedYMid) > HalfH then
      Break;
    Inc(Hi);
  end;
  StartIndex := Lo;
  Count := Hi - Lo + 1;
  Result := True;
end;そのループの中で3つの細部が意味を持つ。許容範囲は定数からではなくシードから導出されるので、24ptの見出しは広い帯を得て、7ptの脚注テキストは狭い帯を得て、どちらも互いから文字を奪わない。比較はベースラインやボックスの上端ではなく垂直方向の中心を使うので、上付き文字、インラインの異なるサイズの実行部分、あるいはフォントが混在した文章も、その隣人と同じ行のままになる。そしてFPDFText_GetCharBoxの失敗はスキップされるのではなくスキャンを終了させる。取得できる幾何学を持たない文字は、どちらの方向にも証拠を与えないからであり、それを越えて続行することは、それより先にある文字の力を借りて本物の境界を飛び越えることを許してしまうだろう
なぜすべての選択パスは1つのヘルパーを共有しなければならないのか
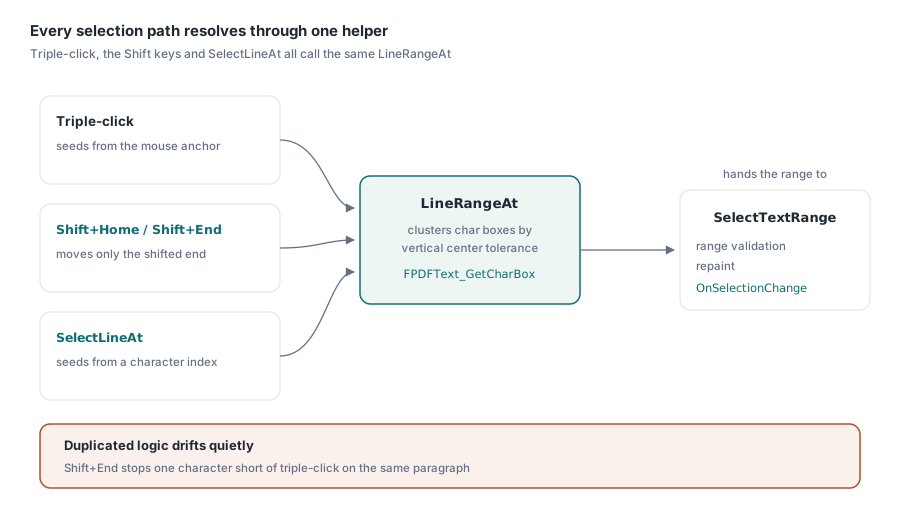
「行」をそれぞれ実装する 3 つのコードパスは発散するし、静かに発散するからだ。PDFium Componentでは、トリプルクリックの展開、Shift+Home、Shift+End、公開メソッドのSelectLineAtが、すべて同じLineRangeAt呼び出しを通じて境界を解決する。トリプルクリックは選択アンカーからシードを取り、Shiftキーは選択カーソルからシードを取り、その端だけを動かす。SelectLineAtは呼び出し側が渡した文字インデックスからシードを取り、結果をSelectTextRangeへ渡す。マウスパスが使うのと同じ範囲バリデータだ。代わりにロジックを複製すれば、失敗はクラッシュではなくゆっくりしたドリフトになる。誰かがリーディングの詰まったレポートを直すためにトリプルクリックの許容範囲を調整すると、同じ段落でShift+Endがトリプルクリックの停止位置の 1 文字手前で止まるようになる。ユーザーはマウスで行を選択し、キーボードで延長し、選択が縮むのを見る。SelectLineAtは通常の選択パイプラインに流れ込むため、プログラムからの選択も、マウス入力が有効かどうかに依存せず、範囲検証、再描画、OnSelectionChange通知を無料のまま受け取る
// クライアント空間のポイントの下にある視覚的な行を選択し、読み戻す
procedure TForm1.SelectLineUnderCursor(X, Y: Integer);
var
  CharIndex: Integer;
begin
  CharIndex := PdfView1.CharacterIndexAtPos(X, Y, 6.0, 6.0);
  if CharIndex < 0 then
    Exit;
  if PdfView1.SelectLineAt(PdfView1.CurrentPage, CharIndex) then
    Memo1.Lines.Add(PdfView1.SelectedText);
end;CharacterIndexAtPosの許容範囲の引数に注目してほしい。ヒットテストは独自の遊びをページ単位で持っており、それは行の許容範囲とは別の関心事だ。2つの行の間のリーディング(行間)に着地したクリックは、そのボックス内で最も近い文字に解決される。行のスキャンはその後、それがたまたま何であったかの文字から実行される。寛容すぎるヒット許容範囲をシードに供給することは、ユーザーが指していなかった行を選択してしまう最も簡単な方法の1つだ
2つのインデックス空間:文字インデックスとテキストインデックス
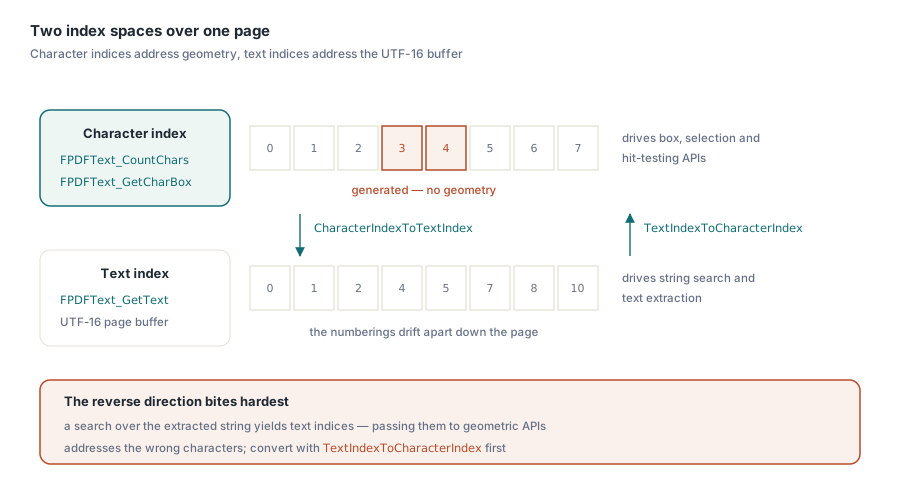
範囲を手にしたら、それを文字列オフセットとして使いたくなる衝動に抗え。FPDFText_GetTextはページテキストをUTF-16バッファとして返すが、そのインデックスはFPDFText_GetCharBoxとFPDFText_CountCharsが使う文字インデックスと同じインデックス空間ではない。先に述べた生成文字はテキストバッファには座りつつ、使える幾何学を持たない文字スロットを占有しており、2つの番号付けはページをまたいでずれていく。橋渡しはFPDFText_GetTextIndexFromCharIndexとFPDFText_GetCharIndexFromTextIndexであり、PDFium ComponentはそれをCharacterIndexToTextIndexとTextIndexToCharacterIndexとしてラップしている
var
  TextStart, TextEnd: Integer;
begin
  // LineRangeAt からの文字インデックス範囲 -> ページテキストバッファのオフセットへ変換する
  TextStart := Pdf.CharacterIndexToTextIndex(StartIndex);
  TextEnd   := Pdf.CharacterIndexToTextIndex(StartIndex + Count - 1);
  if (TextStart >= 0) and (TextEnd >= TextStart) then
    Caption := Pdf.Text(TextStart, TextEnd - TextStart + 1);
end;最も強く噛みつく方向は逆方向だ。抽出された文字列に対して実装された検索はテキストインデックスを与え、それらをボックスや選択APIにそのまま渡すと、黙って間違った文字がアドレスされ、その誤差はページを下るほど大きくなる。何かが幾何学に触れる前にTextIndexToCharacterIndexで変換しよう。サロゲートペアはこの上にもう1つの独立したオフセット問題を追加しており、それは絵文字、CJK、サロゲートペアの記事で扱っている
垂直中心の規則が仮定するもの
垂直クラスタリングは水平なテキスト行のために作られている。そしてフォントサイズの混在は、シード相対の許容範囲がうまく扱えるケースだ。11ptの本文中のインラインの8ptコードスパンは中心を帯の中に保ち、次のベースラインにある24ptの見出しは本文の行を自分の中に引き込まない。同じ幾何学が、2つ目のシグナルが必要になる場所を説明する。文字ボックスはページ空間における軸平行な矩形なので、90度回転したテキストや縦書きモードのテキストでは、1つの視覚的な行のボックスの垂直中心はページ全体に広がり、スキャンは間違った選択ではなく短い選択を返す。同じベースライングリッドを共有する 2 つの列は、素の幾何学では何も持たない。そのためそのようにレイアウトされた文書では、垂直クラスタリングの上に水平方向の隙間テストを追加し、そのしきい値は実際に扱う文書に合わせて選ぶ
ここで説明した行選択のセマンティクスは、この例で使われているヒットテスト、選択範囲、テキストインデックスのAPIと並んで、Delphi・C++Builder向けPDFium Componentに付属している。その製品ページには、テキストページと選択モデルの完全なリファレンスがある