キリル文字のモデルをロードした認識エンジンが、辞書だけは中国語の文字辞書を読み続けていると、ロシア語の請求書をかけても戻ってくるのは完璧に正しい形の漢字の羅列です。どの行も well-formed な UTF-8 で、どの行も検索可能テキストレイヤーに載り、それなのに紙面に印字されたどんな単語を検索しても1件もヒットしません。モデル自体は仕事を果たしています。CTC認識器は文字を出力せず、出すのはクラス番号だけで、クラス1,204をどの字形に写すかを決めるのは辞書ファイルだけです
近くには関連する障害が3つ潜んでいて、ラテン文字のデモではどれも表面化しません。すべての行から最後の1文字が消える、英語のテキストから単語間隔が消える、アラビア語のテキストボックスが左から右の順で返ってくる。それぞれが辞書のルール、ループの境界、ソート順という『ほぼ正しくても通ってしまう』場所に根ざしています。そして4件すべての出発点は同じです。言語タグをモデルと辞書へ変換する、あの一歩です
HotPDFのRapidOCR言語プリセット:1タグ、1固定ペア
HotPDFでは、THPDFRapidOCRDLLOptions.ForLanguageが言語タグを、モデルディレクトリー以下の<profile>/recognition.onnxと<profile>/dictionary.txtを指すオプションへ変換します。それ以外はすべてTHPDFRapidOCRDLLOptions.Defaultから来ます。共有の検出器、オプションの角度分類器、スレッド1本、リクエストあたり16,777,216ピクセルの予算、60秒のタイムアウトです。タグは小文字化され、アンダースコアはハイフンに置き換わり、前後の空白は取り除かれるので、'zh_TW'も'ZH-tw'も' zh-tw 'も同じプロファイルに解決されます
マッチングは明示的なエイリアスリストに対して行われ、プレフィックスマッチはありません。'zh-Hant-TW'や'zh-MO'が受け付けられるのはリストに載っているからで、'pt-AO'は載っておらず、ForLanguageはどのファイルも開く前にEArgumentExceptionを上げます。この厳格さは意図的なものです。プレフィックスルールを許すと、'zh-Hant-SG'や将来の何らかのタグが、最初の2文字を共有するプロファイルへ黙って送られてしまいます。しかも中国語の場合、最初の2文字では文字体系を判別できません
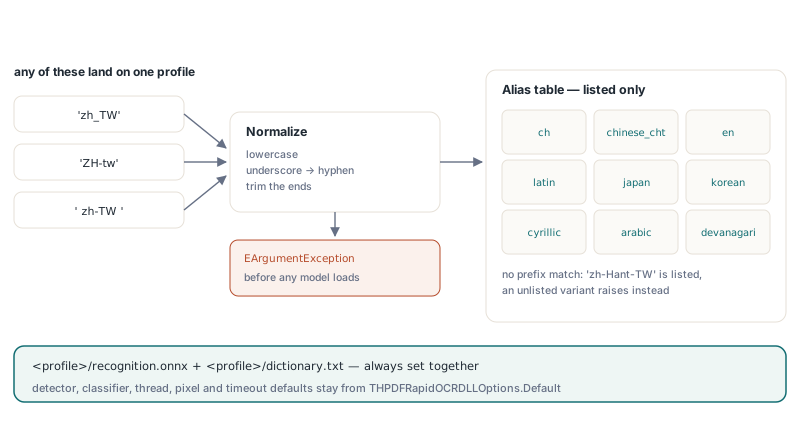
| プロファイル | 言語 | タグの例 | 行内のボックス順 |
|---|---|---|---|
ch | 簡体字中国語と英語 | zh、zh-CN、zh-Hans、chi_sim | 左から右 |
chinese_cht | 繁体字中国語 | zh-TW、zh-HK、zh-Hant、chi_tra | 左から右 |
en | 英語 | en、en-US、en-GB、eng | 左から右 |
latin | フランス語、ドイツ語、スペイン語、ポルトガル語、イタリア語、オランダ語、トルコ語 | fr、de、es-419、pt-BR、tr | 左から右 |
japan | 日本語 | ja、ja-JP、jpn | 左から右 |
korean | 韓国語 | ko、ko-KR、kor | 左から右 |
cyrillic | ロシア語、ウクライナ語、ブルガリア語、ベラルーシ語 | ru、ru-RU、uk、bg | 左から右 |
arabic | アラビア語、ペルシア語、ウルドゥー語 | ar、ar-SA、fa、ur | 右から左 |
devanagari | ヒンディー語、マラーティー語、ネパール語 | hi、mr、ne | 左から右 |
アダプターが何かをダウンロードすることはありません。モデルファイルは同梱のヘルパーで一度だけ調達します。たとえばtools/Install-RapidOCRModels.ps1 -Destination C:/OCR/models -Language ch,chinese_cht,cyrillicのように実行するか、9プロファイル全部なら-Language Allです。ヘルパーは共有の検出器と分類器をDefaultが期待するルートのファイル名に置き、各プロファイルを専用のフォルダーへ入れます。エンジンの生成、DLL境界、スレッドの扱いはインプロセスRapidOCR DLLの記事で扱っています。ファイルが揃えば、簡体字中国語のスキャンは次のようにして検索可能になります
uses
  SysUtils, HPDFDoc, HPDFRapidOCRRecognition;

procedure MakeChineseScanSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Models: THPDFRapidOCRDLLOptions;
  Layer: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // ch/recognition.onnx + ch/dictionary.txt、共有の検出器と分類器
  Models := THPDFRapidOCRDLLOptions.ForLanguage('zh-CN');
  // モデルはここでロード。エンジンはドキュメントをまたいで再利用する
  Engine := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models', Models);
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Layer := THPDFOCRTextLayerOptions.Default;  // 300 DPI、MinimumConfidence 0.5
    // 空のページリスト=全ページ。SkipPagesWithTextはテキストのあるページに触れない
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Layer, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' lines, ', Info.UniqueScalarCount, ' distinct characters');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;この出力には注意して読むべき数字が2つあります。ネイティブパイプラインは検出したテキスト行ごとに1件の結果を返すので、ここでのAcceptedWordCountは行数を数えており、MinimumConfidenceは行全体の文字信頼度の平均と比較されます。平均0.45の行は丸ごと1行単位で捨てられます。UniqueScalarCountは、テキストレイヤーがフォントとToUnicodeテーブルへ写す必要のあった異なるUnicodeスカラー値の個数です。中国語の本文ページなら、この数字はラテン文字ページが必要とする数十字を大きく超えるはずで、中国語のスキャンなのにラテン文字規模のカウントに留まっていたら、たいていは間違ったプロファイルをロードしています
認識モデルだけを切り替えるとゴミが出る理由
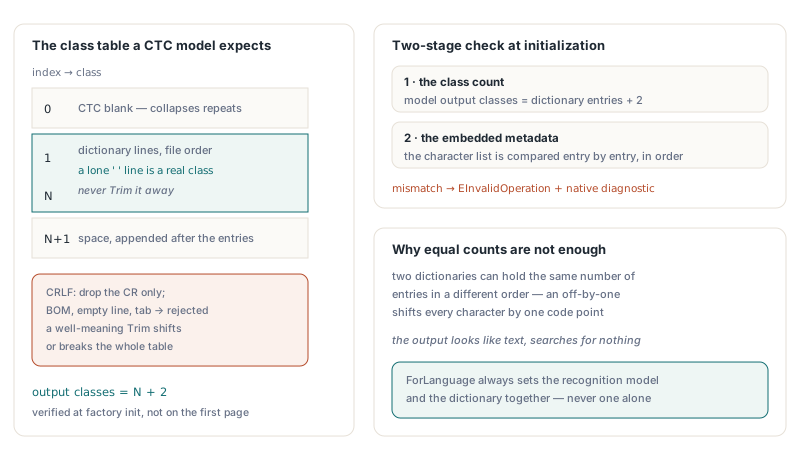
モデルと辞書は1つの検索表の半分ずつであり、インデックスの意味を知っているのは辞書の方だけだからです。RecognitionModelをcyrillic/recognition.onnxに向けたままCharacterDictionaryが中国語のファイルを指し続けると、モデルは正しいキリル文字のインデックスを出し、古い辞書はそれをでたらめな漢字に翻訳します。ForLanguageは常に両方のフィールドを一緒に設定します。手で組んだオプションも同じ規律に従うべきです。片方だけを変えないこと
辞書のサイズとモデル出力幅を比べるという素直なガードは必要ですが、それでも足りません。2つの辞書は同じ件数を異なる順序で持てますし、1つずれすればすべての文字が1つずれます。そこでHotPDF RapidOCR DLLは、ファクトリーが認識器を初期化する間に2重に検査します。モデルの出力クラス数は辞書のエントリー数+2と等しくなければならず、さらにONNXファイルがcharacterメタデータリストを埋め込んでいれば、各辞書行がそれと順に比較されます。どちらかが一致しなければHPDFCreateRapidOCRDLLOCREngineがネイティブの診断情報付きでEInvalidOperationを上げます。エラーは起動時に表面化し、顧客のアーカイブでは表面化しません
「+2」はクラスタレイアウトから来ます。クラス0はCTCブランク、クラス1からNはファイル順の辞書行、最終クラスはスペースです。辞書によっては単独のスペースエントリーを自分でも持っていて、その行は寸分違わずそのまま生き延びなければなりません。ここで善意のTrimは本当に壊します。スペースエントリーを空文字列に変え、テーブルをずらしたり壊したりするからです。DLLは末尾の復帰文字を取り除いてCRLFファイルをロードできるようにする一方で、UTF-8のバイトオーダーマーク、空行、タブや迷子の復帰文字を含むエントリーは拒否します
自分の辞書を保守するなら、ビルドや配置のスクリプトに事前検査を仕込んでおくと、エンジンが気付く前にこれらの問題を拾えます。下の関数は自分で書くコードであり、上記のルールを写経したものです
// HotPDFのAPIではない自作ヘルパー:CTC認識器が期待するクラステーブルを
// 組み立て、DLLが拒否するのと同じ辞書欠陥を拒否する
uses
  SysUtils, IOUtils;

function BuildCTCClassTable(const FileName: string): TArray<string>;
var
  Text, Entry: string;
  Lines: TArray<string>;
  I, Last: Integer;
begin
  Text := TEncoding.UTF8.GetString(TFile.ReadAllBytes(FileName));
  if (Text <> '') and (Text[1] = #$FEFF) then
    raise EArgumentException.Create('Dictionary must be UTF-8 without a BOM');
  Lines := Text.Split([#10]);
  Last := High(Lines);
  if (Last >= 0) and (Lines[Last] = '') then
    Dec(Last);                                   // ファイル末尾の改行
  if Last < 0 then
    raise EArgumentException.Create('Dictionary is empty');
  SetLength(Result, Last + 3);
  Result[0] := '';                               // クラス0:CTCブランク
  for I := 0 to Last do
  begin
    Entry := Lines[I];
    if (Entry <> '') and (Entry[Length(Entry)] = #13) then
      SetLength(Entry, Length(Entry) - 1);       // CRLF:CRだけを落とす
    if (Entry = '') or (Pos(#9, Entry) > 0) or (Pos(#13, Entry) > 0) then
      raise EArgumentException.CreateFmt('Invalid dictionary line %d', [I + 1]);
    Result[I + 1] := Entry;                      // Trimしない:' 'も1クラス
  end;
  Result[Last + 2] := ' ';                       // 最終クラス:スペース
  // Length(Result) はモデル出力のクラス数と一致していなければならない
end;
貪欲CTCデコードと3つの境界トラップ
貪欲CTCデコードは各タイムステップで最もスコアの高いクラスを選び、連続するリピートを1文字に潰し、ブランクを落とします。ブランクがあるからこそ、本当に重複した文字は生き延びられます。認識モデルはテキスト行を狭い縦スライスの列として読み、スライスごとに全クラスの確率を出力します。AA中を含む行は、argmax系列としてA A blank A 中 spaceを返すかもしれません。最初の2つのAステップは1つに潰され、ブランクが次のAとを隔て、末尾のスペースをそのまま残して出力はAA中 になります。ブランクの規則がなければ、bookとbokは同じにデコードされてしまうでしょう
そのような短いデコーダーはオフバイワンを招きやすく、間違いはそれぞれ見分けのつく症状を出します。内側のargmaxループを1クラス早く止めると、スペースクラスは永遠に勝てなくなり、英語やラテン文字の行はすべて1つの長い単語になってフレーズ検索が機能しなくなります。外側のループを1タイムステップ早く止めると、すべての行の最後の文字が消えます。2文字のラベルならテキストの半分です。ブランクにリピートガードをリセットさせるのを忘れると、重複文字が潰れます。helloのllや、畳語の谢谢です。独自パイプライン向けにデコーダーを書くなら、この3ケースが手頃なテストセットになります。HotPDFのデコーダーは最後のクラスと最後のステップを扱い、ブランクで隔てられたリピートを保持し、有限でないスコアや0から1の範囲外のスコア、さらに辞書と食い違うクラス数を拒否します
// HotPDFのAPIではない、自作パイプライン向けの説明用コード:正しい境界で
// 行う貪欲CTCデコード。ScoresにはSteps * Classes個の
// 確率が入り、1行が1タイムステップに対応する
function GreedyCTCDecode(const Scores: array of Single;
  Steps, Classes: Integer; const Characters: array of string): string;
var
  Step, C, Best, Previous: Integer;
  BestScore: Single;
begin
  if (Classes < 3) or (Length(Characters) <> Classes) or
    (Length(Scores) <> Steps * Classes) then
    raise EArgumentException.Create('Model output does not match the dictionary');
  Result := '';
  Previous := 0;                            // クラス0はCTCブランク
  for Step := 0 to Steps - 1 do             // 最後のタイムステップも含める
  begin
    Best := 0;
    BestScore := Scores[Step * Classes];
    for C := 1 to Classes - 1 do            // 最後のクラス(スペース)も含める
      if Scores[Step * Classes + C] > BestScore then
      begin
        Best := C;
        BestScore := Scores[Step * Classes + C];
      end;
    if (Best <> 0) and (Best <> Previous) then
      Result := Result + Characters[Best];
    Previous := Best;                       // ブランクがリピートガードをリセットする
  end;
end;
言語モデル付きのビームサーチは、貪欲デコードが取り違える曖昧なスライスの一部を解決できますが、速度の代償が現実に効いてくる上に、バージョン管理すべきファイルがもう1組増えます。300 DPIでレンダリングした印刷文書には貪欲デコードが正しいデフォルトであり、モデルが見えないものを補償する場所としてデコーダーは間違っています。文字置換テーブルにも同じことが言えます。モデルがアクセント付き文字を基底文字として読んだとき、置換テーブルで出力を継ぎ接ぎすると、ある言語は直り、別の言語は壊れます。検索可能レイヤーでの誤った文字は、欠けた文字よりたちが悪いです。検索が「文書なし」ではなく「誤った文書」を返すからです。それゆえ認識されたテキストは、モデルが出した通りそのままPDFへ入ります
右から左に読むアラビア語で、テキスト行はどう並ぶのか
DLLは検出されたテキストボックスを上から下へソートし、垂直方向に小さい方のボックス高の半分以上重なるボックスを1つの行へまとめ、各行を左から右へ、RightToLeftが設定されている場合は右から左へ並べます。認識された行の内側の文字が逆順にされることはありません。行のグルーピングが重要なのは、検出器が1つの視覚行を複数のボックスに分割することが珍しくなく、たとえばラベルと値が広い隙間を挟んで別々のボックスになり、素朴な上端座標ソートでは上端が1、2ピクセル違うだけで次の行と交互に混ざってしまうからです
ForLanguageがRightToLeft := Trueを設定するのはアラビア語プロファイルだけで、これによりDLLは各行をボックスの右端で並べ、右マージンから始めます。効果はそれだけでです。モデルが行について返すテキストはすでにUnicodeの論理順、つまりアラビア語の読者が読み、タイプする順になっており、PDFのテキスト抽出と検索が期待するのもこの順です。Delphiのデバッガで「見た目が正しい」ように文字列を反転させると、検索、コピー&ペースト、スクリーンリーダーが壊れます。双方向の表示とグリフの整形はPDFビューアーの担当です
1つのエンジンが1つの言語プロファイルを担当し、文字体系の自動判定はありません。複数の文字体系が混在する文書では、プロファイルごとに1つのエンジンを用意し、それぞれを自分のページに適用します。ApplyLoadedOCRTextLayerは明示的なページリストを受け取り、呼び出しごとを独立したトランザクションとしてコミットするので、アラビア語ページでの失敗はその呼び出しだけをロールバックし、すでに書き込まれた中国語のレイヤーには触れません
uses
  SysUtils, HPDFDoc, HPDFRapidOCRRecognition;

function CreateRapidEngine(const Tag: string): IHPDFOCREngine;
var
  Models: THPDFRapidOCRDLLOptions;
begin
  // リスト外のタグでEArgumentExceptionを上げる。どのモデルもロードする前に
  Models := THPDFRapidOCRDLLOptions.ForLanguage(Tag);
  Models.MaxPixels := 33554432;          // 300 DPIのA3ページ分の余裕
  Result := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models', Models);
end;

procedure OCRMixedArchive(Doc: THotPDF);
var
  Chinese, Arabic: IHPDFOCREngine;
  Layer: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  Chinese := CreateRapidEngine('zh-TW');  // chinese_chtプロファイル
  Arabic := CreateRapidEngine('ar-SA');   // arabicプロファイル、RightToLeft = True
  Layer := THPDFOCRTextLayerOptions.Default;
  if not Doc.ApplyLoadedOCRTextLayer([0, 1, 2], Chinese, Layer, Info) then
    raise Exception.Create(string(Info.Diagnostic));
  if not Doc.ApplyLoadedOCRTextLayer([3], Arabic, Layer, Info) then
    raise Exception.Create(string(Info.Diagnostic));
end;MaxPixelsの行には理由があります。リクエストあたり16,777,216ピクセルというデフォルト予算は、300 DPIのA4やUS Letterを余裕を持ってカバーします。300 DPIのA3は約3508×4961ピクセル、およそ1,740万ピクセルになるので、このリクエストは拒否され、Info.Diagnosticが無効なリクエストかピクセル予算超過を報告します。MaxPixelsを67,108,864の上限まで上げるか、大型フォーマットではTHPDFOCRTextLayerOptions.DPIを下げてください。右から左の並びはDLLエクスポートのHPDFRapidOCRSetReadingDirectionを通っていき、アダプターはRightToLeftが設定されたときだけこの関数をルックアップします。そのエクスポートを持たないDLLビルドでも左から右のプロファイルは使え、それでアラビア語エンジンを生成しようとすると、欠けているエクスポートの名前入りでEArgumentExceptionが上がります
固定されたモデルパックと、独自ペアが通すべき検査
HotPDF RapidOCR DLLは静的にリンクしたONNX Runtimeを抱えているため、そのランタイムが理解するONNXファイル形式のバージョンだけを読め、それより新しいものは読めません。最近のモデルエクスポートはより新しい形式を狙えるので、そういうファイルはエンジン生成時にネイティブの診断情報付きで拒否されます。言語パックがそれぞれ、同梱ランタイムの下でロードしクラス検査を通る1つの特定の認識器と辞書を指しているのはこのためで、「最新」を追いかけていないのも同じ理由です
Install-RapidOCRModels.ps1はこの組み合わせをディスク上で強制します。マニフェスト内のすべてのファイルはSHA256ハッシュを持ち、既存ファイルのハッシュが違っていればインストールは止まり、ファイルは移動も削除もあなたの判断に委ねてその場に残ります。ダウンロードは一時的な名前で書き込まれ、ハッシュが一致して初めて所定の位置へ移されます。これが辞書問題の静かな版を塞ぎます。誰かが手で新しいrecognition.onnxをプロファイルフォルダーへコピーし、クラス数がたまたま一致し、異変の最初の兆候が「見えている単語が検索で見つからない」という顧客の報告になる——あの展開を防げるのです。-SkipClassifier付きでインストールしたなら、オプションでUseAngleClassifier := Falseを設定してください。Defaultは分類器ファイルを期待し、エンジン生成はその存在を検査します
認識器はロード時にモデルの入力形状も検査します。受け付けるのは、高さが32か48ピクセルに固定されたNCHWのfloat入力、または動的高さ(実行時は48)です。それ以外の固定高さでエクスポートされたモデルは、エンジン生成時に「Unsupported recognition model input or output shape」で失敗します
9プロファイルのどれもカバーしない文字体系には、RecognitionModelとCharacterDictionaryを自分のファイルに向けることができ、上記の検査はすべて等しく適用されます。組み合わせの悪いペアはエンジン生成時に、つまりあなたのテスト実行の中で失敗します。RapidOCRのどのプロファイルも合わないページには、検索可能PDF向けのTesseractアダプターが同じApplyLoadedOCRTextLayer呼び出しに差し込め、機械印字のASCIIフォームには組み込みのテンプレートマッチングOCRエンジンがモデルファイルすら必要としません
言語プリセット、ネイティブRapidOCRアダプター、OCRテキストレイヤーはいずれも、Delphi、C++Builder、WindowsのFPC/Lazarusプロジェクト向けのHotPDF Delphi PDF Componentに含まれています