TerminateThreadは、1枚のスキャンページでUIが我慢できる時間を超えてOCRが回り続けているとき、それを止める方法として一見まっすぐに見えます。Windowsのドキュメントがなぜ駄目かを説明しています。対象スレッドがプロセスヒープロックを掴んでいると、そのロックは決して解放されず、別のどのスレッドの次の確保も永久にブロックしかねません。OCRを自分のプロセス内で走らせた以上、安全に止められるのは協調的な停止だけで、それは推論ステージの間のチェックポイントです。モデルを一度ロードして温かい状態を保つことの対価がこれです
多くのDelphiチームが最初に試す代替案は子プロセスです。ページごとのPythonワーカーはいつでも殺せるのが魅力的ですが、呼び出しごとにインタープリターを起動し、ランタイムをインポートし、1ピクセルも読む前に検出モデルと認識モデルをロードします。アーカイブジョブに500ページあると、この起動処理が500回走り、配備物にはネイティブ実行ファイルの隣にPython環境が付いて回ります
HPDFCreateRapidOCRDLLOCREngineでスキャンから検索可能PDFへ
HotPDFはHPDFCreateRapidOCRDLLOCREngineを通してRapidOCRをインプロセスで走らせます。この関数はHPDFRapidOCRRecognitionユニットで宣言されています。ファクトリーはHotPDFRapidOCR.dllをロードし、ONNXの検出モデル、オプションの角度分類、認識モデルを一度だけ初期化して、IHPDFOCREngineを返します。このエンジンは他のOCRエンジンとまったく同じようにTHotPDF.ApplyLoadedOCRTextLayerに差し込めます。ドキュメントが各ページをレンダリングし、DLLがその上でCPU推論を回し、結果は不可視のUnicodeテキストレイヤーとしてコミットされます。Pythonも子プロセスもありません。アダプターはDelphi、C++Builder、Windows FPC/Lazarusビルド向けに出荷されます
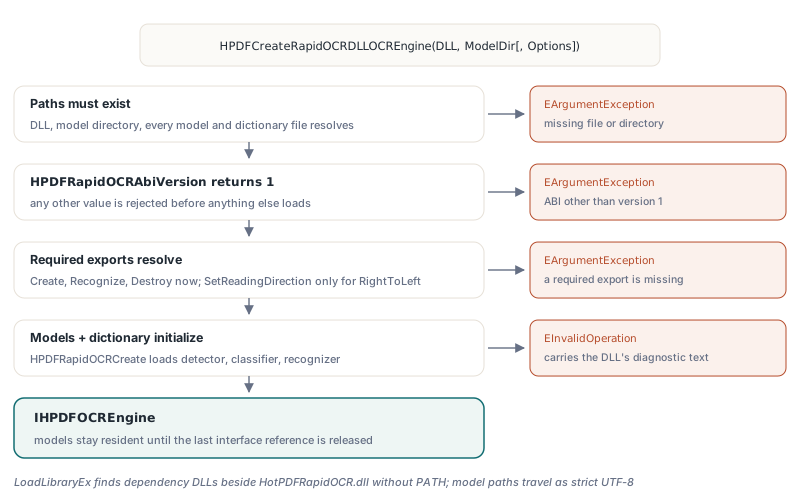
検証はファクトリーで、どのページにも触れる前に行われます。すべてのモデルと辞書ファイルが解決できること、HPDFRapidOCRAbiVersionが1を返すこと、必須エクスポートが揃っていることが、HPDFRapidOCRCreateがモデルを組み立てる前に必要です。設定の誤りはEArgumentExceptionを上げ、ロードを拒むモデルはDLL自身の診断——たとえば認識モデルと一致しない辞書——付きでEInvalidOperationを上げます
uses
  SysUtils, HPDFTypes, HPDFDoc, HPDFRapidOCRRecognition;

procedure MakeSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // モデルはここでロード。どの認識デッドラインよりも外側の位置
  // THPDFRapidOCRDLLOptions.Defaultの相対名はモデルディレクトリーに
  // 対して解決される
  Engine := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models');
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default;  // 300 DPI、MinimumConfidence 0.5
    // 空のページリスト=全ページ。SkipPagesWithTextはデフォルトでTrue
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' lines accepted, ', Info.DroppedWordCount, ' dropped');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;THPDFRapidOCRDLLOptions.Defaultはch_PP-OCRv3_det_infer.onnx、ch_PP-OCRv3_rec_infer.onnx、ch_ppocr_mobile_v2.0_cls_infer.onnx、ppocr_keys_v1.txtを指し、CPUスレッド1、入力上限16,777,216ピクセル、認識呼び出しごとの60,000 msデッドラインを持ちます。他の文字体系では、THPDFRapidOCRDLLOptions.ForLanguageがこれらのデフォルトを保ったまま、繁体字中国語やキリル文字からアラビア語、デーヴァナーガリーまで9プロファイルのどれかについて、<profile>/recognition.onnxと<profile>/dictionary.txtへ差し替えます。1エンジン1言語で、ページごとかドキュメントごとにプロファイルを選びます。モデルと辞書が常にペアで旅する理由は、HotPDFのRapidOCR多言語モデルとCTC辞書の記事で扱っています
エンジンはInfo.EngineNameで自分をRapidOCR (native DLL)と報告します。この文字列をログに残してください。同じサービスが外部Tesseract OCRプロセスアダプターや組み込みテンプレートマッチングOCRエンジンも走らせているなら、問題のページを作ったのがどの認識器かを見分ける最短ルートになります
C ABIがint32_tとUTF-8バイトしか話さない理由
HotPDFRapidOCR.dllの境界が固定幅整数、生ポインター、明示的なバイト長を使うのは、Delphi、C++Builder、Free PascalがMSVCとC呼び出し規約以外に何も共有していないからです。std::stringもstd::vectorもC++例外も、1つのコンパイラと1つのランタイムライブラリーに属するメモリレイアウトとアンワインディングモデルを抱えており、そのどれかをPascalコードに渡すと、壊れたスタックか、間違ったアロケーターに解放されるヒープブロックで終わります
ABIバージョン1は短い規則のリストです。すべてのエクスポートはcdeclでint32_tのステータスを返します。成功が1、失敗が0です。失敗しうる関数はすべて、呼び出し元所有の診断バッファーとそのバイト数を受け取り、DLLは収まるように切り詰めたNUL終端のUTF-8メッセージを書き込みます。DLLの内側では、各エクスポート本体がcatch (const std::exception &)とcatch (...)の両方を持つtryに収められます。ONNX RuntimeのエラーもOpenCVのアサーションも不正な辞書も、ステータス0とテキストになります
| エクスポート | 役割 | アダプターが解決するタイミング |
|---|---|---|
HPDFRapidOCRAbiVersion | 1を返す。それ以外の値は拒否される | DLLロード直後 |
HPDFRapidOCRCreate | 検出、オプションの分類、認識モデルと辞書をロードする | ファクトリーの中 |
HPDFRapidOCRRecognize | 1つのビットマップを処理し、テキスト行ごとに1つのコールバックを出す | ファクトリーの中 |
HPDFRapidOCRDestroy | モデルインスタンスを解放する | ファクトリーの中 |
HPDFRapidOCRSetReadingDirection | オプションの右から左の行順 | RightToLeftが設定されているときだけ |
読み方向のエクスポートが遅延解決なのは意図的で、それなしでビルドされたDLLでも、左から右のリクエストはすべて処理できます。アダプターはLoadLibraryExと、DLL自身のフォルダーとデフォルトの安全なディレクトリーをカバーする検索フラグでライブラリーをロードするので、HotPDFRapidOCR.dllの隣に置かれたONNX RuntimeやOpenCVの依存物はPATHをいじらなくても見つかります。モデルと辞書のパスはUTF-8で境界を渡り、DLLはワイド文字APIでファイルを開く前にMultiByteToWideCharのstrictモードで変換します。C:\Users\Łukaszの下のモデルディレクトリーも、キリル文字のユーザー名も普通に開きます
1つの規則だけはヘッダーではなくビルドファイルに住んでいます。DLLはONNX RuntimeとOpenCVを静的リンクし、CMakeプロジェクトはデフォルトで静的リリースCRT(/MT)です。/MDでコンパイルされた静的ライブラリーを混ぜると、運が良ければリンクエラー、悪ければ2つの独立したヒープになります。DLLと同じCRTモードでビルドされたライブラリーを調達してください
TBitmapとテキスト行の間で何が起きるのか
HotPDFはDLLに、レンダリングしたページの独立したトップダウンBGRコピーを渡し、DLLは認識した行ごとに1つのコールバックで返します。そのコールバックのテキストは借り物です。ポインターはコールバックが返るまでしか有効でないので、アダプターはその場でコピーします
Delphiではスナップショットはpf24bitに強制したプライベートなTBitmapから、負のbiHeightを使うGetDIBitsで読まれます。これで4バイト境界にパディングされたトップダウンの行が得られ、ストライドは明示的な引数としてDLLへ渡ります。FPCではアダプターはCreateIntfImage経由で読みます。呼び出し元のビットマップが変更されることはありません。サイズ検査はコピーを確保する前に走ります。1辺あたり最大32,767ピクセル、合計はMaxPixels以下で、デフォルトは16,777,216、67,108,864まで上げられます
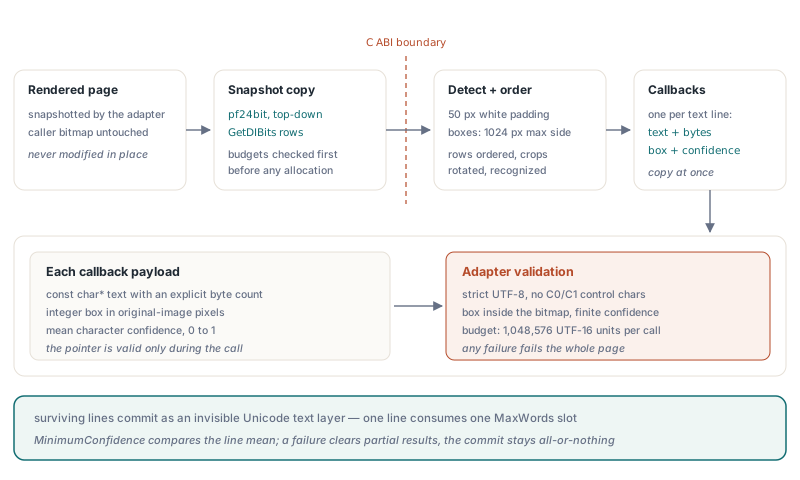
DLLの内側では、画像に50ピクセルの白い縁が付き、長辺を最大1,024ピクセルにスケールしてテキスト領域が検出され、ボックスは水平の行へソートされます。角度分類器が有効なとき、クロップは逆さスコアが0.9を超えたときだけ180度回され、弱い予測が短い単語を裏返すのを防ぎます。各行はconst char*、バイト数、元画像ピクセルの整数ボックス、平均文字信頼度として届きます。アダプターが受け入れるものには厳密です
- UTF-8は
MB_ERR_INVALID_CHARS付きでデコードされるので、不正なバイト列はページを失敗させ、検索可能レイヤーに置換文字を植えたりしません - C0とC1の制御文字は拒否され、空白だけの行はスキップされます
- ボックスはビットマップの内側になければならず、信頼度は0から1の有限値でなければなりません
- テキストはリクエストの
MaxTextCodeUnitsにカウントされ、呼び出しあたり1,048,576 UTF-16単位のハード上限があります。基本多言語面の外の文字は2単位消費します - コールバック内のPascal例外はそこで捕捉され、保存され、0リターンに変換されてDLLを止めさせます。保存されたメッセージが
Info.Diagnosticになります
このうち2つの詳細は出力を調整するときに効いてきます。単位は行であって単語ではありません。各行がMaxWordsスロットを1つ消費し、Info.AcceptedWordCountとInfo.DroppedWordCountは行を数え、検索ヒットは行ボックス全体をハイライトします。そしてMinimumConfidenceは行の平均文字信頼度と比較されるので、20文字のきれいな文字の中の1つの汚れはめったに行を沈めません。しきい値を0.7や0.8に上げると落ちるのは行全体であって単一の文字ではありません。空白のページはゼロ行で成功し、どんな失敗も部分結果を破棄するので、複数ページのコミットは全か無かです
1エンジン、1モデルコピー、同時に1呼び出し元
RapidOCR DLLエンジンはその生涯でちょうど1つのモデルインスタンスを所有し、そのエンジンへのRecognize呼び出しはクリティカルセクションで直列化されます。IHPDFOCREngine参照を掴んでいること自体がモデルをメモリに留める手段なので、バッチ処理はエンジンを一度作り、全ドキュメントで使い回すべきです
procedure OcrBatch(const Files: TStrings; const OutputDir: string);
var
  Models: THPDFRapidOCRDLLOptions;
  Engine: IHPDFOCREngine;
  Doc: THotPDF;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
  I: Integer;
begin
  Models := THPDFRapidOCRDLLOptions.ForLanguage('ru-RU');
  Models.UseAngleClassifier := False;    // 正立スキャン:分類器モデルはロードしない
  Models.Threads := 4;                   // 1..64、アクティブなプロセッサー数にクランプ
  Models.TimeoutMilliseconds := 120000;  // Recognize呼び出しごと、協調的
  Engine := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models', Models);
  Options := THPDFOCRTextLayerOptions.Default;
  for I := 0 to Files.Count - 1 do
  begin
    Doc := THotPDF.Create(nil);
    try
      Doc.AutoLaunch := False;
      if (Doc.LoadFromFile(Files[I]) > 0) and
        Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
        Doc.SaveLoadedDocument(IncludeTrailingPathDelimiter(OutputDir) +
          ExtractFileName(Files[I]))
      else
        Writeln(Files[I], ': ', string(Info.Diagnostic));
    finally
      Doc.Free;
    end;
  end;
end; // 最後の参照が解放される:モデルが破棄され、その後DLLがアンロードされるThreadsはエンジン内の全ONNXセッションのintra-opとinter-opのスレッド数を両方設定し、DLLはそれをアクティブなプロセッサー数にクランプします。1つのエンジンを2つのスレッドが共有しても推論が並列に走ることはなく、2つ目は待ちます。この待ちは盲目的なEnterCriticalSectionではありません。アダプターはTryEnterCriticalSectionでロックを試み、試行の間に25 ms眠り、そのたびにキャンセルトークンとデッドラインを確認するので、列に並んでいるリクエストでもキャンセルできます
デッドラインの時計は、ロックが取られる前のRecognizeに入った時点で始まります。別のページの後ろに列んでいた時間もTimeoutMillisecondsにカウントされます。1エンジンに4ワーカースレッドと60秒のデッドラインという組み合わせでは、4枚目のページはモデルに届かないままタイムアウトしかねません。代わりにワーカーごとに専用エンジンを与えてください。エンジンごとにモデル1コピー分のメモリを食いますが、そのメモリが予測可能なタイムアウトと本当の並列性を買っています。1エンジンの共有が意味を持つのは、リクエストがほとんど列を作らないほど希なときだけです
ネイティブOCRの呼び出しを推論の途中で殺せない理由
ネイティブRapidOCR呼び出しが推論の途中で殺せないのは、それがあなたのスレッド上、あなたのプロセス内で、実行中のRunに中断APIを持たないONNX Runtimeセッションの最中に走っているからです。DLLアダプターのキャンセルは協調的です。DLLは検出の前後、クロップごとの分類の後、認識した行ごとの後にabortコールバックを呼び、コールバックが0を返した最初のチェックポイントで止まります。すでに始まった1回のRunは先に終わります
強制的な選択肢は待つことより悪いです。TerminateThreadならCRTのヒープロック、ONNX Runtimeのスレッドプール、OpenCVの状態を、その瞬間の状態のまま放置します。呼び出しがまだ実行中にFreeLibraryを呼ぶと、スタック上にあるコードをアンマップします。どちらも安全にできません。だからアダプターは決して試みません。期限切れはタイムアウトの診断付きのotlsEngineErrorで返り、キャンセルされたトークンはotlsCancelledで返ります
// Tokenは呼び出し元が作りUIスレッドと共有するもので、
// ユーザーがStopを押すとUIスレッドがToken.Cancelを呼ぶ
function OcrWithStop(Doc: THotPDF; const Engine: IHPDFOCREngine;
  Token: THPDFCancellationToken): Boolean;
var
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  Options := THPDFOCRTextLayerOptions.Default;
  Options.CancellationToken := Token;
  Result := Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info);
  if not Result then
    case Info.Status of
      otlsCancelled:
        // 次のステージか行のチェックポイントで停止。ドキュメントは無変更
        Writeln('Cancelled');
      otlsEngineError:
        // 協調的デッドラインの失効とネイティブ診断を含む
        Writeln('Engine: ', string(Info.Diagnostic));
      otlsBudgetExceeded:
        // Optionsのページ、ピクセル、単語、コンテンツ上限に到達した
        Writeln('Budget: ', string(Info.Diagnostic));
    else
      Writeln(string(Info.Diagnostic));
    end;
end;
これがプロセスアダプターとインプロセスDLLの本当のトレードオフであり、どちらの側もすべての項目で勝つわけにはいきません
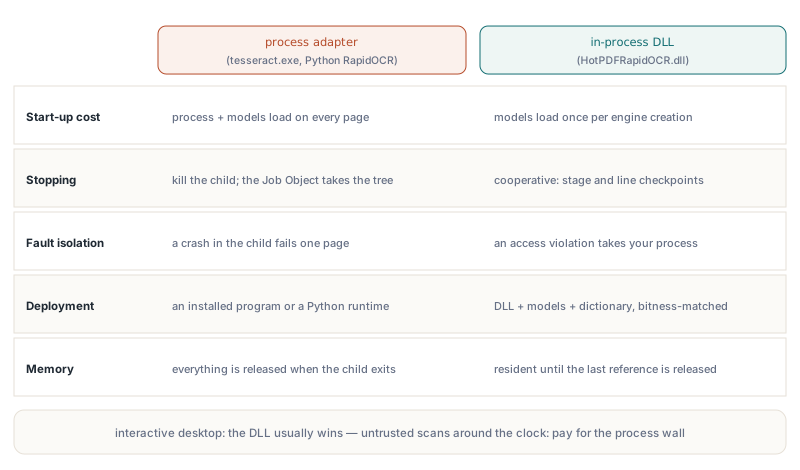
- 起動コスト:TesseractとPythonのRapidOCRアダプターはページごとにプロセスを起動してモデルをロードします。DLLはエンジンごとに一度だけモデルをロードします
- 停止:子プロセスは丸ごと終了でき、Pythonワーカーはクローズ時に殺すJob Objectの内側で走るのでプロセスツリーごと連れて行かれ、DLLはステージと行のチェックポイントで止まります
- 障害封じ込め:
tesseract.exeのクラッシュは1ページを失敗させます。DLLの内側のアクセス違反はあなたのプロセスを持ち去ります - 配備:プロセスアダプターにはインストール済みのプログラムかPython環境が要ります。DLLにはDLL自身、モデル、辞書が要り、アプリケーションのビットネスと一致させてください
- メモリ:プロセスアダプターは子の終了とともにすべてを解放します。DLLエンジンは最後のインターフェース参照が消えるまでモデルを常駐させます
1ページずつOCRし、1推論ステージ以内で返ってくる反応の良いStopボタンが必要な対話型デスクトップアプリケーションにはDLLを選んでください。信頼できないスキャンを昼夜問わず取り込むサーバーでは、ページごとの起動コストを払ってプロセス境界を保ってください。認識器をクラッシュさせる細工済み画像が費用的なのは1ページだけであり、子プロセスならそれが実現します
HotPDFRapidOCR.dllのビルドとモデル選び
HotPDFRapidOCR.dllはNative/RapidOCRのC++ソースから、MSVC、C++17、Windows SDK、CMake 3.20以降でビルドします。tools/Build-HotPDFRapidOCR.ps1ヘルパーはネイティブソース、ONNX Runtime、OpenCVの各ディレクトリーに-Platform Win32かWin64を取り、結果をLib/Native/RapidOCR/<Platform>/に書きます。両方を出荷するなら両方ビルドしてください。32ビットのDelphiアプリケーションは64ビットDLLをロードできず、調達する静的ライブラリーもCRTモードだけでなくターゲットアーキテクチャーに一致していなければなりません
モデルには独自の互換性規則があります。検出器はDBテキスト検出器です。認識器はNCHWレイアウトで入力高さが32か48に固定されたCTCモデルを受け付け、モデルが動的高さを宣言していれば48を使います。モデル形式は静的リンクしたONNX Runtimeが理解できるものでなければならず、PP-OCRv5のような新しいエクスポートはより新しいランタイムを要求することがあり、読めないモデルは診断付きで初期化に失敗します。tools/Install-RapidOCRModels.ps1は固定したSHA256ハッシュで検証済みのPP-OCRv3とPP-OCRv4パックを、Defaultが期待するファイル名で共有の検出器と分類器込みでインストールします。ランタイムのビルドも自分で管理しない限り、これらのパックにとどまるのが無難です
辞書はBOMなしUTF-8で、モデルの文字順と寸分違わず同じ順で、エントリー数はモデルの出力クラス数と一致しなければなりません。CRLFの行末は構いません。モデルがメタデータに自分の文字リストを埋め込んでいる場合、モデル初期化はすべてのエントリーとその位置を辞書ファイルと比較するので、長さだけ合う辞書でも失敗します。DLLが欠けたモデルをダウンロードすることはありません
HotPDFはネイティブRapidOCRアダプターを、プロセスベースのOCRアダプター、それらへビットマップを供給するページレンダラー、不可視Unicodeテキストレイヤーライターとともに、DelphiとC++Builder向けの1つのネイティブVCLコンポーネントに同梱しています。Pythonがインストールされていないマシンでも検索可能PDFを出さなければならないキャプチャーやアーカイブソフトウェアには、HotPDF Delphi PDF componentが配備すべきものをDLLとそのモデルファイルだけにしてくれます