EOF を報告しないパイプは、OCR 機能で追いかけるには風変わりなバグです。アプリケーションの 1 つのスレッドがヘルパープログラムの標準出力を読み、ReadFile が ERROR_BROKEN_PIPE で失敗するのを待ちます。別のスレッドは bInheritHandles を True にして CreateProcess で tesseract.exe を起動します。標準エラー用にファイルを子プロセスへ渡すには、そうするしかないからです。ヘルパーのパイプ書き込み端は継承可能だったため、Tesseract はそのコピーを所有し、読み取りスレッドは Tesseract がページを終えるまで固まります—2 つの言語モデルをロードした 300 DPI のスキャンでは、それは速くありません
外部認識器は固まり以上のものを運びます。子に何が見えるか、半分妥当な出力をどう扱うか、ピクセルボックスを検索可能 PDF テキストへどう変えるかです。組み込みテンプレートマッチング OCR エンジンは意図的に、機械印字の ASCII 英数字だけをカバーします。アクセント付きの名前、中国語の契約書、混在言語のアーカイブには学習済み言語モデルが要り、Tesseract が定番の候補です。実行ファイルの隣に置けるコマンドラインプログラムですから
Tesseract を HotPDF の OCR テキストレイヤーへ差し込む
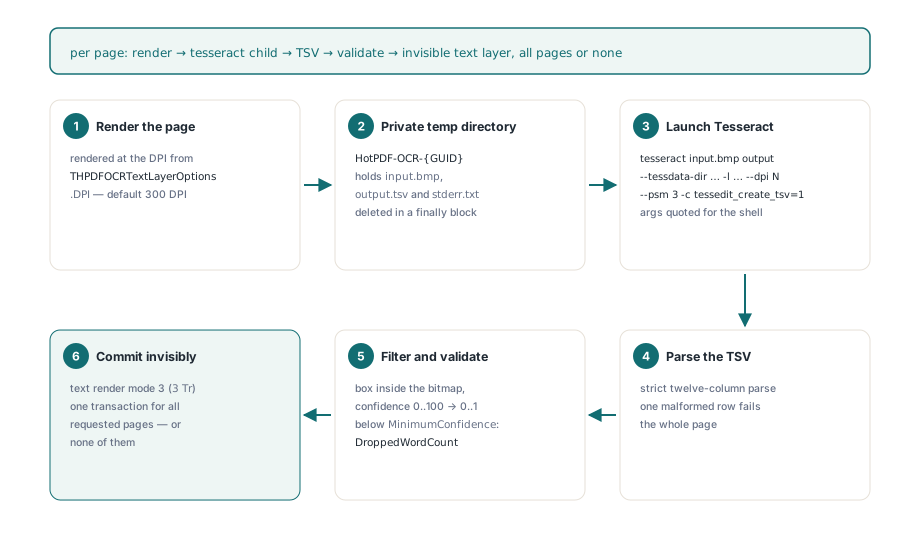
HotPDF はローカルにインストールされた Tesseract 実行ファイルを、HPDFTesseractRecognition ユニットの HPDFCreateTesseractOCREngine 経由で IHPDFOCREngine として包みます。そのエンジンを THotPDF.ApplyLoadedOCRTextLayer へ渡すと、要求された各ページをレンダリングし、ページごとに Tesseract を 1 回走らせ、単語をフィルタし、要求された全ページの不可視 Unicode テキストレイヤーを 1 つのトランザクションで、あるいは 1 ページも書かずに書き込みます。座標マッピング、回転、信頼度フィルタリング、コミットは組み込みエンジンが既に使うパイプラインであり、変わるのは認識だけです
ファクトリーはどのページにも触れる前に EArgumentException を上げます。実行ファイルと tessdata ディレクトリーが存在すること、タイムアウトが 1 から 3,600,000 ミリ秒の間であること、言語には ASCII の英字、数字、_、+ しか入れられないこと。言語は最終的にコマンドラインの上に乗るからです。eng+chi_sim は正当であり、引用符やスペースを含む値は発生待ちの注入です。2 つ目のオーバーロードは THPDFTesseractOptions レコードを受け取ります。その Default は --psm 3、--oem 3、ページあたり 60 秒、16,777,216 ピクセルの上限を与え、単語を返さない 2 つのモード tpsOSDOnly と tpsAutoOnly を拒否します
uses
  SysUtils, HPDFTypes, HPDFDoc, HPDFTesseractRecognition;

function MakeSearchable(const SourceFile, TargetFile: string;
  Token: THPDFCancellationToken): Boolean;
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  TessOptions: THPDFTesseractOptions;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  TessOptions := THPDFTesseractOptions.Default; // psm 3、oem 3、60 秒、16,777,216 px
  TessOptions.TimeoutMilliseconds := 120000;    // 各ページに適用される
  // 欠けた実行ファイルや tessdata フォルダー、悪い言語識別子、
  // 範囲外のオプションで EArgumentException を上げる
  Engine := HPDFCreateTesseractOCREngine(
    'C:\OCR\Tesseract\tesseract.exe',
    'C:\OCR\Tesseract\tessdata',
    'eng+chi_sim',                              // モデルは '+' で連結
    TessOptions);
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default; // 300 DPI、MinimumConfidence 0.5
    Options.CancellationToken := Token;
    // 空のページリストは全ページの意味。テキストを既に持つページはスキップされる
    Result := Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info);
    if Result then
    begin
      Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
        ' words kept, ', Info.DroppedWordCount, ' below the threshold');
      Doc.SaveLoadedDocument(TargetFile);
    end
    else
      case Info.Status of
        otlsCancelled:      Writeln('Cancelled, document unchanged');
        otlsEngineError:    Writeln('Engine: ', string(Info.Diagnostic));
        otlsBudgetExceeded: Writeln('Budget: ', string(Info.Diagnostic));
      else
        Writeln(string(Info.Diagnostic));
      end;
  finally
    Doc.Free;
  end;
end;
ピクセルの算術は 1 回だけやりましょう。300 DPI の A4 ページは約 2,481 × 3,508 ピクセル、およそ 870 万で、収まります。同じ解像度の A3 ページは約 3,508 × 4,961、1,740 万近くになり、ピクセル予算の診断で失敗し、実行は otlsEngineError として終わります。タイムアウトだけを受け取るオーバーロードはピクセル上限をまったく適用しません。外からファイルを受け取るサービスでは、オプションのオーバーロードを使い、大きなフォーマットが予想されるときには MaxPixels を上げるか(最大 67,108,864)、THPDFOCRTextLayerOptions.DPI を意図的に下げてください
ページごとに、エンジンはテンポラリーパスの下にプライベートな HotPDF-OCR-{GUID} ディレクトリーを作り、ビットマップを input.bmp として保存し、tesseract input.bmp output --tessdata-dir … -l … --dpi N --psm 3 -c tessedit_create_tsv=1 を実行し、エンジンモードが設定されているときは --oem を足します。パスはバックスラッシュと埋め込み引用符の Windows 規則で引用符付きになり、--dpi はレンダリング解像度を運ぶため、Tesseract がそれを当て推量することはありません。Tesseract とその .traineddata ファイルは同梱されず、調達はアプリケーションの仕事です。私たち自身の Linux テストマシンでは、認識器はバイナリーとその共有ライブラリー閉包と tessdata フォルダーのユーザーレベルバンドルから走ります。/usr/bin/tesseract に頼るのは、誰かがシステムパッケージを入れた場所でしか機能しないからです
なぜ 1 つの壊れた TSV 行がページ全体を空にするのか
Tesseract アダプターは最初の不正な行でページ全体を失敗させます。部分的にパースされた単語リストは画像と食い違うテキストレイヤーを作り、保存された PDF のどこにも、どの単語が消えたかは書いていないからです。出力は埋め込み NUL なしの厳格な UTF-8 としてデコードできなければなりません。最初の行は、任意のバイトオーダーマークを剥いだ後、Tesseract の 12 列ヘッダー、level から text まで、と等しくなければなりません。各行はきっかり 12 フィールドへ分割できなければならず、分割は 11 番目のタブの後で止まるため、認識テキストの中のタブは 13 列目を作らずテキストフィールドに着地し、下の制御文字検査がそれを拒否します
レベル 5 の行だけが単語です。ページ、ブロック、段落、行の行はスキップされ、空や空白だけの単語もスキップされます。制御文字(U+0020 未満、または U+007F から U+009F)を含む単語はページを失敗させます。残りには、整数の幾何、ドイツロケールのアプリケーションでも 93.5 を読めるように不変フォーマットでパースされた信頼度、ビットマップの完全に内側のボックス、0 から 100 の信頼度が要ります。1 つの妥当な単語の後に 1 つの壊れた行が来ると、単語はゼロになります
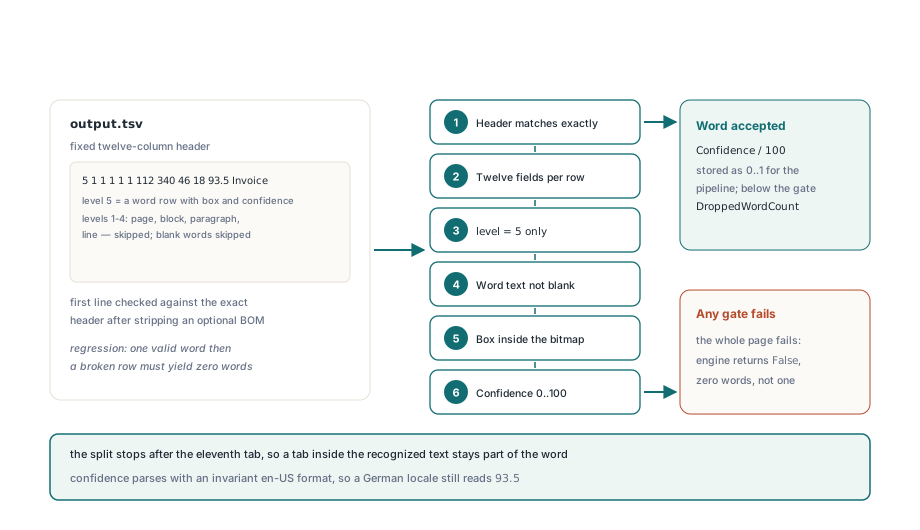
だから 1 つの変な行が実行全体を失敗させ、すべてのページに触れません。それが正しい取引きです。再実行は安い。請求書番号の検索が、いちばん大事なそのページだけ外れる検索可能 PDF は、数か月後、他人の手の中で表面化しがちです
最後のステップは、予想外かもしれないデフォルトにも出会います。Tesseract は信頼度を 0 から 100 で報告し、パイプラインは 100 で割り、THPDFOCRTextLayerOptions.MinimumConfidence はデフォルトで 0.5 です。50 未満の単語はすべてページでなく Info.DroppedWordCount に落ちます。きれいなスキャンではこの床は理にかなっています。ノイズの多いファックスではテキストの大部分を奪いかねないため、下げる前に Info.ReceivedWordCount と Info.AcceptedWordCount を比較してください
既にテキストを持つファイルで OCR をもう一度走らせる
SkipPagesWithText はデフォルトで True であり、2 回目に人を捉えます。バッチが eng で処理され、今は eng+deu が要るとしましょう。すべてのページは既に不可視テキストを運ぶため、Info.SkippedPageCount はページ数と等しくなります。HotPDF は自分が書くコンテンツストリームに自分の OCR レイヤーの印を付け、ReplaceExistingOCRTextLayer はその印を使ってそれらのページを再認識し、古いレイヤーを落とし、元のページ内容を保ちます
Options := THPDFOCRTextLayerOptions.Default;
Options.ReplaceExistingOCRTextLayer := True;  // 前に書いた自分のレイヤーを入れ替える
Options.UseOptionalContentGroup := True;      // 'OCR Text Layer' という名のレイヤー
Options.CancellationToken := Token;
if Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
  Writeln(Info.ReplacedPageCount, ' replaced, ',
    Info.SkippedPageCount, ' skipped, ',
    Info.RecognizedPageCount, ' recognized')
else
  Writeln(string(Info.Diagnostic));
スキャナードライバーが OCR したファイルはそういう印を運ばないため、そのページは依然としてテキストのあるページとして数えられます。SkipPagesWithText を切ると、最初の層の上に 2 つ目の不可視レイヤーが積まれ、すべての検索ヒットが 2 回現れます。そういうファイルは放置してください
Tesseract プロセスはどのハンドルを継承するのか
Tesseract 子プロセスが HotPDF から継承するのはきっかり 2 つのハンドルです。標準入力と標準出力のために NUL 上で開いたものと、プライベートディレクトリーの stderr.txt 用のものです。上のパイプ固まりは CreateProcess 自体から来ます。標準ハンドルを渡すには bInheritHandles = True が必要で、それだけだとホストの中のすべての継承可能ハンドル、無関係なコードが開いたパイプ、ファイル、イベント込みで渡されます。HotPDF は PROC_THREAD_ATTRIBUTE_HANDLE_LIST を運ぶ属性リスト付きの STARTUPINFOEX と EXTENDED_STARTUPINFO_PRESENT フラグを使います。bInheritHandles は True のままですが、境界を越えるのはリストされたハンドルだけです
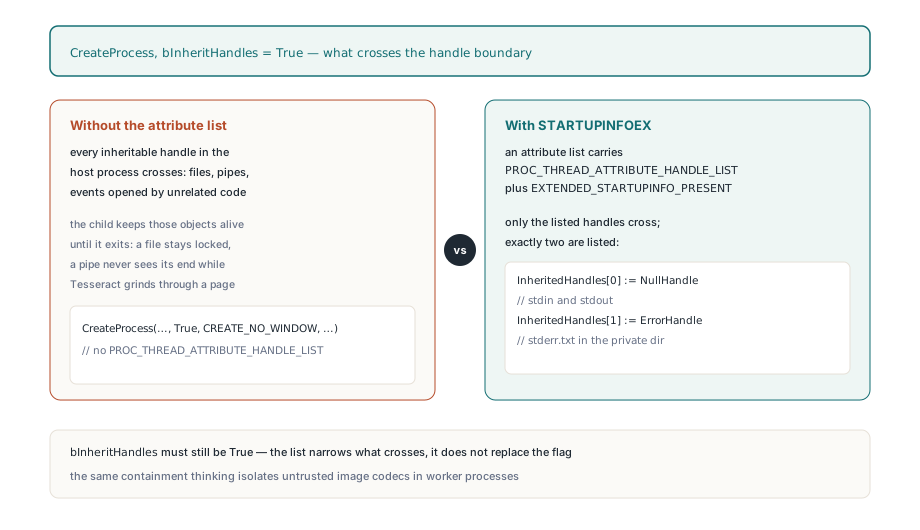
同じパターンは、アプリケーションが起動する他のすべての子プロセスにも属します。すべてを継承するランチャー 1 つで、プロセスの中のすべてのパイプリーダーが固まりますから:
// 自分の CreateProcess 呼び出し向けのパターン(断片:NullHandle、ErrorHandle、
// Exe、CommandLine、WorkDir、ProcessInfo は別の場所で宣言済み)。
// 古い Delphi RTL は属性リスト関数を宣言しない。コンパイラが見つけられないなら
// kernel32 からの external 宣言を自分で足す
// 本番コードでは各 BOOL の結果を検査する
type
  TStartupInfoExRec = record
    StartupInfo: TStartupInfo;
    AttributeList: Pointer;
  end;
const
  HANDLE_LIST_ATTRIBUTE = $00020002;   // PROC_THREAD_ATTRIBUTE_HANDLE_LIST
  EXTENDED_STARTUP_FLAG = $00080000;   // EXTENDED_STARTUPINFO_PRESENT
var
  Startup: TStartupInfoExRec;
  HandleList: array[0..1] of THandle;
  Size: NativeUInt;
begin
  FillChar(Startup, SizeOf(Startup), 0);
  HandleList[0] := NullHandle;         // bInheritHandle = True で作成済み
  HandleList[1] := ErrorHandle;        // 同様
  Size := 0;
  InitializeProcThreadAttributeList(nil, 1, 0, Size);
  GetMem(Startup.AttributeList, Size);
  InitializeProcThreadAttributeList(Startup.AttributeList, 1, 0, Size);
  UpdateProcThreadAttribute(Startup.AttributeList, 0, HANDLE_LIST_ATTRIBUTE,
    @HandleList[0], SizeOf(HandleList), nil, nil);
  Startup.StartupInfo.cb := SizeOf(Startup);
  // …dwFlags と hStdInput / hStdOutput / hStdError を通常通り設定…
  CreateProcess(PChar(Exe), PChar(CommandLine), nil, nil,
    True,                              // ハンドルリスト付きでも依然として必要
    CREATE_NO_WINDOW or EXTENDED_STARTUP_FLAG,
    nil, PChar(WorkDir), Startup.StartupInfo, ProcessInfo);
  // 子の終了後:DeleteProcThreadAttributeList、FreeMem、CloseHandle
end;
ブリッジスクリプトはもう 1 つの Windows の細部を足します。Python ランチャーは 2 つ目のインタープリタープロセスを起動でき、自分が作ったプロセスを終了させてもそれが走り続けます。エンジンにスクリプトパスを与えるとき、下の RapidOCR アダプターのように、HotPDF は子をサスペンド状態で起動し、JOB_OBJECT_LIMIT_KILL_ON_JOB_CLOSE 付きのジョブオブジェクトへ割り当て、それから再開するため、ジョブを閉じるとツリー全体が終わります。同じ封じ込めの発想が、子が信頼されないワーカープロセスでの PDF 画像コーデックの隔離を駆動します。ここでは子は信頼されますが、ハンドルを保持しているのは自分のプロセスだけではありません
キャンセル、タイムアウト、全か無かのコミット
IHPDFOCREngine.Recognize は 1 つの Boolean を返し、False は「Tesseract が失敗した」と「ユーザーが Cancel を押した」の両方をカバーします。アダプターは Tesseract が走っている間、トークンとタイムアウトを 25 ミリ秒ごとにポーリングし、キャンセルでは後片付けをして False を返します。額面通りなら otlsEngineError と読めるため、ApplyLoadedOCRTextLayer は Recognize が False を返すたびにまずトークンを確認します。認識とコンテンツ構築は、ドキュメントトランザクションが開く前に要求された全ページに対して終わるため、50 ページ中 40 ページでのキャンセルは otlsCancelled を報告し、ロードされた 50 ページ全部をそのまま残します。他の上限も同じ流儀に従います:
- タイムアウトは各
Recognize呼び出しの開始から走るため、60,000 ms のデフォルトはページごとの上限です - タイムアウトやキャンセルの時点でまだ走っている子は終了させられ、最大 5 秒待ち合わせます。プライベートディレクトリーは
finallyブロックの中で削除され、プロセス終了後も出力ファイルが短時間ロックされたままになり得るため、削除は最大 1 秒リトライされます output.tsvは 64 MiB に、stderr.txtは 1 MiB に打ち止められ、子の走行中と終了後に検査されます- ページあたりの単語数と UTF-16 コード単位は、
MaxWordsPerPage、MaxTotalWords、MaxTextCodeUnitsの残りで打ち止められます。越えるとリストを切り詰める代わりに実行を失敗させます - ゼロでない終了コードは、
stderr.txtの最大 4,096 文字付きで返ってきます。.traineddataファイルが欠けていると知る最速の方法です
不可視テキストレイヤーはページの内側でどう見えるのか
HotPDF は単語をテキストレンダリングモード 3(フィルもストロークもしない、ISO 32000-1 §9.3.6)で書くため、スキャンは見えたまま、検索とコピーは単語の上で動きます。コンテンツストリームは 3 Tr 付きで BT を開き、各単語はベースラインに Tm マトリクス、ボックス高さピクセル × 72 ÷ レンダリング DPI のフォントサイズ、ランをボックス幅へ伸ばす Tz スケールを受け取ります。この伸びが、画像の中のその単語の上に検索ハイライトを保ちます
TSV にはボックスはあってもベースラインがないため、各ベースラインは下端からボックス高さの 5 分の 1 上に置かれます。ラテンやキリルのようなスペース区切りの文字体系の左から右の行で隣接する単語の間では、伸ばしたスペースが隙間を埋めるため、コピーされたテキストは単語区切りを保ちます。中国語にはそれがありません。グリフは Identity-H エンコーディングと生成された ToUnicode CMap を持つ共有の非埋め込み Type0 フォントを通り、異なる Unicode スカラーごとに 1 つの CID が割り当てられます。中国語、アクセント付きラテン、補助平面の文字がコピーと検索を生き延びるのはこのやり方です。1 つのランは最大 65,535 の異なるスカラーを保持し、ISO 19005 は埋め込みフォントを要求するため、PDF/A 出力には適合フォントを別途埋め込む必要があります。結果を確認するには、保存し、再ロードし、ロード済み PDF からテキストを抽出するの普通の経路を走らせます。期待した単語が期待したページから返ってくれば、レイヤーは本物です
同じ契約の上の RapidOCR とネイティブ DLL
簡体字中国語のスキャンには、HPDFCreateRapidOCREngine(PythonExecutable, BridgeScript, ModelDirectory, TimeoutMilliseconds) が同じプロセスランナーと TSV パーサーを再利用します。ブリッジスクリプトパスは Python 実行ファイルに従い、言語は chi_sim に固定です。HotPDF はブリッジを tools/OCR/rapidocr_tsv.py として同梱します。rapidocr と onnxruntime パッケージ、ローカルの ONNX モデル、フォントファイルが要り、自動ダウンロードを拒否し、Tesseract 形状の TSV を書きます。THPDFRapidOCROptions オーバーロードがモデルファイル、スレッド数、ピクセル上限を設定します。両アダプターの背後の汎用ファクトリー、HPDFLocalTSVRecognition の HPDFCreateLocalTSVOCREngine は、Tesseract 流の引数を受け取り 12 列の TSV を書く任意のプログラムを受け入れ、ハンドルリスト、タイムアウト、キャンセル、予算を継承します
HPDFCreateTesseractDLLOCREngine(LibraryPath, TessDataDirectory, Language) はその代わりに Tesseract C API をインプロセスでロードし、Tesseract (native DLL) と報告し、要求されたすべての .traineddata ファイルが存在することを事前に確認し、キャンセルとタイムアウトを Tesseract 自身のプログレスモニターへ写します。ページごとにプロセス起動 1 回と BMP 往復 1 回が節約できます。実行ファイル方式は認識器のクラッシュとメモリー増加をあなたのアドレス空間の外に保ちます。ユーザー自身のスキャンを扱うデスクトップツールには DLL で構いません。見知らぬ人からドキュメントを取り込むサービスには、コマンドラインエンジンのほうが安全な選択です。どちらでも、認識は Windows 上で、1 ページずつ、レンダリングされたビットマップの上で走るため、難しいスキャンはエンジンへ届く前に傾き補正とクリーンアップを済ませてください
OCR アダプター、テキストレイヤーライター、それらに供給するレンダラー、出力を検査する抽出は、Delphi と C++Builder 向けの 1 つのネイティブ VCL コンポーネントの中に住んでいます。キャプチャーやアーカイブアプリケーションに検索可能 PDF 出力が要るなら、HotPDF Delphi PDF コンポーネントが、自分でインストールする OCR エンジン以外のすべてをカバーします