標準のMacintoshグリフ順を保つTrueTypeフォントでは、「Total」という単語が、PDFのコンテンツストリームに <0037005200570044004F> Tj として眠っていることがあります。この5つの2バイト値は、埋め込みフォント内部のグリフ番号であり、文字列自身は、これらが T、o、t、a、l を描くことを示していません。このバイト列をUTF-16として読めば 7RWDO という文字列になり、一方ページは画面上で Total を表示します。グリフを描くだけならコードからグリフへのマッピングで足り、テキストを取り戻すにはコードからUnicodeへのマッピングが要ります。ファイルがそのマッピングを最初から持っていないことは、いくらでもあり得るのです
なぜ抽出されたテキストは文字化けするのか
コンテンツストリームが記録するのは文字コードであり、その意味は完全にフォントの中に住んでいます。Tj と TJ オペレーター(ISO 32000-1 §9.4.3)が運ぶバイト文字列は、直前の Tf が選んだフォントを通して解釈されます。バイト 0x41 は、WinAnsiなら文字A、サブセットフォントでは任意のグリフ、複合CJKフォントでは2バイトCIDの半分になり得ます。ISO 32000-1 §9.10 はテキスト抽出をまさにこのデコード問題として扱い、フォント辞書が提供するものから各コードをUnicodeへ写し返します。そして、準拠ファイルにそれを遂行するのに十分な情報を提供する義務はないと、率直に述べています
「このPDFからコピー&ペーストすると文字化けする」という定番の報告は、みなこの規定の向こう側にあります。/ToUnicode テーブルなしのサブセットフォントを埋め込んだプロデューサーは、正しくレンダリングされる有効なファイルを書き出しています。グリフはすべて揃っています。欠けているのは逆マップであり、抽出器は二次的な証拠からこれを再構築しなければなりません。フォントが宣言するエンコーディング、グリフ名、Adobeが公開している文字コレクション、埋め込みフォントプログラム内部のcmapテーブル。このうちいくつをAPIが試み、全部が失敗したときに何を手渡すのか。それが実務で抽出ライブラリを分けるものです
ExtractLoadedPageTextによる読み取り順のテキスト抽出
HotPDF Delphi Componentは、ロード済みページの読み取り順テキストを function ExtractLoadedPageText(PageIndex: Integer; out AText: UnicodeString): boolean で返します。ページインデックスは0始まり、結果はネイティブなDelphiの UnicodeString です。ページに読めるコンテンツストリームがないとき、この関数は例外を上げる代わりに False を返します。ロードしたどんなPDFでも動きます。顧客がメールで送ってきた請求書、スキャン業者が納品した報告書、もう誰も名前を思い出せないソフトウェアが生成した契約書
var
  Pdf: THotPDF;
  PageCount, I: Integer;
  PageText, AllText: UnicodeString;
begin
  Pdf := THotPDF.Create(nil);
  try
    PageCount := Pdf.LoadFromFile('invoice.pdf');  // ページ数を返す
    AllText := '';
    for I := 0 to PageCount - 1 do
      if Pdf.ExtractLoadedPageText(I, PageText) then
        AllText := AllText + PageText + #13#10;
  finally
    Pdf.Free;
  end;
end;文書全体を1つの文字列にするなら、ExtractLoadedPagesText(PageRange, PageSeparator) が使えます。1始まりの範囲、たとえば '1,3-5,7-'(空文字列は全ページ)を受け取り、ページの間に PageSeparator、既定ではフォームフィード #12 を挟みます。大きな文書は ExtractLoadedPagesTextToStream を通す方が得です。こちらはUTF-8でページごとに TStream へ書き出し、処理したページ数を返します
テキストはページが見せているものを保持します。ボックスの中心が可視領域(メディアボックス内のクロップボックス)の外へ落ちるグリフは除外されるため、断ち落とし後のページの面付けマークがインデックスへ漏れ出すことはありません。ページが描画するForm XObjectの中のテキストも、各フォームの /BBox でクリップされた上で含まれます。同じ位置に2回描かれた文字、いわゆる擬似ボールドの古典的トリックは1回だけ読まれます。このケースの検出方法はテキスト抽出における擬似ボールドと重複グリフが詳しく歩いています
改行は単純な幾何ルールに従います。グリフの原点が、書字方向を横切ってテキスト高さの半分を超えて動くと、新しい行が始まります。テキスト高さは、このグリフと直前のグリフのアセントからディセントまでの高さをページ単位で比べ、大きい方を使います。Tf のサイズオペランドではなくグリフボックスを測る点が肝心です。テキストマトリクスで文字サイズを操り、Tf には1を渡すプロデューサーはいくらでもいます。そのオペランドを基準にした閾値は、持ち上がった上付き文字のたびに壊れ、回転テキストの各文字を1行ずつにバラします。単語スペースも同じ仕組みです。プロデューサーがスペースを示す代わりに TJ の調整値や Td でテキスト位置を動かして単語を分けている場所では、直前のグリフ自身の幅の後ろの隙間がグリフ高さの0.15を超えた時点でスペースが1つ足されます。ただし中国語、日本語、韓国語の2文字の間に足されることはありません。デコーダーが解決できないコードはスペースになるため、個々のグリフが生き残れなくても単語の境界は生き残ります。横書きテキストはコンテンツストリーム順で出ます。縦書きCJKの連なりは、右から左へ、上から下へ読む列に再編成されます。こうした閾値はページテキストの単語スペースと改行が解説しています
グリッド、段組み、構造順のどれを選ぶか
位置が意味を持つもの(表、フォーム、コードリスト、diffを取るもの、grepするもの、列でパースするものすべて)には、ExtractLoadedPageTextLayout の方が適した呼び出しです。グリフをベースラインへクラスタリングし、各ベースラインをXでソートし、ページのグリフ送り幅の中央値とフォントサイズから寸法を取った等幅文字グリッド上で、水平・垂直の空白を再現します。ベースライン上の広い隙間はスペースの連なりに、ベースライン間の大きな隙間は空行になります
uses System.IOUtils;
...
var
  Grid: UnicodeString;
begin
  if Pdf.ExtractLoadedPageTextLayout(0, Grid) then
    TFile.WriteAllText('page1.txt', Grid, TEncoding.UTF8);
  // 列、インデント、表の整列は、文字グリッド上の
  // スペースと空行として保持されます
end;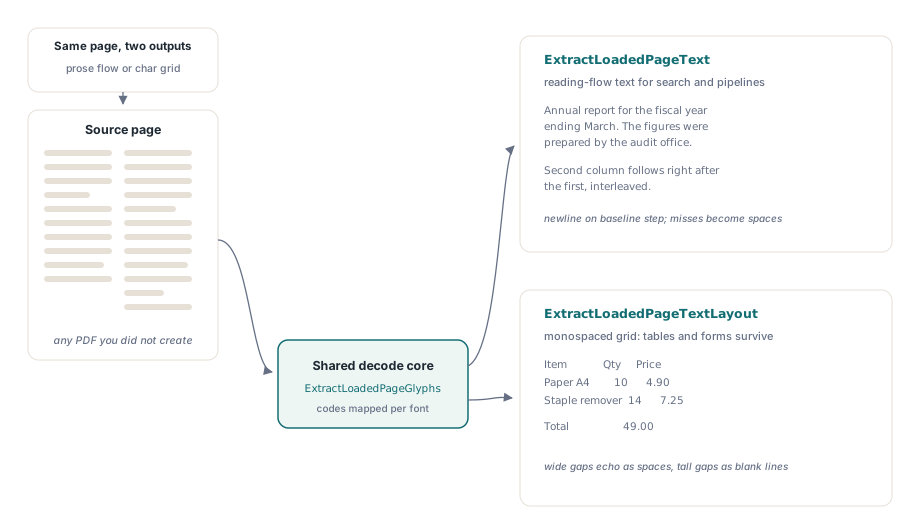
両方の呼び出しは同じ機構でデコードするため、どちらを選んでも精度の損失はありません。グリッドがやってくれないのは散文のリフローです。2段組みの記事は両段が横に並んだまま出ます。忠実なのでdiffには正しく、要約器には不正です。この隙間を埋めるのが別の2つの呼び出しです。ExtractLoadedPageTextColumns(PageIndex, AText, ColumnGapMultiplier) は、隣接グリフの隙間が中央値送り幅の倍数(既定3.0)を超えるごとに行を分割し、断片をタブで区切ります。ExtractLoadedPageStructureText(PageIndex, AText, UntaggedGlyphCount) はタグ付きPDF(ISO 32000-1 §14.8.4)の構造ツリーを歩き、マーク済みコンテンツの連なりを著者順で返します。ページに使える構造ツリーがなければ False を返し、UntaggedGlyphCount は配置できなかったグリフの数を教えてくれます
人や言語モデルが読むテキストには、まず構造順を試し、だめなら ExtractLoadedPageText へフォールバックしてください。構造ツリーは著者が意図して宣言した唯一の順序であり、幾何的な手法はどれも比較すれば推測にすぎません。グリッドは、列がデータである仕事のために取っておいてください。マーク済みコンテンツがツリーへどう対応付けられるかの詳細は、構造順テキスト抽出にあります
HotPDFは文字コードをどうUnicodeへデコードするか
HotPDF Delphi Componentは各文字コードを、優先順に並んだフォールバックチェーンで解決します。答えられなかった戦略は、コードを次の戦略へ手渡します。最初はフォントの /ToUnicode CMap(ISO 32000-1 §9.10.3)です。プロデューサーが抽出のために特別に書き込んだ唯一のマッピングだからです。次は /Encoding の /Differences 配列のグリフ名で、Adobe Glyph Listを通して読みます。その次は /Encoding CMap自身で、ストリームとして埋め込まれているか名前付きです。名前が Uni…-UTF16 なら、コードはすでにUTF-16だという意味です。複合フォントはAdobeの文字コレクション(Adobe-GB1、Adobe-CNS1、Adobe-Japan1、Adobe-Korea1、Adobe-KR)をCIDからUnicodeへ進み、続いて /CIDToGIDMap を通って埋め込みフォントプログラムのcmapテーブルへ入り、グリフからUnicodeへ逆に読みます。単純フォントはWinAnsi、MacRoman、Standard、MacExpertのテーブルへフォールバックし、最後は同じ埋め込みcmapへ落ちます。チェーンを使い果たしたコードは0に解決されます
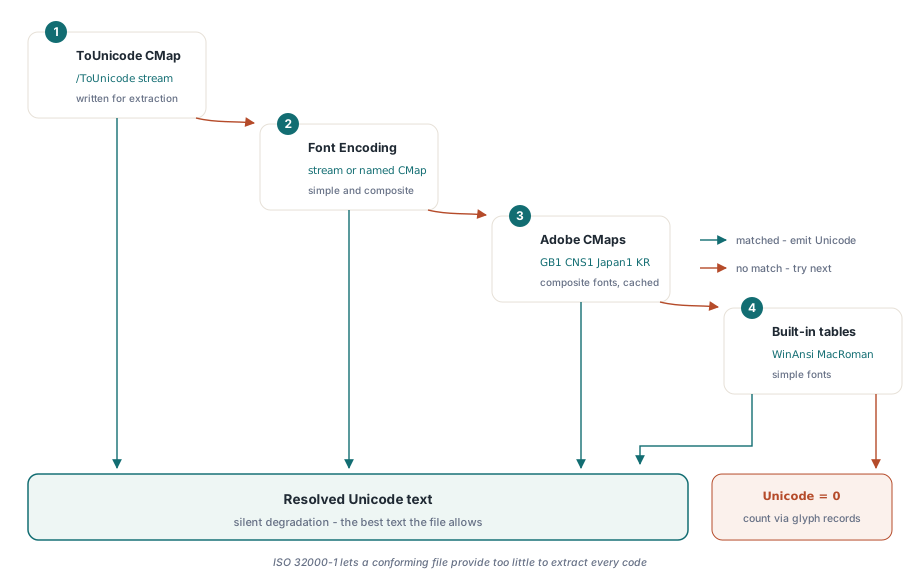
/ToUnicode なしで出回る多くのサブセットフォントを救うのが、この埋め込みcmapのステップです。フォントプログラムはたいてい自分のUnicode cmapをまだ持っており、それを逆にたどればテキストの大部分が復元できます。ただし復元である以上、完璧ではありません。1つのグリフを共有する2つのUnicode文字は、どちらもcmapが列挙している方の文字で返ってきます。復元テキストは検索とインデックスには十分と扱い、法的な記録として使う前に確認してください
Adobeの文字コレクションデータはディスク上に住んでいます。HotPDFはCMapと cid2code.txt ファイルを resources\CMap フォルダの下に同梱し、各ファイルはプロセスごとに高々1回パースして結果をキャッシュします。Adobe-GB1マップだけでおよそ2 MBのテキストがあり、ページごとにパースしたい代物ではありません。定義済みCMapは内蔵テーブルとしても存在するため、UniGB-UTF16-H のような名前付きCMapでエンコードされたフォントは、フォルダなしでもデコードされます。Identity-H のCJKフォント向けCID-to-Unicodeテーブルは、フォルダを必要とします。CMapResourcePath プロパティは、コレクションのサブフォルダを収めたフォルダを指します。空のままなら、HotPDFは実行ファイルの隣にある resources\CMap と、その1つ上、2つ上を探します
Pdf := THotPDF.Create(nil);
try
  // Adobe-GB1-6、Adobe-CNS1-7、Adobe-Japan1-7 ... を収めたフォルダ
  Pdf.CMapResourcePath := 'C:\MyService\resources\CMap';
  Pdf.LoadFromFile(FileName);
  ...
finally
  Pdf.Free;
end;
サービス、ISAPIモジュール、プラグインDLLでは、パスを明示的に設定してください。こうしたホストでは ParamStr(0) が指すのはホストプロセスであり、デプロイ先のフォルダであることはまれです。そしてフォルダが見つからなくても例外は上がりません。CJKページは、コレクションテーブルが埋めるはずだった場所に隙間を残して返ってくるだけです。コードとグリフの分断は書き込み時にも現れます。それがHotPDFでの複雑スクリプトのテキストshapingの主題です
CMap構文の2つの罠
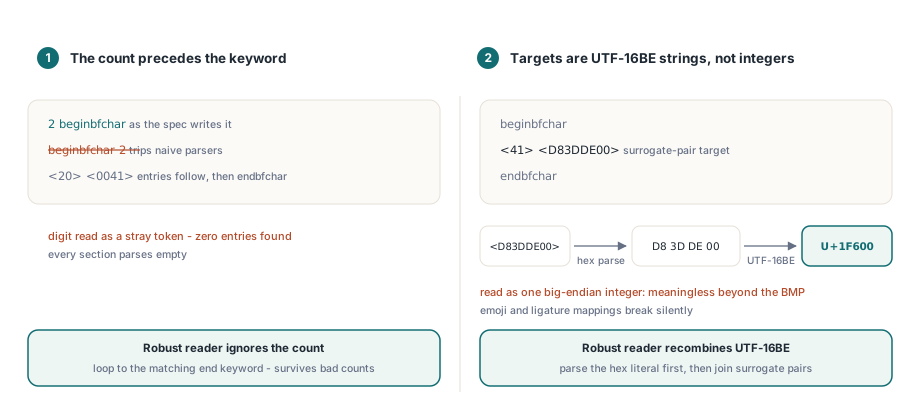
CMapファイルは一見簡単にパースできそうに見えて、2つの細部が最初の挑戦のほとんどを躓かせます。レコード数はセクションキーワードの前に来ます。セクションは 2 beginbfchar と読め、beginbfchar 2 では決してありません。キーワードの後にカウントを期待するパーサーは、その数値を迷子のトークンとして飲み込み、すべてのセクションでエントリー数ゼロに行き着きます。HotPDFのリーダーはカウントを完全に無視し、対応する endbfchar か endbfrange までループします。宣言されたカウントが間違っている実世界のファイルにも、これで対処できます
2つ目の罠は、bfchar と bfrange の変換先がUTF-16BE文字列だという点です。変換先の <D83DDE00> はU+1F600を意味します。1つのコードポイントへ再結合すべきサロゲートペアであり、この4バイトをビッグエンディアンの整数として読むと、基本多言語面の外のすべての文字、エモジも含めて、無意味な値になります。HotPDFは16進リテラルをまず生バイトへパースし、それからUTF-16BEのコードユニットを再結合します。合字マッピングが生む複数文字の変換先、たとえば1つの fi グリフが2文字へ写るようなケースも、これで処理されます
ExtractLoadedPageGlyphsで未解決グリフを数える
ExtractLoadedPageGlyphs(PageIndex, AGlyphs) は、テキスト呼び出しの下にあるグリフレコードを THPDFGlyphArray として露出します。各 THPDFGlyphRecord が運ぶのは、生の Code、その CodeByteWidth(1、2、4のいずれか。CMapの codespacerange が決める)、解決済みの Unicode コードポイントと合字用の UnicodeSequence、有効な FontKey と FontSize、ユーザー空間の原点 X と Y、Advance、4隅のグリフクアッド、そして GlyphEndX / GlyphEndY。最後の2つはグリフ自身の幅の終端で、単語スペースのルールはここから測ります。位置指定のハイライトや自作のレイアウトアルゴリズムには、これで十分です
var
  Glyphs: THPDFGlyphArray;
  I, Unresolved: Integer;
begin
  if Pdf.ExtractLoadedPageGlyphs(0, Glyphs) then
  begin
    Unresolved := 0;
    for I := 0 to High(Glyphs) do
      if Glyphs[I].Unicode = 0 then
        Inc(Unresolved);
    if Unresolved > 0 then
      ShowMessageFmt('%d of %d glyphs have no Unicode mapping',
        [Unresolved, Length(Glyphs)]);
  end;
end;
Unicode = 0 のレコードを数えることが、テキストを下流へ渡す前に文書を判断する正直な方法です。カウントはテキスト呼び出しが見る数と少し違って構いません。この呼び出しは、ページ自身のコンテンツストリームにあるすべてのグリフを返します。クロップボックスの外のものも、擬似ボールドのために描かれた重複も含み、Form XObjectの中へは降りません。各レコードはさらに TokenIndex、ItemIndex、ByteOffset を保存し、文字をソースのオペランドへ結び付けます。既存PDF内の検索と置換は、この3つのフィールドの上に立っています
テキストを提供しようのないファイルもあります。スキャンされたページは、テキストオペレーターなしの1枚の巨大な画像です。抽出は正しく空文字列を返し、進むべき道はOCRです。まずはロード済みPDFからページ画像を取り出すところから始めます。暗号化された文書は、LoadFromFile(FileName, Password) で開いてしまえば普通に抽出できます。インタープリターが読む前にストリームが復号されるからです。フォントとコンテンツのストリームは、ロード済み文書の他の部分と同じフィルターチェーンでデコードされ、デコードできない /ToUnicode ストリームは次の戦略へ落ち、ページの残りはそのまま抽出されます。同じオブジェクトリーダーがロード済み文書のメタデータ編集を支えているため、1回の取り込みでテキストを読み、メタデータを直せます
読み取り順、グリッド、段組み、構造順の各抽出と、グリフレベルのアクセスは、すべてHotPDF Delphi Componentに、外部DLLもOSのテキストサービスも不要な素のObject Pascalとして同梱されています。変わったファイルがキューに着地しても、デコーダーへステップインし、どの戦略がどのコードに応えたのかをその目で確かめられます