ディスクに 1 枚の PDF があり、顧客が請求書の束からスキャンしたもので、仕事はページ画像をビットマップとして取り出し OCR に回すことです。ファイルをロードし、image XObject を見つけ、そこで誰も教えてくれない部分に気づきます。ストリームの中のバイトは、ピクセルではないのです。JPEG の codestream か、ウェーブレット圧縮された JPEG 2000 の blob か、Group 4 fax のランレングスか、Flate フィルターの向こうにパレットがいるインデックスラスターか。image オブジェクトは width と height は知っていますが、実際のサンプルは、作成者が選んだフィルターの内側に封印されています。使える TBitmap を得るには、その封印を解くしかなく、PDF はバイトの封印を大まかに 8 通りの方法で用意しています
これこそ、Delphi と C++Builder 向けのネイティブ VCL PDF コンポーネントである HotPDF の ExtractLoadedImage が埋める隙間です。ロードした文書の image XObject を列挙し、それぞれが何であるかを報告し、デコードできるものを 24-bit のビットマップへ戻します。興味の対象は API の表面(3 メソッドだけです)ではなく、なぜ独立したデコード経路がそもそも存在しなければならないのか、そしてどのフィルターをピクセルへ戻すのかにあります
ロード済み画像がデコード済みでいない理由
HotPDF のローダーは、パススルーの忠実度を軸に作られています。LoadFromFile を呼ぶと、画像ストリームはソースファイルに現れているとおり、元のフィルター、元の圧縮バイト、元の辞書のまま保持されます。これは意図的な設計です。文書をロードする目的はたいてい、ページのコピー、ファイルのマージ、スタンプの押印、権限の付け替え、そして書き戻しであり、そのすべてにとって、最も安くて安全なのは各画像ストリームに触れないことです。ロード時にすべての画像をラスターへデコードすると、ほとんどの呼び出し元が一度も必要としない仕事にメモリと CPU を燃やし、保存時の再エンコードは、そのままコピーされるべき画像を劣化させます
その帰結として、ロードされたオブジェクトグラフはピクセルを持ちません。/Filter が /DCTDecode の image XObject は JPEG バイトを保持しています。HotPDF はそこへ JPEG デコーダーを走らせたことがありません。コピーと書き換えの経路には必要がなかったからです。ですから実際にピクセルが欲しいときは、抽出 API がデコードを、その画像がたまたま使っているフィルター向けに、ゼロから行わなければなりません。エンコード側のコーデックがローダーと独立しているのも同じ理由です。Delphi で PDF へ JPEG 2000 画像を追加する記事が、JPX エンジンが作成側へ差し込まれる様子を述べており、抽出 API は同じエンジンを読み取り経路へ配線します
3 メソッドの API
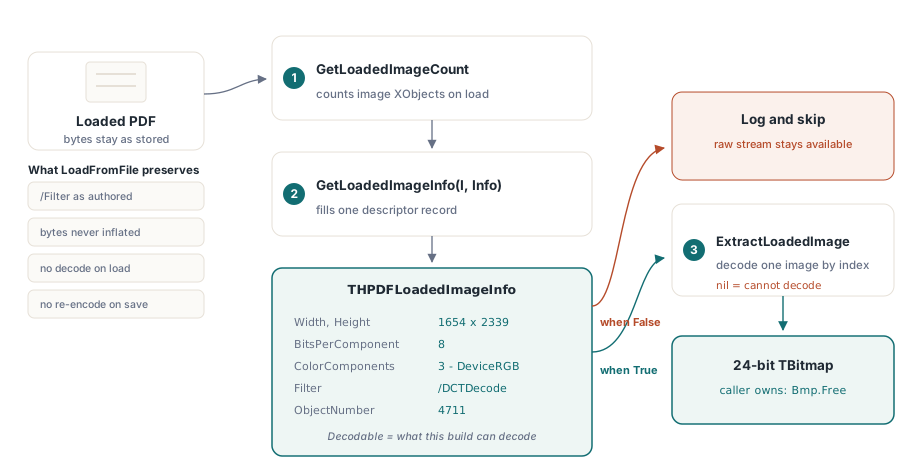
表面は小さいです。GetLoadedImageCount は、ロードされた文書が含む image XObject の数を返します。GetLoadedImageInfo は、インデックスで指定した 1 つのディスクリプターレコードを埋めます。ExtractLoadedImage はデコードされたビットマップを返し、その画像をデコードできないときは nil を返します。列挙はインデックスベースで、与えられたロードに対して安定しています。内部的には間接オブジェクトテーブルを歩き、/Subtype が /Image に解決されるすべてのストリームを収集するため、GetLoadedImageInfo に渡すインデックスは、ExtractLoadedImage に渡すインデックスと同じです
var
  Pdf: THotPDF;
  Info: THPDFLoadedImageInfo;
  Bmp: TBitmap;
  I, Count: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('scanned-invoices.pdf', '') <= 0 then
      Exit;
    Count := Pdf.GetLoadedImageCount;
    for I := 0 to Count - 1 do
    begin
      if not Pdf.GetLoadedImageInfo(I, Info) then
        Continue;
      if not Info.Decodable then
        Continue;                       // 未対応のフィルターまたはカラースペース
      Bmp := Pdf.ExtractLoadedImage(I);
      if Bmp <> nil then
      try
        Bmp.SaveToFile(Format('img_%d.bmp', [I]));
      finally
        Bmp.Free;                       // bitmap の所有者は呼び出し側
      end;
    end;
  finally
    Pdf.Free;
  end;
end;
ここで効いてくる契約の細部が 2 つあります。第 1 に、返された TBitmap を解放するのは呼び出し側の仕事であり、文書はキャッシュも所有もしません。第 2 に、呼ぶ前に Decodable を確認し、呼んだ後は結果を nil と比較します。このメソッドは未対応のフィルターで例外を上げず、nil を返します。バッチループの中の静かな nil は、千ページのジョブから 1 ページを誰も気づかないうちに呑み込む、まさにその種のものです
デコード前にディスクリプターを読む
THPDFLoadedImageInfo は、フルデコードに踏み切る前に、その画像が何であるかを教えてくれます。フィールドは image 辞書から直接来ます。サンプル数での Width と Height、BitsPerComponent、デコード後の解釈を記述する ColorComponents と ColorSpace(グレーが 1、RGB が 3、CMYK が 4)、名前付き圧縮としての Filter、ステンシルマスク用の IsImageMask、元の間接オブジェクトの ObjectNumber、そして Decodable です
最後のフラグが正直なやつです。Decodable が True になるのは、実行中のビルドが、このフィルターとカラースペースの組み合わせを実際にビットマップへ変換できるときだけです。願望ではなく、実際のサポートマトリクスを符号化しています。現在のビルドが理解しない Filter の画像は Decodable = False を報告し、それを分岐に使えば、ログに記録する、スキップする、生ストリームを自分で取り出す、を選べます。ヒントとしてではなく、前提条件として扱ってください
// デコードを確定させる前に、すべての画像をトリアージする
var
  Pdf: THotPDF;
  Info: THPDFLoadedImageInfo;
  I: Integer;
begin
  // ... Pdf はロード済み ...
  for I := 0 to Pdf.GetLoadedImageCount - 1 do
  begin
    if not Pdf.GetLoadedImageInfo(I, Info) then
      Continue;
    if Info.Decodable then
      // ExtractLoadedImage(I) は TBitmap を返す
    else
      // 未対応のフィルター/カラースペース: オブジェクトを記録してスキップ
      Writeln(Format('Image %d obj %d: %dx%d %s/%s not decodable',
        [I, Info.ObjectNumber, Info.Width, Info.Height,
         String(Info.Filter), String(Info.ColorSpace)]));
  end;
end;
ディスクリプターレコードを手で組み立てる人が踏む実装の落とし穴が 1 つあります。THPDFLoadedImageInfo は 2 つの AnsiString フィールド、Filter と ColorSpace を持ちます。これらは参照カウントされるマネージ型のため、FillChar(Info, SizeOf(Info), 0) でレコードをゼロ化する反射神経は、ここでは間違いです。デクリメントせずに文字列参照を上書きするため、リークするか壊れます。HotPDF はまさにこの理由で、レコードをフィールドごとに初期化します。このパターンを自分のコードへ写すなら、同じことをしてください
1 つのディスパッチャー、8 つのフィルター経路
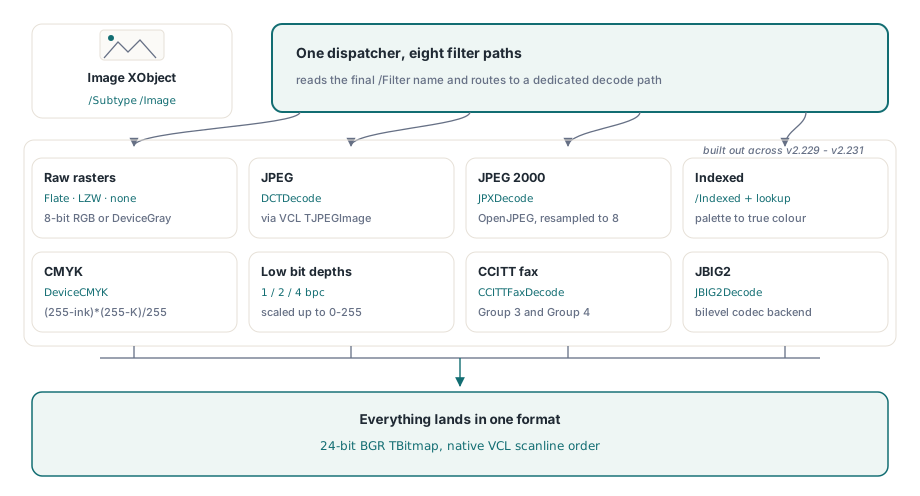
抽出にディスパッチャーが必要なのは、PDF には画像フォーマットが存在しないからです。あるのはフィルターであり、ISO 32000-1 の §8.9.5 は、image XObject が /Filter にそのどれでも名前できることを許し、サンプルの解釈は /ColorSpace、/BitsPerComponent、任意の /Decode 配列が別々に管理します。ExtractLoadedImage はフィルター名を読み、ケースごとに専用のデコーダーへ振り分けます。サポートされる集合は、8 つの異なる経路をカバーします
- 生ラスター(FlateDecode、LZWDecode、フィルターなし)。8-bit の DeviceRGB または DeviceGray です。バイトは詰め込まれたラスターへ展開され、変換はチャネルスワップだけ(下で述べます)
- DCTDecode(JPEG)。codestream は VCL の
TJPEGImageへ渡され、これが geometry と色を解決し、結果が 24-bit ビットマップへ代入されます - JPXDecode(JPEG 2000)。OpenJPEG バックエンド、つまり JPEG 2000 の記事で述べたのと同じエンジンを通ってデコードされ、8 ビットを超えるビット深度のコンポーネントは 8 ビットへ再サンプリングされます
- インデックスカラー。パレットは
[/Indexed base hival lookup]配列から読まれ、各サンプルはルックアップテーブルを通って true color へ展開されます - DeviceCMYK。4 チャネルのサンプルは、標準的な white 上の ink の式で RGB へ変換されます
- 8 ビット未満の DeviceGray と Indexed。コンポーネントあたり 1、2、4 ビットのものは、サンプルごとに展開され、0–255 の範囲へスケールされます
- CCITTFaxDecode。Group 3 と Group 4 の fax フィルターで、専用の T.4/T.6 バックエンドがデコードします
- JBIG2Decode。高圧縮率の 2 値フィルターで、登録された JBIG2 バックエンドを通ってデコードされます。ネイティブ JBIG2 圧縮の記事がエンコード側からこれを扱っています
すべては同じ場所に着地します。24-bit の BGR ビットマップです。VCL の TBitmap がネイティブに格納する形式であり、下流の消費者すべてが期待しているものです
黙ってピクセルを変える変換たち
このうち 2 つの経路には、微妙に間違えやすく、自分でデコーダーに触れないとしても理解する価値のある変換が含まれます。第 1 は色順のスワップです。PDF の DeviceRGB ラスターは、サンプルを赤・緑・青の順で、トップ行から格納します。VCL の 24-bit スキャンラインは、青・緑・赤の順です。したがって、素の RGB 画像のデコードは memcpy ではありません。各ピクセルの 1 バイト目と 3 バイト目が、スキャンラインへ入る途中で交換されます。これを逆にすると、赤と青が入れ替わります。グレースケールのテスト画像では正常に見え、カラー画像では破滅的に間違って見えるやつです。なお行の順序は素直に対応します。PDF の top-down ラスターは、VCL の ScanLine[0] を見た目の最上行として整列するため、垂直フリップは要りません
第 2 は CMYK です。PDF の DeviceCMYK 画像は 4 つの ink を運び、RGB への変換はルックアップではなくチャネルごとの計算です。各出力チャネルは (255 - ink) * (255 - K) / 255 になります。これはデバイス近似であり、ICC プロファイルを通るカラーマネージド変換ではありません。表示と再ラスタライズには十分正確ですが、印刷正確な色が要るなら正しい道ではありません。ワークフローが忠実度を要求するなら、抽出したビットマップをプレビューとして扱い、元の CMYK ストリームをカラーマネージドパイプラインのために取っておいてください
Indexed 経路には、それ専用のパースの落とし穴があります。/Indexed カラースペースのパレットは、リテラル文字列としても 16 進文字列としても格納でき、HotPDF は 16 進文字列の値を、デコード済みバイトではなく hex のテキストとして保持します。したがってパレットが 16 進文字列のときは、ルックアップテーブルを先に hex からバイトへのデコードへ通さなければなりません。リテラル文字列なら、すでに生バイトです。この分岐を逃すと、4 色のインデックス画像がガラクタになります。すべてのパレットエントリーが誤ったバイト境界から読まれているからです
フィルターチェーン: 最後のフィルターが画像そのもの
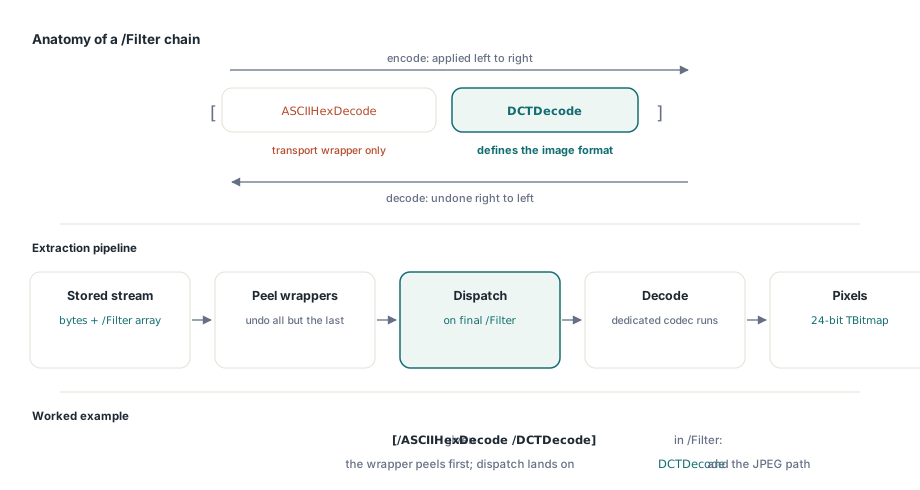
単一の /Filter 名は簡単なケースです。PDF はフィルターの連鎖も許します。ストリームが複数のフィルターを順番に通されており、[/ASCII85Decode /FlateDecode] や [/ASCIIHexDecode /DCTDecode] のような /Filter 配列に順に並んでいる形です(ISO 32000-1 の §7.4)。意味論は正確です。エンコードではフィルターは左から右へ適用されるため、デコードでは右から左へ解くことになり、配列の最後のフィルターこそが、画像フォーマットを実際に定義するものです。先頭のフィルターは、その周りに巻かれた輸送エンコーディングに過ぎません
抽出器は、はがすことでこれを処理します。画像デコーダーが走る前に、チェーンの最後以外のすべてのフィルターが、最終フィルターが期待する入力を生むために適用され、その後で初めて、最後のフィルター上でディスパッチが起こります。したがって [/ASCII85Decode /DCTDecode] は、まずストリームの ASCII85 を解き、それから結果を JPEG 経路へ振ります。生ラスターの周りに巻かれた [/FlateDecode] は、展開してからラスター経路を走らせます。これが 8 つのデコーダーをシンプルに保つ仕組みです。どれも ASCII85 や hex の輸送ラッパーを知る必要がありません。デコーダーがバイトを見る時点で、ラッパーはすでにないからです。これはまた、最終フィルターが未対応のチェーンが、途中半端ではなくディスパッチの段階できれいに失敗することも意味します
何が返ってくるか、生ストリームをいつ使うか
手に入るのは、そのストリーム自体がデコードした基底画像であり、soft mask を合成した結果ではありません。8 ビットより深い JPEG 2000 のコンポーネントは 8 へ再サンプリングされます。表示と OCR にはこちらが向きます。image mask、つまり自分の色を持たない 1 ビットのステンシルは IsImageMask で印が付き、写真としてではなくステンシルとして扱えます。最終フィルターまたはカラースペースが上の集合の外にある画像は nil を返します。だからこそ、Decodable のガードはすべてのループに属します
アルファ、フルビット深度、カラーマネージド出力が必要なとき、生ストリームはロードされたオブジェクトグラフの中に、フィルターごと丸ごとまだあります。バイト単位で取り出し、自分の専用コーデックへ渡せます。これが、パススルー設計が意図的に残しておくフォールバックです。元のバイトは決して捨てられないため、最悪のケースは「データが消えた」ではなく「自分でデコードする」です。とはいえ実際の仕事のほとんどでは、サポートされる 8 つのフィルターが、スキャナー、オフィススイート、レポートエンジンが実際に吐くものをカバーしており、Decodable のガード付きの GetLoadedImageCount ループ数行で、ロードした PDF をビットマップのフォルダーへ戻せます
ロード済み画像の抽出 API と、ここで述べたデコードフィルター一式は、Delphi と C++Builder 向けの HotPDF Delphi Component に搭載されています