スキャンされた医療用スライド、航空測量のタイル、フルダイナミックレンジでアーカイブされたフィルムフレーム。これらはJPEG 2000として届く画像であり、その形式であるのには理由があります。このフォーマットはチャンネルあたり12ビットまたは16ビットを保持し、JPEGが使用するブロックDCTの代わりにウェーブレット変換で圧縮し、1つのコードストリームから同じ画像を可逆(ロスレス)または非可逆(ロッシー)のいずれかでエンコードできます。これらのソースから構築されたドキュメントをPDFにする場合、画像はPDF仕様がまさにこのコーデックのために用意しているフィルタを通る必要があります
HotPDF v2.228.0では、この処理ルートのための機能するJPEG 2000デコードエンジンが復活しました。以前のビルドでは、nilを返すスタブ関数を備えたユニットが提供されていたため、APIは存在していましたが何もデコードしませんでした。現在のエンジンはOpenJPEG 2.5.4を静的にバインドし、JP2またはJ2KソースをHotPDFがページ上に配置できるピクセルに変換します
PDFのJPXDecodeフィルタ
ISO 32000-1では、JPXDecodeフィルタを§7.4.9で定義しています。PDF画像XObjectは、ストリーム辞書の/Filterエントリでその圧縮形式を指定しますが、JPXDecodeはストリームデータが/DCTDecodeが保持するベースラインJPEGではなく、JPEG 2000コードストリームであることを示す値です。このフィルタにより、PDFは高いビット深度を持つウェーブレット圧縮画像データを保持できるようになります。また、可逆モードと非可逆モードの両方のコーデックを許容しますが、これはモードがラッパーのプロパティではなくコードストリーム自体のプロパティであるためです
この最後の点は心に留めておく価値があります。JPEG 2000は可逆の特殊ケースを持つ単一のアルゴリズムであり、2つの独立したフォーマットではありません。可逆な5/3ウェーブレットは元のサンプルを正確に再構築し、非可逆な9/7ウェーブレットはその正確さと引き換えにファイルサイズを小さくします。デコーダは読み込み時に両方を同じように処理します。これが、JPXDecodeストリームが投げてくるものをすべて受け入れるために、HotPDFに単一のデコードルートしか必要としない理由です
デコーダがピクセルに対して行うこと
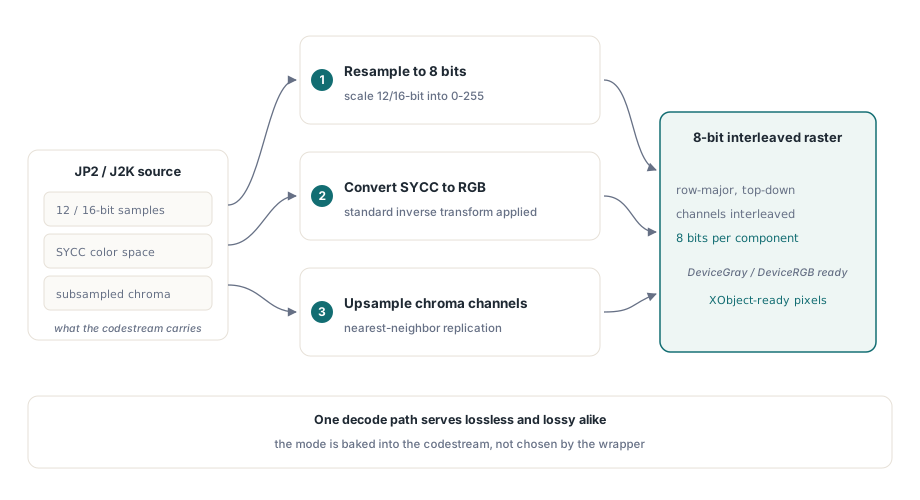
一般的なケースでは、PDF画像XObjectはDeviceGrayまたはDeviceRGBでコンポーネントあたり8ビットを想定しています。JPEG 2000は日常的にそれを超え、そのコンポーネントモデルはパックされたラスターよりも一般的であるため、デコーダはデータを通常の画像として使用できるようにする前に3つの作業を行う必要があります
第一に、高いビット深度のコンポーネントは8ビットにリサンプリングされます。12ビットまたは16ビットのサンプルは、0から255の範囲にスケールダウンされ、結果が通常の8ビットのラスターになるようにします。符号付きコンポーネントは、最初に符号なしの範囲にシフトされます。この細部は、それ自体が非可逆であるため重要です。16ビットのグレースケールスキャンは、8ビットのPDF画像になった瞬間にその深い階調を失います。これは、画面や印刷出力にとっては適切なトレードオフですが、再アーカイブには適していません
第二に、YCbCr(コーデックではSYCCと呼ばれます)カラースペースはRGBに変換されます。JPEG 2000は圧縮効率のために輝度と色差のスペースに色を保存することがよくあります。これはベースラインJPEGが使用するのと同じアイデアであり、デコーダはページが真のRGBを受け取るように標準の逆変換を適用します
第三に、サブサンプリングされたコンポーネントは最近傍法(ニアレストネイバー)の複製によってアップサンプリングされます。クロマ(色差)チャンネルは頻繁に半分の解像度で保存されるため、デコーダは各コンポーネントを独自の寸法と独自のサンプリング係数で読み取り、サンプルを複製してすべてのチャンネルを元の画像サイズに引き上げてからインターリーブします。最近傍法はこのステップのコストを低く抑えます。埋められるクロマは元々低周波数であったため、見た目への影響はわずかです
JP2ボックス対生のJ2Kコードストリーム
JPEG 2000ファイルには2つの形があり、HotPDFはファイルの拡張子からではなく最初の数バイトから読み取っている形を検出します。JP2ファイルはボックス構造のコンテナです。12バイトのシグネチャボックス00 00 00 0C 6A 50 20 20で始まり、カラースペース、解像度、メタデータを記述するボックスと並んでコードストリームをラップします。生のJ2Kコードストリームはコンテナを一切持たず、SOCマーカーFF 4F FF 51で始まります。デコーダはそれらの先頭バイトを読み取り、シグネチャを認識して、それぞれのケースに一致するOpenJPEGコーデックを選択します
両方の形が実際に出回っているため、両方が処理されます。サイドメタデータを必要とするキャプチャデバイスやアーカイブはJP2を出力し、可能な限り最小のペイロードを求めるツールは裸のコードストリームを出力します。フォーマットタイプは列挙型TJpeg2000FileTypeとしてモデル化されており、メンバーにはjtInvalid、jtJP2、jtJ2K、jtJPTが含まれます。JPTメンバーはJPIPストリーミングのバリアントを示します。バイトシグネチャの検出器は、デコード可能なJP2とJ2Kの2つの形を解決し、それ以外はjtInvalidとして報告するため、サポートされていない入力はゴミを生成するのではなくきれいに失敗します

uses
  HPDFJpeg2000;

var
  Decoder: THPDFJpeg2000Decoder;
  Pixels: TJpeg2000ByteArray;
begin
  Decoder := THPDFJpeg2000Decoder.Create;
  try
    if Decoder.LoadFromStream(Input) then          // JP2 or J2K, auto-detected
      if Decoder.GetImageData(Pixels) then
        // Pixelsは8-bit interleavedで、ColorComponents channel幅
        // row-majorで上から下:DeviceGray/DeviceRGB XObjectにそのまま使える
        ProcessRaster(Decoder.Width, Decoder.Height,
                      Decoder.ColorComponents, Pixels);
  finally
    Decoder.Free;
  end;
end;
エンコード側での可逆と非可逆
デコーダは、どちらのモードであるかを指示されることなく両方のモードを読み取ります。この選択がパラメータとなるのは、逆方向の処理を行ってJPEG 2000ファイルを生成する場合のみであり、HotPDFはラスターデータをJP2として読み書きするTBitmapの派生クラスであるTJpeg2000Bitmapクラスを通じてこれも行うことができます。2つのプロパティが出力を制御します。LosslessCompressionはブール値であり、trueの場合は可逆のウェーブレットを選択します。CompressionQualityはTJpeg2000QualityRangeであり、1から100までの整数で、1は小さくて粗く、100は大きくて忠実です。デフォルト値は名前付き定数に存在し、Jpeg2000DefaultLosslessCompressionはFalse、Jpeg2000DefaultLossyQualityは80です
この決定はコンテンツによる決定です。可逆(ロスレス)はマスターコピー、医療用や法務用のスキャン、後で再エンコードされる可能性があり、世代的な劣化を蓄積してはならないものに適しています。品質80での非可逆(ロッシー)は、画面や印刷向けの画像に適しており、ウェーブレットの緩やかな劣化により、読者が気づくようなアーティファクトを生じることなく、著しく小さなファイルになります。注意すべきCMYKに関する警告が1つあります。ビットマップは4チャンネルのデータをRGBAではなくCMYKとしてマークするSetCMYKを公開しており、これは色分解をそのまま維持する印刷パイプラインにとって重要です
uses
  HPDFJpeg2000;

var
  Bmp: TJpeg2000Bitmap;
begin
  Bmp := TJpeg2000Bitmap.Create;
  try
    Bmp.LoadFromStream(Source);              // 既存のJP2/J2Kをdecode
    Bmp.LosslessCompression := True;         // reversible 5/3 wavelet
    // または、より小さいlossy file用に
    // Bmp.LosslessCompression := False;
    // Bmp.CompressionQuality := 80;         // デフォルトと同じ
    Bmp.SaveToStream(Output);                // always writes a JP2 file
  finally
    Bmp.Free;
  end;
end;
読み込み時のデコードフィルタパイプラインが存在しない理由
1つのアーキテクチャ上の事実が、これらをどのように使用するかを形作っていますが、その逆を想定しがちです。HotPDFには一般的な読み込み時のデコード画像フィルタがありません。JPXDecode画像をすでに含んでいるPDFを開いた場合、エンジンはそのストリームをデコードしません。JPEG 2000のバイトをそのまま維持するため、ページのコピーやドキュメントの結合では画像がバイト単位でそのまま運ばれます。デコーダには単一のエントリポイントがあり、それは作成側にあります。つまりファイルベースのAddImageであり、ファイルの拡張子によって振り分けられ、.jp2、.j2k、.jpt、.jpcソースを処理します
この分離は制限ではなく、正しい設計です。読み込み時に埋め込まれたJPXストリームをデコードし、保存時にそれを再エンコードすることは、可逆なアーカイブ画像を非可逆なものに変換し、結合のたびにサイズを膨張させることになります。これはすべて、あるPDFから別のPDFへ画像を単に移動させようとしただけの場合に起こります。ストリームをそのまま通過させることはロスレスな操作であり、高速です。デコードは、それが本当に必要とされる唯一の瞬間まで延期されます。それは、ディスクからJPEG 2000ファイルをエンジンに渡し、新しいページに配置するためにその画像をラスタライズするよう要求した時です。その時点でファイルはピクセルになる必要があり、デコーダが実行されます

サポートの登録と画像の配置
JPEG 2000画像の登録は、デフォルトでオフになっているHPDF_REGISTER_JPEG2000_PICTUREコンパイルスイッチの背後にあるオプトインの機能です。その理由は警戒からではなく、実際の競合があるためです。jp2、j2k、およびjpcのファイル形式をグローバルにTPictureに登録すると、ReportBuilderのTppDBImageが依存するBLOB形式の検出に干渉する可能性があります。その統合機能が動作していないときにスイッチを定義すると、ファイル形式が登録されてTPictureがそれらを認識します。スイッチを未定義のままにしておいても、AddImageの拡張子による振り分けは依然としてJPEG 2000ファイルを直接デコードします。なぜなら、その処理ルートはTPictureを全く経由しないからです
それを理解した上で、JPEG 2000画像の配置は他のHotPDF画像と同じ3回の呼び出しのリズムで行われます。AddImageに.jp2のパスと、出力で画像をどのように保存すべきかという圧縮タイプを渡し、返された画像インデックスをShowImageを使用してページ上に配置します
var
  Pdf: THotPDF;
  ImgIndex: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.BeginDoc;
    Pdf.AddPage;
    // .jp2 sourceはOpenJPEG backendでdecodeされ、その後
    // ここで指定したcompressionで再embed
    ImgIndex := Pdf.AddImage('Scan_16bit.jp2', icJpeg);
    // x、y、width、heightはpoint単位、最後の0はrotation angle
    Pdf.CurrentPage.ShowImage(ImgIndex, 72, 72, 400, 300, 0);
    Pdf.EndDoc;
  finally
    Pdf.Free;
  end;
end;AddImageに渡す圧縮タイプは、読み込まれた方法ではなく、デコードされた画像がどのように再保存されるかを制御します。ビットマップにデコードされたJPEG 2000ファイルは、DCTDecodeのJPEG、Flateラスター、またはその他のサポートされているフィルタとして出力することができ、ドキュメントに合うものが選ばれます。JP2またはJ2Kからのデコードはどちらにしても最初に発生するため、同じ呼び出しでウェーブレット圧縮されたソースを受け入れ、パイプラインの他の部分が期待する任意の形式でそれを埋め込むことができます
生成された出力に画像とフォントがどのように配置されるかの全体像については、フォントと画像を含むレポート出力に関するメモを参照してください。アセンブルしているドキュメントが既存のPDFのコンテンツを再利用する場合、ここで説明したパススルーの動作は、オブジェクトストリームとインクリメンタルアップデートの結合や改訂のメカニズムと対になります。JPEG 2000デコードエンジンは、DelphiおよびC++Builder向けのHotPDF Delphi Componentの一部として、このブログの他の場所で取り上げている画像、フォント、ドキュメントのAPIとともに提供されています