En una fuente TrueType que conserva el orden de glifos Macintosh estándar, la palabra «Total» puede estar en un flujo de contenido PDF como <0037005200570044004F> Tj. Esos cinco valores de dos bytes son números de glifo dentro de la fuente incrustada, y nada en la cadena dice que dibujan T, o, t, a y l. Lee esos bytes como UTF-16 y obtienes la cadena 7RWDO, mientras la página muestra Total en pantalla, porque dibujar un glifo solo necesita el mapeo de código a glifo, y recuperar texto necesita un mapeo de código a Unicode que el archivo puede no haber llevado jamás
¿Por qué el texto extraído sale como caracteres ilegibles?
Un flujo de contenido registra códigos de caracteres, y su significado vive por completo en la fuente. Los operadores Tj y TJ (ISO 32000-1 §9.4.3) transportan cadenas de bytes que se interpretan a través de la fuente que el Tf precedente haya seleccionado: el byte 0x41 es la letra A bajo WinAnsi, un glifo arbitrario en una fuente subdividida o la mitad de un CID de dos bytes en una fuente CJK compuesta. La ISO 32000-1 §9.10 trata la extracción de texto como exactamente este problema de decodificación, mapeando cada código de vuelta a Unicode a partir de lo que ofrezca el diccionario de la fuente, y dice sin rodeos que un archivo conforme no está obligado a proporcionar suficiente información para conseguirlo
Esa cláusula está detrás de cada informe de «copiar y pegar de este PDF produce basura». Un productor que incrusta una fuente subset sin tabla /ToUnicode ha escrito un archivo válido que renderiza correctamente. Los glifos están todos allí. Lo que falta es el mapa inverso, que un extractor tiene que reconstruir a partir de evidencia secundaria: la codificación declarada de la fuente, los nombres de glifo, las colecciones de caracteres publicadas por Adobe, la tabla cmap dentro del programa de fuente incrustado. Cuántas de esas pistas intenta una API, y qué te entrega cuando todas fallan, es lo que separa a las bibliotecas de extracción en la práctica
Texto en orden de lectura con ExtractLoadedPageText
HotPDF Delphi Component devuelve el texto en orden de lectura de una página cargada a través de function ExtractLoadedPageText(PageIndex: Integer; out AText: UnicodeString): boolean. Los índices de página son base cero, el resultado es un UnicodeString nativo de Delphi, y la función devuelve False cuando la página no tiene un flujo de contenido legible en lugar de lanzar una excepción. Funciona sobre cualquier PDF que cargues: la factura que un cliente envió por correo, el informe que entregó una empresa de escaneo, el contrato producido por un software que ya nadie sabe nombrar
var
  Pdf: THotPDF;
  PageCount, I: Integer;
  PageText, AllText: UnicodeString;
begin
  Pdf := THotPDF.Create(nil);
  try
    PageCount := Pdf.LoadFromFile('invoice.pdf');  // devuelve el número de páginas
    AllText := '';
    for I := 0 to PageCount - 1 do
      if Pdf.ExtractLoadedPageText(I, PageText) then
        AllText := AllText + PageText + #13#10;
  finally
    Pdf.Free;
  end;
end;
Para el documento entero en una sola cadena, ExtractLoadedPagesText(PageRange, PageSeparator) toma un rango base uno como '1,3-5,7-' (una cadena vacía significa todas las páginas) y pone PageSeparator, un salto de formulario #12 por defecto, entre páginas. Los documentos grandes van mejor por ExtractLoadedPagesTextToStream, que escribe UTF-8 página a página a un TStream y devuelve cuántas páginas procesó
El texto contiene lo que la página muestra. Los glifos cuyo centro de caja cae fuera del área visible (el crop box dentro del media box) se dejan fuera, así que las marcas de imprenta de una página recortada no se cuelan en tu índice. El texto dentro de los Form XObjects que la página pinta se incluye, recortado al /BBox de cada formulario. Un carácter pintado dos veces en el mismo sitio, el truco antiguo para fingir una negrita, se lee una vez; fake bold y glifos duplicados en la extracción de texto recorre cómo se detecta ese caso
Los saltos de línea siguen una regla geométrica simple. Una línea nueva empieza cuando el origen del glifo se mueve en la dirección de escritura más de la mitad de la altura del texto, tomando la mayor entre la altura de ascendente a descendente de este glifo y la del glifo anterior, en unidades de página. Medir la caja del glifo en lugar del operando de tamaño de Tf es la parte que importa: muchos productores dimensionan el texto a través de la matriz de texto y pasan 1 a Tf, y un umbral construido sobre ese operando se rompería en cada superíndice elevado y pondría cada carácter de texto rotado en su propia línea. Los espacios entre palabras funcionan igual. Donde un productor separa palabras moviendo la posición del texto con un ajuste TJ o un Td en lugar de mostrar un espacio, se añade un espacio una vez que el hueco tras el ancho propio del glifo anterior supera 0.15 de la altura del glifo, y nunca entre dos caracteres chinos, japoneses o coreanos. Los códigos que el decodificador no puede resolver se convierten en espacios, así que los límites de palabra sobreviven incluso cuando los glifos individuales no. El texto horizontal sale en orden de flujo de contenido; las secuencias CJK verticales se reagrupan en columnas leídas de derecha a izquierda, de arriba abajo. Espacios entre palabras y saltos de línea en el texto de página cubre esos umbrales
Rejilla, columnas u orden de estructura
Cuando la posición lleva significado (tablas, formularios, listados de código, cualquier cosa que vayas a diffar, grepear o analizar por columnas), ExtractLoadedPageTextLayout es la mejor llamada. Agrupa los glifos en líneas base, ordena cada línea base por X, y reproduce los espacios en blanco horizontales y verticales sobre una rejilla de caracteres monoespaciada dimensionada desde el avance medio de glifo y el tamaño de fuente de la página. Los huecos anchos en una línea base se vuelven corridas de espacios, los huecos grandes entre líneas base se vuelven líneas en blanco
uses System.IOUtils;
...
var
  Grid: UnicodeString;
begin
  if Pdf.ExtractLoadedPageTextLayout(0, Grid) then
    TFile.WriteAllText('page1.txt', Grid, TEncoding.UTF8);
  // Las columnas, la sangría y la alineación de tablas sobreviven como
  // espacios y líneas en blanco en una rejilla de caracteres
end;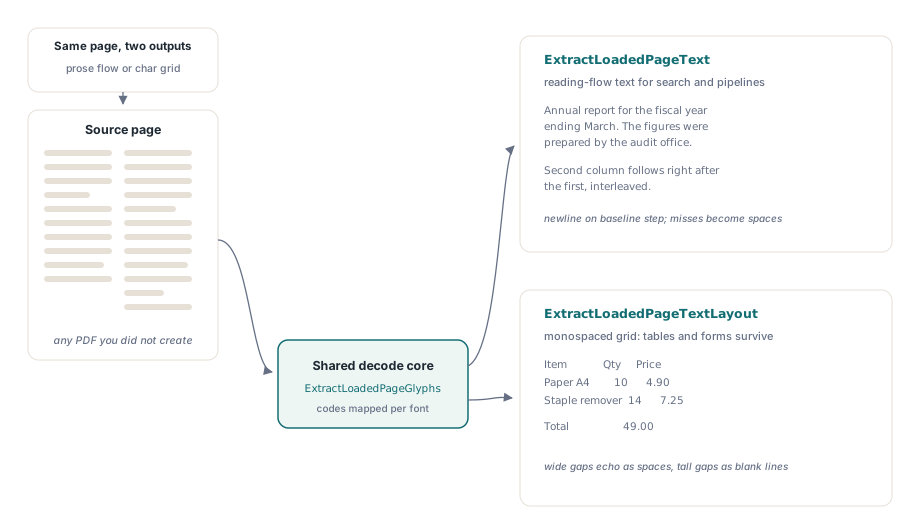
Ambas llamadas descodifican por la misma maquinaria, así que elegir una no cuesta nada en fidelidad. Lo que la rejilla no hará es refluar prosa: un artículo de dos columnas sale con ambas columnas lado a lado, fielmente, lo que está bien para un diff y mal para un resumidor. Otras dos llamadas cubren ese hueco. ExtractLoadedPageTextColumns(PageIndex, AText, ColumnGapMultiplier) parte cada fila donde el hueco entre glifos vecinos supera el multiplicador por el avance medio (3.0 por defecto) y separa los trozos con un tabulador. ExtractLoadedPageStructureText(PageIndex, AText, UntaggedGlyphCount) recorre el árbol de estructura de un PDF etiquetado (ISO 32000-1 §14.8.4) y devuelve las corridas de marked-content en orden de autoría; devuelve False cuando la página no tiene un árbol de estructura utilizable, y UntaggedGlyphCount te dice cuántos glifos no pudo colocar
Para texto que va a leer una persona o un modelo de lenguaje, prueba primero el orden de estructura y cae a ExtractLoadedPageText. El árbol de estructura es el único orden que el autor declaró a propósito, y todo método geométrico es una suposición en comparación. Guarda la rejilla para los trabajos donde las columnas son datos. Extracción de texto en orden de estructura tiene los detalles de cómo el marked content se empareja con el árbol
Cómo descodifica HotPDF los códigos de carácter a Unicode
HotPDF Delphi Component resuelve cada código de carácter a través de una cadena de fallbacks en orden de prioridad, y una estrategia que no puede responder le pasa el código a la siguiente. El CMap /ToUnicode de la fuente (ISO 32000-1 §9.10.3) va primero, porque es el único mapeo que el productor escribió específicamente para extracción. Tras él vienen los nombres de glifo de una matriz /Differences de /Encoding, leídos por la Adobe Glyph List; luego el propio CMap de /Encoding, incrustado como flujo o nombrado, donde un nombre Uni…-UTF16 significa que el código ya es UTF-16. Las fuentes compuestas continúan por las colecciones de caracteres de Adobe (Adobe-GB1, Adobe-CNS1, Adobe-Japan1, Adobe-Korea1, Adobe-KR) de CID a Unicode, y luego por /CIDToGIDMap hasta la tabla cmap del programa de fuente incrustado, leída a la inversa de glifo a Unicode. Las fuentes simples caen a las tablas WinAnsi, MacRoman, Standard y MacExpert y por último a ese mismo cmap incrustado. Un código que agota la cadena se resuelve a 0
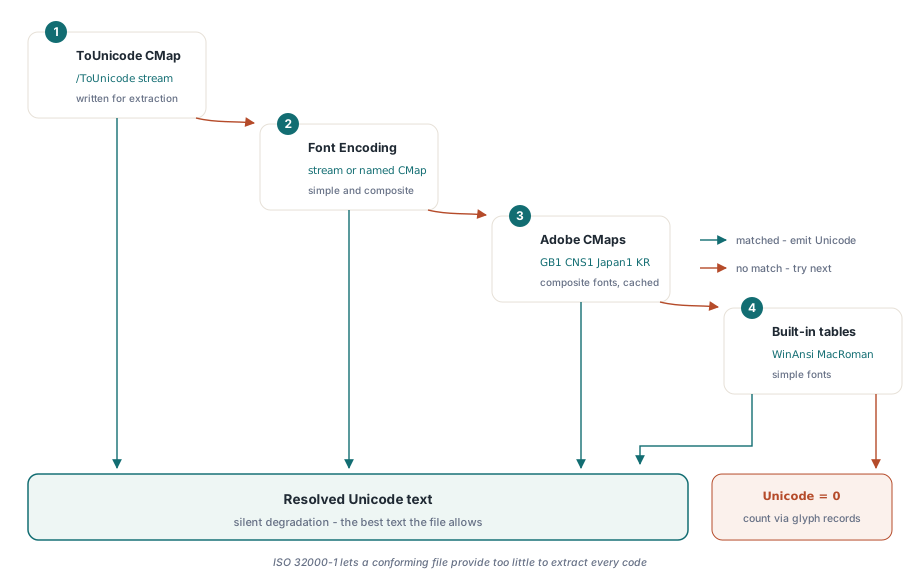
El paso del cmap incrustado es lo que rescata a muchas fuentes subset que vienen sin /ToUnicode: el programa de fuente normalmente todavía contiene su propio cmap Unicode, y reversarlo recupera la mayor parte del texto. Es una reconstrucción, eso sí. Dos caracteres Unicode que comparten un glifo volverán ambos como el que liste el cmap, así que trata el texto recuperado como bueno para búsqueda e indexación y compruébalo antes de usarlo como registro legal
Los datos de colecciones de Adobe viven en disco. HotPDF trae los archivos CMap y cid2code.txt bajo su carpeta resources\CMap, analiza cada archivo como mucho una vez por proceso y cachea el resultado; el mapa Adobe-GB1 solo ya son unos 2 MB de texto que no quieres analizar por página. Los CMaps predefinidos existen también como tablas integradas, así que una fuente codificada con un CMap nombrado como UniGB-UTF16-H sigue descodificando sin la carpeta. Las tablas CID a Unicode para fuentes CJK Identity-H sí la necesitan. La propiedad CMapResourcePath nombra la carpeta que contiene los subdirectorios de colecciones; dejada vacía, HotPDF busca resources\CMap junto al ejecutable y uno o dos niveles por encima
Pdf := THotPDF.Create(nil);
try
  // Carpeta que contiene Adobe-GB1-6, Adobe-CNS1-7, Adobe-Japan1-7 ...
  Pdf.CMapResourcePath := 'C:\MyService\resources\CMap';
  Pdf.LoadFromFile(FileName);
  ...
finally
  Pdf.Free;
end;
Pon la ruta explícitamente en cualquier servicio, módulo ISAPI o DLL de plugin. En esos anfitriones ParamStr(0) nombra el proceso anfitrión, que rara vez es la carpeta a la que desplegaste, y una carpeta ausente no lanza excepción; las páginas CJK simplemente vuelven con huecos donde las tablas de colecciones habrían rellenado. El modelado de texto de scripts complejos con HotPDF se encuentra con la misma división código contra glifo en el momento de escribir
Dos trampas de sintaxis de CMap
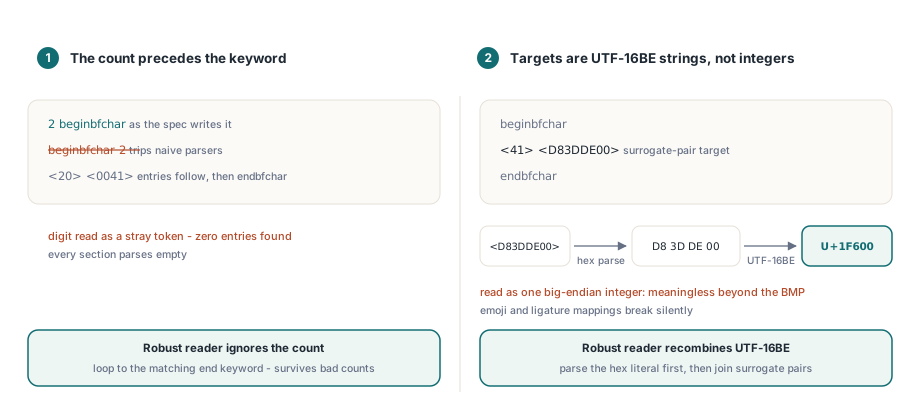
Los archivos CMap parecen triviales de analizar, y dos detalles hacen tropezar a la mayoría en el primer intento. El recuento de registros va antes de la palabra clave de la sección: una sección dice 2 beginbfchar, nunca beginbfchar 2. Un analizador que espera el recuento después de la palabra clave se traga el número como un token perdido y luego encuentra cero entradas en todas las secciones. El lector de HotPDF ignora el recuento por completo y hace el bucle hasta el endbfchar o endbfrange coincidente, lo que también resuelve los archivos reales cuyos recuentos declarados están equivocados
La segunda trampa es que los destinos de bfchar y bfrange son cadenas UTF-16BE. El destino <D83DDE00> significa U+1F600, un par de sustitutos que hay que recombinar en un solo code point, y leer esos cuatro bytes como un entero big-endian produce un valor sin sentido para cada carácter fuera del Plano Multilingüe Básico, emoji incluidos. HotPDF analiza primero el literal hexadecimal a bytes crudos y luego recombina las unidades de código UTF-16BE, lo que también maneja los destinos de varios caracteres que producen los mapeos de ligaduras, como un glifo fi que mapea a dos letras
Contar los glifos sin resolver con ExtractLoadedPageGlyphs
ExtractLoadedPageGlyphs(PageIndex, AGlyphs) expone los registros de glifo debajo de las llamadas de texto como una THPDFGlyphArray. Cada THPDFGlyphRecord lleva el Code crudo, su CodeByteWidth (1, 2 o 4, decidido por el codespacerange del CMap), el code point Unicode resuelto más un UnicodeSequence para ligaduras, el FontKey y FontSize activos, el origen X y Y en espacio de usuario, el Advance, un cuadrilátero de glifo de cuatro esquinas, y GlyphEndX / GlyphEndY, el final del ancho propio del glifo desde el que mide la regla de espacio entre palabras. Es suficiente para resaltado posicionado o un algoritmo de diseño propio
var
  Glyphs: THPDFGlyphArray;
  I, Unresolved: Integer;
begin
  if Pdf.ExtractLoadedPageGlyphs(0, Glyphs) then
  begin
    Unresolved := 0;
    for I := 0 to High(Glyphs) do
      if Glyphs[I].Unicode = 0 then
        Inc(Unresolved);
    if Unresolved > 0 then
      ShowMessageFmt('%d of %d glyphs have no Unicode mapping',
        [Unresolved, Length(Glyphs)]);
  end;
end;
Contar los registros con Unicode = 0 es la manera honesta de juzgar un documento antes de fiar su texto a etapas posteriores. Espera que el conteo difiera ligeramente de lo que ven las llamadas de texto. Esta llamada devuelve cada glifo del flujo de contenido propio de la página, incluidos los que están fuera del crop box y los duplicados pintados para fingir negrita, y no baja a los Form XObjects. Cada registro guarda además TokenIndex, ItemIndex y ByteOffset, que atan el carácter a su operando de origen; buscar y reemplazar en un PDF existente está construido sobre esos tres campos
Algunos archivos no tienen texto que dar. Una página escaneada es una imagen grande sin operadores de texto, así que la extracción devuelve correctamente una cadena vacía, y la ruta a seguir es OCR, empezando por extraer las imágenes de la página del PDF cargado. Los documentos cifrados extraen con normalidad una vez abiertos con LoadFromFile(FileName, Password), porque los flujos se descifran antes de que el intérprete los lea. Los flujos de fuente y de contenido se descodifican por la misma cadena de filtros que el resto del documento cargado, y un flujo /ToUnicode que no se pueda descodificar cae a la siguiente estrategia mientras el resto de la página sigue extrayéndose. El mismo lector de objetos respalda editar metadatos en documentos cargados, así que una pasada de entrada puede leer texto y arreglar metadatos
La extracción en orden de lectura, en rejilla, en columnas y en orden de estructura, más el acceso a nivel de glifo, viajan todos en el HotPDF Delphi Component para Delphi y C++Builder como Object Pascal plano sin DLL externas ni servicios de texto del sistema operativo, así que cuando un archivo raro aterrice en tu cola puedes entrar paso a paso en el descodificador y ver qué estrategia respondió por cada código