Tienes un PDF en el disco, un cliente lo ha escaneado desde una pila de facturas y tu trabajo consiste en sacar de nuevo las imágenes de las páginas como mapas de bits para una pasada de OCR. Cargas el archivo, localizas los objetos XObject de imagen y entonces descubres la parte que nadie te advierte: los bytes de esos flujos no son píxeles. Son un codestream JPEG, o un blob JPEG 2000 comprimido por wavelets, o una pasada de fax Grupo 4, o un raster indexado detrás de una paleta detrás de un filtro Flate. El objeto de imagen conoce su ancho y alto, pero las muestras reales están selladas dentro del filtro que haya elegido el productor. Obtener un TBitmap utilizable significa deshacer ese filtro, y PDF te da más o menos ocho maneras distintas de sellar esos bytes
Ese hueco es justo el que rellena ExtractLoadedImage en HotPDF, el componente PDF VCL nativo para Delphi y C++Builder. Enumera los XObject de imagen de un documento que has cargado, informa de qué es cada uno y decodifica los que puede de vuelta a un mapa de bits de 24 bits. Lo interesante no es la superficie de la API, que son tres métodos, sino por qué tiene que existir una ruta de decodificación separada y qué filtros convierte de nuevo en píxeles
Por qué las imágenes cargadas no están ya decodificadas
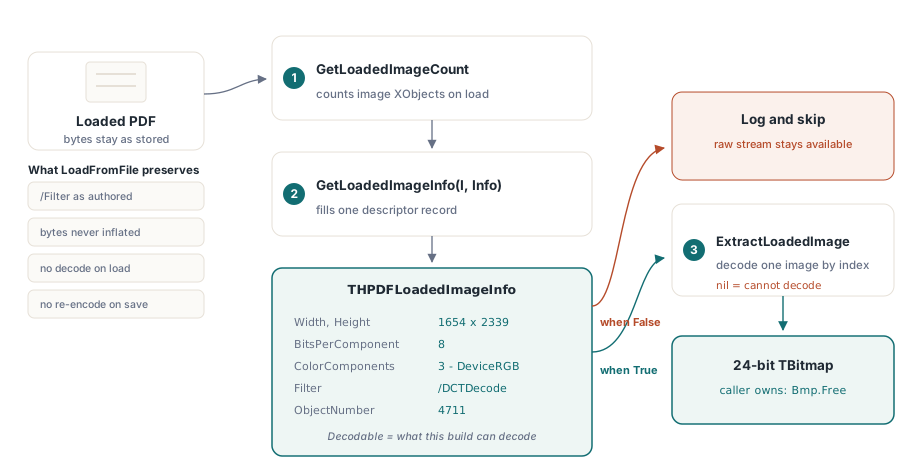
El cargador de HotPDF se basa en la fidelidad de paso directo. Cuando llamas a LoadFromFile, los flujos de imagen se conservan exactamente tal como aparecen en el archivo de origen: el filtro original, los bytes comprimidos originales y el diccionario original. Eso es deliberado. El propósito de cargar un documento suele ser copiar páginas, fusionar archivos, estamparlos, cambiarles permisos y escribirlos de nuevo, y para todo eso lo más barato y seguro es dejar intacto cada flujo de imagen. Decodificar todas las imágenes a un raster al cargar consumiría memoria y CPU en trabajo que la mayoría de los llamadores nunca necesita, y volver a codificar al guardar degradaría imágenes que deberían haberse copiado literalmente
La consecuencia es que el grafo de objetos cargado no lleva píxeles. Un XObject de imagen cuyo /Filter es /DCTDecode contiene bytes JPEG; HotPDF nunca ejecutó un decodificador JPEG sobre él, porque nada en la ruta de copia y reescritura lo necesitaba. Así que cuando realmente quieres píxeles, la API de extracción tiene que hacer ella misma la decodificación, desde cero, para el filtro concreto que use esa imagen. Es la misma razón por la que los códecs de la parte de codificación son independientes del cargador: el artículo sobre añadir imágenes JPEG 2000 a PDFs en Delphi describe cómo el motor JPX se acopla a la parte de creación, y la API de extracción conecta ese mismo motor en la ruta de lectura
La API de tres métodos
La superficie es pequeña. GetLoadedImageCount devuelve cuántos XObject de imagen contiene el documento cargado. GetLoadedImageInfo rellena un registro descriptor para uno de ellos por índice. ExtractLoadedImage devuelve el mapa de bits decodificado, o nil cuando no puede decodificar esa imagen. La enumeración se basa en índices y es estable para una carga dada: internamente recorre la tabla de objetos indirectos y recopila todos los flujos cuyo /Subtype resuelve a /Image, de modo que el índice que pasas a GetLoadedImageInfo es el mismo que pasas a ExtractLoadedImage
var
  Pdf: THotPDF;
  Info: THPDFLoadedImageInfo;
  Bmp: TBitmap;
  I, Count: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('scanned-invoices.pdf', '') <= 0 then
      Exit;
    Count := Pdf.GetLoadedImageCount;
    for I := 0 to Count - 1 do
    begin
      if not Pdf.GetLoadedImageInfo(I, Info) then
        Continue;
      if not Info.Decodable then
        Continue;                       // filtro o espacio de color no admitido
      Bmp := Pdf.ExtractLoadedImage(I);
      if Bmp <> nil then
      try
        Bmp.SaveToFile(Format('img_%d.bmp', [I]));
      finally
        Bmp.Free;                       // el llamador es propietario del mapa de bits
      end;
    end;
  finally
    Pdf.Free;
  end;
end;
Dos detalles del contrato importan aquí. Primero, el TBitmap devuelto es tuyo y debes liberarlo; el documento no lo cachea ni lo posee. Segundo, comprueba Decodable antes de llamar y comprueba el resultado frente a nil después. El método no lanza una excepción con un filtro no compatible, devuelve nil, y un nil silencioso en un bucle por lotes es exactamente el tipo de cosa que se traga una página de un trabajo de mil páginas sin que nadie lo note
Leer el descriptor antes de decodificar
THPDFLoadedImageInfo te dice qué es una imagen sin comprometerse con una decodificación completa. Sus campos salen directamente del diccionario de la imagen: Width y Height en muestras, BitsPerComponent, ColorComponents y ColorSpace que describen la interpretación tras la decodificación (1 para gris, 3 para RGB, 4 para CMYK), Filter como la compresión nombrada, IsImageMask para máscaras de esténcil, ObjectNumber para el objeto indirecto subyacente y Decodable
Esa última bandera es la honesta. Decodable es True solo cuando la compilación en ejecución puede convertir de verdad esa combinación concreta de filtro y espacio de color en un mapa de bits. Codifica la matriz real de compatibilidad, no un deseo: una imagen cuyo Filter la compilación actual no entiende informa Decodable = False, y puedes ramificar a partir de ahí para registrar, omitir o recurrir a extraer tú mismo el flujo bruto. Trátalo como una precondición, no como una pista
// Clasifica cada imagen antes de comprometerse con una decodificación.
var
  Pdf: THotPDF;
  Info: THPDFLoadedImageInfo;
  I: Integer;
begin
  // ... Pdf cargado ...
  for I := 0 to Pdf.GetLoadedImageCount - 1 do
  begin
    if not Pdf.GetLoadedImageInfo(I, Info) then
      Continue;
    if Info.Decodable then
      // ExtractLoadedImage(I) devolverá un TBitmap
    else
      // filtro o espacio de color no admitido: registra el objeto y se lo salta
      Writeln(Format('Image %d obj %d: %dx%d %s/%s not decodable',
        [I, Info.ObjectNumber, Info.Width, Info.Height,
         String(Info.Filter), String(Info.ColorSpace)]));
  end;
end;
Un detalle de implementación muerde a quien construye registros descriptor a mano. THPDFLoadedImageInfo contiene dos campos AnsiString, Filter y ColorSpace. Son tipos administrados con recuento de referencias, así que el reflejo de poner a cero un registro con FillChar(Info, SizeOf(Info), 0) no vale aquí: sobrescribe la referencia de la cadena sin decrementarla, lo que provoca fugas o corrupción. HotPDF inicializa el registro campo por campo precisamente por eso, y si alguna vez copias este patrón en tu propio código, haz lo mismo
Un despachador, ocho rutas de filtro
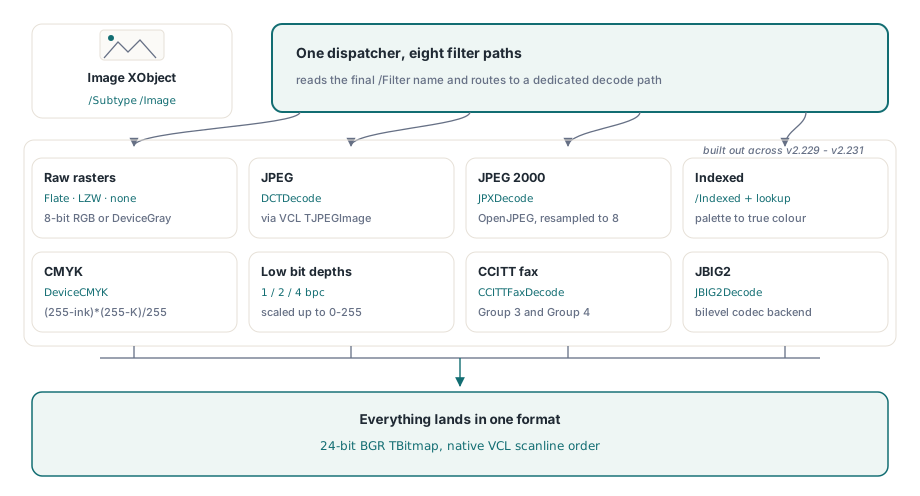
La razón de que la extracción necesite un despachador es que PDF no tiene un formato de imagen: tiene filtros, y el §8.9.5 de ISO 32000-1 permite que un XObject de imagen nombre cualquiera de ellos en /Filter, con la interpretación de las muestras regida aparte por /ColorSpace, /BitsPerComponent y un array /Decode opcional. ExtractLoadedImage lee el nombre del filtro y deriva cada caso a un decodificador dedicado. El conjunto admitido cubre ocho rutas distintas
- Rasteres brutos (FlateDecode, LZWDecode o sin filtro) en DeviceRGB o DeviceGray de 8 bits. Los bytes se expanden a un raster empaquetado y la única transformación es un intercambio de canales, que se explica más abajo
- DCTDecode (JPEG). El codestream se entrega a
TJPEGImagede la VCL, que resuelve la geometría y el color, y el resultado se asigna a un mapa de bits de 24 bits - JPXDecode (JPEG 2000). Se decodifica a través del backend OpenJPEG, el mismo motor descrito en el artículo de JPEG 2000, con componentes de alta profundidad de bits remuestreados a 8 bits
- Color indexado. La paleta se lee del array
[/Indexed base hival lookup]y cada muestra se expande a color verdadero a través de la tabla de búsqueda - DeviceCMYK. Las muestras de cuatro canales se convierten a RGB con la fórmula estándar de tinta sobre blanco
- DeviceGray e Indexed por debajo de 8 bits a 1, 2 o 4 bits por componente, desempaquetados muestra a muestra y escalados al rango 0–255
- CCITTFaxDecode, los filtros de fax Grupo 3 y Grupo 4, decodificados por un backend T.4/T.6 dedicado
- JBIG2Decode, el filtro monocromo de alta compresión, decodificado mediante el backend JBIG2 registrado que el artículo sobre compresión JBIG2 nativa cubre desde el lado de la codificación
Todo termina en el mismo sitio: un mapa de bits BGR de 24 bits, porque eso es lo que almacena nativamente un TBitmap de la VCL y lo que espera cualquier consumidor aguas abajo
Las transformaciones que cambian píxeles sin avisar
Dos de estas rutas implican una transformación que es fácil hacer mal de forma sutil, y merece la pena entenderla aunque nunca toques el decodificador tú mismo. La primera es el intercambio del orden de color. Un raster PDF DeviceRGB almacena las muestras en orden rojo-verde-azul, con la fila superior primero. Un scanline de 24 bits de la VCL las almacena en orden azul-verde-rojo. Así que decodificar una imagen RGB normal no es un memcpy; el primer y el tercer byte de cada píxel se intercambian al entrar en el scanline. Si lo haces al revés, los rojos y los azules se intercambian, lo que parece bien en una imagen de prueba en escala de grises y fatal en una imagen en color. El orden de las filas, por cierto, se mapea directamente: los raster descendentes de PDF se alinean con ScanLine[0] de la VCL como fila visual superior, así que no hace falta voltear verticalmente
La segunda es CMYK. Las imágenes PDF DeviceCMYK llevan cuatro tintas, y la conversión a RGB es un cálculo por canal, no una tabla: cada canal de salida es (255 - ink) * (255 - K) / 255. Esto es una aproximación de dispositivo, no una conversión gestionada por color a través de un perfil ICC, así que el resultado es suficiente para mostrar y volver a rasterizar, pero no es la ruta adecuada si necesitas un color exacto para impresión. Si tu flujo de trabajo exige fidelidad, trata el mapa de bits extraído como una vista previa y conserva el flujo CMYK original para la cadena gestionada por color
La ruta Indexed oculta su propia trampa de análisis. La paleta en un espacio de color /Indexed puede almacenarse como una cadena literal o como una cadena hexadecimal, y HotPDF almacena el valor de una cadena hex como el texto hexadecimal, no como los bytes decodificados. Así que cuando la paleta es una cadena hex, la tabla de búsqueda tiene que pasar primero por una decodificación de hex a bytes; una cadena literal ya son bytes en bruto. Si pasas por alto esa rama, una imagen indexada de cuatro colores sale hecha un desastre, porque cada entrada de la paleta se está leyendo con el límite de byte equivocado
Cadenas de filtros: el último filtro es el propio de la imagen
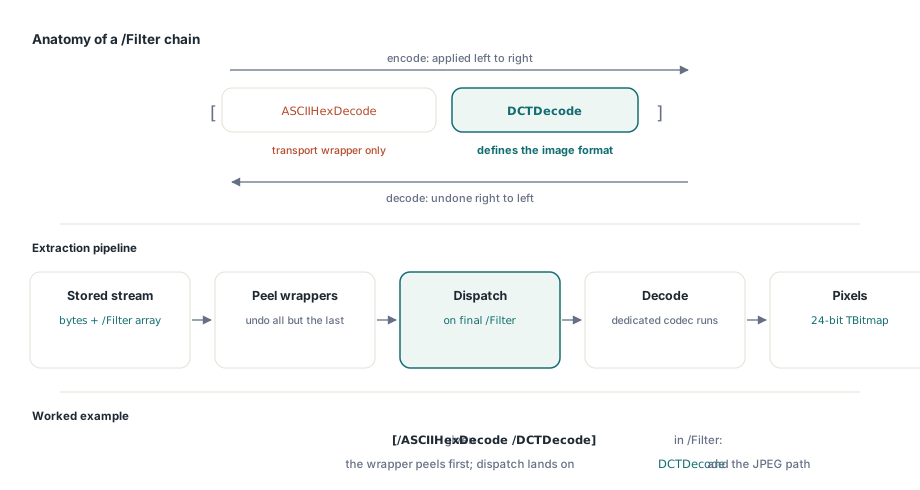
Un único nombre de /Filter es el caso fácil. PDF también permite una cadena de filtros, donde el flujo ha pasado por varios en secuencia, listados en orden dentro de un array /Filter como [/ASCII85Decode /FlateDecode] o [/ASCIIHexDecode /DCTDecode] (ISO 32000-1 §7.4). La semántica es precisa: los filtros se aplican de izquierda a derecha al codificar, así que al decodificar los deshaces de derecha a izquierda, y el último filtro del array es el que define realmente el formato de imagen. Los filtros iniciales no son más que codificaciones de transporte envueltas alrededor
El extractor maneja esto pelando capas. Antes de que se ejecute cualquier decodificador de imagen, se aplica cada filtro de la cadena excepto el último para producir la entrada que espera el filtro final, y solo entonces se despacha sobre ese último filtro. Así, [/ASCII85Decode /DCTDecode] primero deshace ASCII85 del flujo y luego envía el resultado por la ruta JPEG; [/FlateDecode] envuelto sobre un raster bruto lo expande y luego ejecuta la ruta raster. Esto es lo que permite que los ocho decodificadores sigan siendo simples. Ninguno tiene que saber nada de envoltorios ASCII85 o hex de transporte, porque cuando el decodificador ve los bytes, los envoltorios ya han desaparecido. También significa que una cadena cuyo filtro final no está soportado falla limpiamente en el paso de despacho y no a medias
Qué devuelve y cuándo usar el flujo bruto
Lo que obtienes es la imagen base tal como la decodifica su propio flujo, no un resultado compuesto con la máscara blanda aplicada. Los componentes JPEG 2000 de más de 8 bits se remuestrean a 8, lo que sirve para visualización y OCR, y una máscara de imagen, una plantilla de 1 bit sin color propio, queda señalada por IsImageMask para que la trates como una plantilla y no como una foto. Una imagen cuyo filtro final o espacio de color se sale del conjunto anterior devuelve nil, y por eso la comprobación Decodable pertenece a todos los bucles
Cuando necesitas alfa, profundidad de color completa o salida con gestión de color, el flujo bruto sigue estando ahí mismo en el grafo de objetos cargado, filtro incluido, y puedes sacarlo byte a byte y entregárselo a un códec especializado tuyo. Ese es el recurso de reserva que el diseño de paso directo conserva a propósito: los bytes originales nunca se descartan, así que el peor caso es que los decodifiques tú mismo, no que los datos hayan desaparecido. Para la mayoría de los trabajos reales, aun así, los ocho filtros admitidos cubren lo que realmente emiten escáneres, suites ofimáticas y motores de informes, y un bucle sobre GetLoadedImageCount con la comprobación Decodable convierte un PDF cargado en una carpeta de mapas de bits en unas pocas líneas
La API de extracción de imágenes cargadas, junto con el conjunto completo de filtros de decodificación descritos aquí, se distribuye en el HotPDF Delphi Component para Delphi y C++Builder