El fragmento de flujo de contenido [(Reference)-333(Manual)] TJ pinta dos palabras con un hueco claro entre ellas, y sin embargo no contiene ningún carácter de espacio. El hueco es movimiento del lápiz: ISO 32000-1 §9.4.3 le dice al lector que desplace el siguiente glifo 333 milésimas del tamaño de fuente hacia la derecha antes de dibujar Manual. Un extractor que copia caracteres e ignora la geometría devuelve ReferenceManual, y un índice de búsqueda alimentado desde él nunca encontrará la frase “Reference Manual”. La salida de TeX, muchos ficheros de Distiller y la mayoría de los maquetados justificados separan palabras así
Los saltos de línea fallan desde el otro lado. Un superíndice alzado parte su línea en dos, una marca de agua diagonal de DRAFT llega un carácter por línea, y una prueba recortada encabeza con el printer’s slug line que ningún visor muestra nunca. Ninguno de estos ficheros está roto. Cada uno usa una forma legal de colocar texto que un extractor copiador de caracteres lee mal
Espacios de palabra reconstruidos desde la geometría de los glifos
THotPDF.ExtractLoadedPageText en HotPDF Delphi Component decide los saltos de palabra a partir de posiciones de glifos, y un carácter de espacio en el flujo es solo una de las señales que lee. A lo largo de la dirección de escritura del glifo anterior (el previous glyph’s writing direction), mide la distancia desde el final del ancho propio de ese glifo (that glyph’s own width) hasta el origen del glifo actual, e inserta un espacio cuando la distancia supera 0.15 de la altura de la caja del glifo actual (the current glyph’s box height), medida del ascendente al descendente en espacio de usuario. Para el fragmento TJ de arriba, un tercio de em se queda holgadamente pasado ese límite para cualquier fuente de texto ordinaria, así que el texto de la página lee Reference Manual
Dos condiciones retienen el espacio. No se añade nada cuando el texto hasta el momento ya acaba en un blanco o el siguiente glifo es uno (espacio, tabulador, espacio de no ruptura, espacio ideográfico), así que los productores que sí muestran espacios nunca reciben espacios dobles. Tampoco se añade nada entre dos caracteres CJK. Ideogramas, kana, hangul y formas de ancho completo cuentan todos, porque la justificación estira una línea china o japonesa sin que ese estiramiento signifique un límite de palabra. Aparte de ambos, una caja de glifo con altura cero recurre al tamaño del Tf como su altura. Cada número que la regla usa está guardado en los registros de glifo, así que un fichero cuyo espaciado parezca equivocado se puede reproducir glifo a glifo
uses
  SysUtils, HPDFDoc, HPDFContentStream;

// Muestra los huecos que ExtractLoadedPageText convertiría en espacios.
// Solo texto horizontal; ExtractLoadedPageGlyphs devuelve el flujo de
// contenido de la página sin texto de Form XObject y sin el filtro de recorte
procedure DumpWordGaps(Pdf: THotPDF; PageIndex: Integer);
var
  Glyphs: THPDFGlyphArray;
  I: Integer;
  Height, Gap: Double;
begin
  if not Pdf.ExtractLoadedPageGlyphs(PageIndex, Glyphs) then
    Exit;
  for I := 1 to High(Glyphs) do
  begin
    if Glyphs[I].Vertical or Glyphs[I - 1].Vertical then
      Continue;
    // altura de ascendente a descendente de la caja del glifo, en espacio de usuario
    Height := Sqrt(Sqr(Glyphs[I].QuadX[3] - Glyphs[I].QuadX[0]) +
      Sqr(Glyphs[I].QuadY[3] - Glyphs[I].QuadY[0]));
    if Height <= 0 then
      Height := Abs(Glyphs[I].FontSize);
    // hueco desde el final del ancho propio del glifo anterior
    Gap := Glyphs[I].BaselineStartX - Glyphs[I - 1].GlyphEndX;
    if (Height > 0) and (Gap > 0.15 * Height) then
      Writeln(Format('U+%.4x gap %.2f height %.2f: space',
        [Glyphs[I].Unicode, Gap, Height]));
  end;
end;
¿Por qué medir desde el ancho propio del glifo (the glyph’s own width) y no desde la posición del lápiz?
Porque la posición del lápiz tras un glifo ya contiene espaciado que no tiene nada que ver con los saltos de palabra. ISO 32000-1 §9.4.4 define el desplazamiento horizontal como el ancho del glifo por el tamaño de fuente, más el character spacing Tc, más el word spacing Tw, todo escalado por el horizontal scaling Tz. Cada registro de glifo lleva ambos extremos: BaselineEndX / BaselineEndY guardan ese desplazamiento completo, mientras que GlyphEndX / GlyphEndY guardan solo el avance de la fuente (the font’s advance) al tamaño actual y el Tz. Los dos divergen en ficheros que aprietan el tracking con un Tc negativo y devuelven el espacio mediante un ajuste TJ tras cada glifo. Medido desde el lápiz, cada devolución parece un hueco, y un término chino como “95后” sale como “9 5 后”. Medido desde el ancho propio del glifo (the glyph’s own width), el ajuste solo devuelve lo que el Tc se llevó, y el término se queda intacto
El umbral va atado a la altura de la caja del glifo en lugar del tamaño del Tf por una razón parecida. Las exportaciones de Word a menudo escriben 1 Tf y llevan el tamaño real en un Tm escalado, así que el operando de tamaño de fuente lee 1 mientras el texto mide 10 puntos. Una regla anclada a ese operando pondría el umbral en 0.15 puntos en semejante página, y los pares de kerning ordinarios empezarían a leerse como saltos de palabra. La altura de la caja se mide después de aplicar todas las matrices, así que un 1 Tf con matriz escalada y un 10 Tf llano producen el mismo texto
Dos casos límite se siguen directamente de la geometría. Un titular maquetado con un letter spacing muy suelto, donde el Tc solo abre más de 0.15 de la altura del texto entre letras, se extrae como S P A C E D. Eso es lo que muestra la página, y preferimos devolverlo antes que añadir una heurística que adivine qué huecos anchos son tracking y cuáles son palabras; una adivinanza así empieza a tragarse saltos de palabra reales en columnas fuertemente justificadas, que es un fallo peor para la búsqueda. Piezas dibujadas fuera de orden sobre una misma línea base producen un hueco negativo y se unen sin espacio. En texto corrido ese caso es raro
¿Cuándo empieza una línea nueva en el texto extraído?
ExtractLoadedPageText inicia una línea nueva cuando el movimiento desde el origen del glifo anterior (the previous glyph’s origin) hasta el actual, proyectado sobre la normal de la dirección de escritura anterior, supera la mitad de la mayor altura de caja de los dos glifos. El movimiento a lo largo de la línea base nunca cuenta para un salto de línea, por mucho que salte el lápiz
Una regla que compare el movimiento Y en bruto con la mitad del tamaño del Tf falla en dos direcciones. Con 1 Tf y un Tm escalado el umbral se encoge a media unidad, así que un superíndice alzado por un text rise de 0.4 parte la línea. También la parte el pequeño jitter de línea base que algunos motores de maquetación dejan entre runs. La misma regla ignora la X por completo. Un texto bajo un Tm rotado, como esa marca de agua diagonal, baja escalón a escalón por la página con cada glifo y sale un carácter por línea, mientras que la proyección trata una corrida de 45 grados exactamente igual que una horizontal
Tomar la mayor de las dos alturas importa cuando se mezclan tamaños en una línea. Una palabra de exhibición de 36 puntos seguida de una leyenda de 8 puntos unos puntos más abajo se juzga contra la mitad de la altura del glifo grande (the large glyph’s height), así que la pareja se queda junta; juzgada contra el glifo pequeño solo, la leyenda caería en una línea propia. El text rise forma parte del origen del glifo, que es por lo que el baseline alzado de un superíndice (a superscript’s raised baseline) se mide contra esa misma media altura
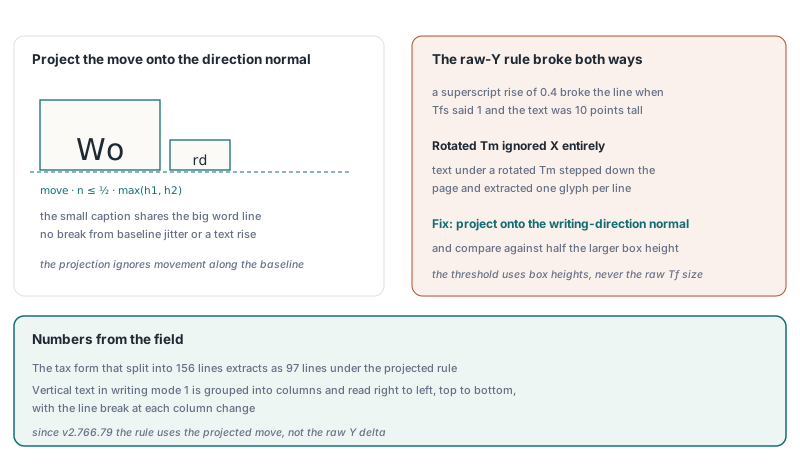
El texto vertical en modo de escritura 1 (§9.7.4.3) toma un camino aparte. Esos glifos se agrupan en columnas por su X de origen, con la mitad del tamaño de fuente como tolerancia de columna, y luego se leen de derecha a izquierda y de arriba abajo, con un salto de línea en cada cambio de columna. Una página que mezcla un cuerpo japonés vertical con una cabecera corriente horizontal recibe también un salto de línea en cada cambio entre las dos direcciones
Qué glifos llegan al texto de la página
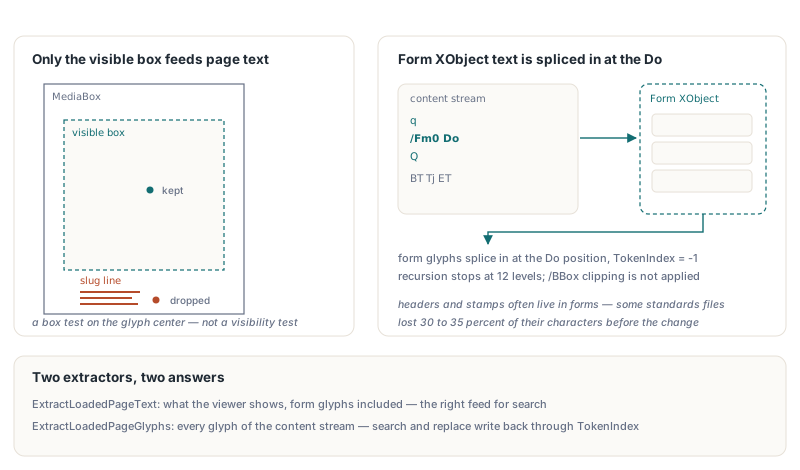
ExtractLoadedPageText devuelve el texto que muestra un visor. Conserva solo los glifos cuyo centro de caja cae dentro de GetLoadedPageVisibleBox, que es el CropBox recortado al MediaBox (§14.11.2), así que las líneas de slug y demás printer’s marks puestas como texto fuera del área de corte desaparecen. ExtractLoadedPageGlyphs sigue devolviendo cada glifo del flujo de contenido de la página, línea de slug incluida, para los trabajos que lo necesiten. El filtro es un test geométrico sobre un punto por glifo. El texto oculto por un clipping path, pintado en blanco o cubierto por una imagen sigue saliendo, porque decidir la visibilidad real significaría renderizar la página
uses
  SysUtils, HPDFDoc, HPDFContentStream;

var
  Pdf: THotPDF;
  Raw, Merged: THPDFGlyphArray;
  PageText: UnicodeString;
  L, B, R, T: Single;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.LoadFromFile('trimmed-proof.pdf');
    if Pdf.GetLoadedPageVisibleBox(0, L, B, R, T) then
      Writeln(Format('Visible box: %.1f %.1f %.1f %.1f', [L, B, R, T]));
    // cada glifo del flujo de contenido de la página, línea de slug incluida
    if Pdf.ExtractLoadedPageGlyphs(0, Raw) then
      Writeln(Length(Raw), ' glyphs in the page content stream');
    // flujo de página más texto de Form XObject, en orden de pintado, antes del recorte
    if Pdf.ExtractLoadedPageGlyphsWithForms(0, Merged) then
      Writeln(Length(Merged), ' glyphs including forms');
    // lo que muestra la página: formularios empalmados, glifos fuera del recorte descartados
    if Pdf.ExtractLoadedPageText(0, PageText) then
      Writeln(PageText);
    // las mismas reglas de espaciado sobre el flujo sin filtrar, para un diff
    Writeln(HPDFAssemblePageText(Raw));
  finally
    Pdf.Free;
  end;
end.
El texto pintado a través de Form XObjects es parte del texto de la página. Las cabeceras, los sellos y las marcas de agua viven muy a menudo en formularios, y un extractor que lee solo el flujo de contenido de la página jamás los ve. HotPDF registra cada Do junto con el CTM vigente, interpreta el formulario en su /Matrix por ese CTM (§8.10.1), y empalma los glifos del formulario (the form’s glyphs) en la posición del Do, recursando en formularios anidados. Un formulario sin /Resources propio toma prestados los del flujo que lo pinta, la disposición antigua que describe §7.8.3. Los glifos cuyo centro cae fuera del /BBox del formulario (the form’s /BBox) se dejan fuera, ya que esa caja recorta el formulario al pintarlo. Un formulario que se pinta a sí mismo, directamente o a través de otro formulario, no se entra una segunda vez, y el anidamiento se detiene en 12 niveles
Los glifos de formulario llevan TokenIndex = -1 e ItemIndex = -1. La misma razón mantiene ExtractLoadedPageGlyphs limitado a glifos del flujo de página: búsqueda, reemplazo y redacción escriben sus cambios de vuelta a través de TokenIndex, y un glifo de formulario en ese array los apuntaría a bytes de otro flujo. Cuando necesite la lista fusionada a nivel de glifo, ExtractLoadedPageGlyphsWithForms la devuelve en orden de pintado, antes de que corra el filtro de caja visible
Una pasada más corre antes de las reglas de espaciado. Los logotipos sobreimpresos y la negrita simulada pintando el mismo texto dos veces con un pequeño desplazamiento se extraerían con cada letra doblada. Cuando un glifo pinta el mismo carácter al mismo tamaño dentro de una décima de ese tamaño a lo largo de la línea base, y de una quinta parte a lo ancho, de un glifo anterior, solo se conserva una copia; los espacios nunca se eliminan de esta manera. El artículo sobre negrita falsa y glifos duplicados en la extracción de texto recorre ese caso
El estado de texto a través de q y Q
El texto tras un Q se decodifica mal en cualquier extractor que guarde solo el CTM en el q. Los parámetros del estado de texto, o sea fuente, tamaño, Tc, Tw, Tz, TL, modo de renderizado y rise, pertenecen al estado gráfico (§9.3.1), así que Q tiene que restaurarlos junto con todo lo demás de la pila (§8.4.2). Un patrón delata el error rápido: una fuente Identity-H de dos bytes se selecciona dentro de q … Q para una única celda de tabla, y el texto tras el Q muestra cadenas WinAnsi de un byte sin Tf propio. Un intérprete que conserva la fuente interna lee esos bytes en parejas, y los puntos de relleno de un índice se convierten en una tira de caracteres CJK sin relación. El intérprete de HotPDF apila los ocho valores del estado de texto junto con el CTM en cada q y los desapila en cada Q
Todo lo anterior aplica en cada página, así que un documento entero puede ir a un fichero UTF-8 en una sola llamada. ExtractLoadedPagesTextToStream toma un rango de páginas 1-based (una cadena vacía significa todas las páginas), un separador escrito entre páginas, y un flag para el byte order mark, y devuelve el número de páginas extraídas. La salida se añade en la posición actual del stream (the stream’s current position), así que nada mayor que el texto de una página (one page’s text) se mantiene en memoria
uses
  SysUtils, Classes, HPDFDoc;

var
  Pdf: THotPDF;
  Output: TFileStream;
  Pages: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.LoadFromFile('report.pdf');
    Output := TFileStream.Create('report.txt', fmCreate);
    try
      // rango vacío = todas las páginas; form feed entre páginas; BOM UTF-8
      Pages := Pdf.ExtractLoadedPagesTextToStream(Output, '', #12, True);
      Writeln(Pages, ' pages extracted');
    finally
      Output.Free;
    end;
  finally
    Pdf.Free;
  end;
end.
Elegir la API de texto para el trabajo
Para búsqueda e indexado, ExtractLoadedPageText es el alimento correcto: sigue el orden del flujo de contenido y refleja lo que muestra la página. La cadena de decodificación por debajo, de los mapas /ToUnicode a las fuentes CID, se cubre en extraer texto de PDFs cargados con HotPDF. El orden del flujo de contenido es más débil en documentos etiquetados cuyo productor escribió la cabecera corriente al final o intercaló dos columnas; para esos, la extracción de texto en orden de estructura recorre el árbol de estructura en orden de autoría en lugar de inferirlo de la geometría. Los datos atrapados en tablas quedan mejor servidos por la extracción de tablas tipadas a través de saltos de página, que devuelve celdas con sus valores. El código que edita la página pertenece a ExtractLoadedPageGlyphs, cuyos índices de token apuntan a los bytes que reescribirá
Los campos del registro de glifo usados en estos ejemplos, junto con el resto de la API de extracción de texto y una compilación de prueba, están documentados en la página del producto HotPDF Delphi PDF Component