El cuadro de búsqueda de un visor resalta "Acme Corp" en la página 2 de una factura, pero una búsqueda de bytes en el stream de página descomprimido de esos mismos nueve caracteres no encuentra nada. Solo para la primera palabra, el stream puede contener algo como <0024004600500048> Tj: códigos de glifo de dos bytes en una fuente de subconjunto incrustada, con el hueco entre las dos palabras producido por un offset de posicionamiento en lugar de un carácter de espacio. Reemplazar ese nombre implica decodificar esos códigos a Unicode, buscar allí, volver hasta los bytes exactos que produjeron la coincidencia y escribir códigos nuevos que la misma fuente entienda. Cuando el subconjunto nunca contuvo un glifo que el texto nuevo necesita, no hay códigos que escribir
Los encargos detrás de esto son mantenimiento documental corriente. Una empresa se renombra y tres mil facturas archivadas siguen llevando el nombre antiguo. Una plantilla de contrato salió con la fecha de caducidad del año pasado. Un número de pieza retirado tiene que convertirse en su sucesor en todas las fichas técnicas. En un procesador de textos cada una lleva treinta segundos; en un PDF cada una choca con cómo se guardan de verdad las páginas
Qué guarda una página PDF en lugar de texto
Una página PDF guarda glifos posicionados, no texto editable. Bajo ISO 32000-1 §9.4, el content stream gobierna operadores de mostrado de texto como Tj y TJ, que pintan secuencias de códigos de carácter en posiciones fijadas por la matriz de texto. Esos códigos son índices dentro de la codificación que declare la fuente actual. El camino de vuelta a caracteres legibles puede pasar por una CMap /ToUnicode (§9.10.3), un /Encoding con array /Differences, o una cadena de mapeo CID para fuentes Type0. No hay objeto de párrafo ni flujo de texto, y nada obliga a un productor a guardar una palabra visible como una sola cadena: [(Ac) -12 (me)] TJ es una forma perfectamente ordinaria de aplicar kerning a una palabra
El reemplazo añade un segundo requisito sobre la decodificación. Un extractor de texto puede tirar las posiciones de byte una vez ha sacado el Unicode. Un reemplazador las necesita, porque debe saber qué bytes de qué operando de cadena produjeron cada glifo, para reescribir exactamente ese rango y no tocar nada más. Por eso un StringReplace a secas sobre los bytes del stream es la herramienta equivocada incluso en ficheros que por casualidad usan codificación WinAnsi. No tiene idea de qué ( pertenece a una cadena ni de qué Tf selecciona la fuente que da a esos bytes su significado
Buscar en la secuencia de glifos decodificada
HotPDF Delphi Component busca en un documento cargado con SearchLoadedPageText y SearchLoadedDocumentText, que comparan la aguja contra la secuencia de glifos Unicode decodificada de cada página, nunca contra los bytes en bruto del stream. Una coincidencia es por tanto una coincidencia, codifique la fuente como la codifique. Durante la decodificación, cada glifo guarda registro del operando de cadena, del elemento del array TJ y del offset de byte del que vino, que es en lo que confía después el paso de reemplazo. El mismo intérprete de glifos gobierna la API tratada en extraer texto de un PDF cargado en Delphi; la búsqueda simplemente conserva las posiciones de origen que la extracción descarta
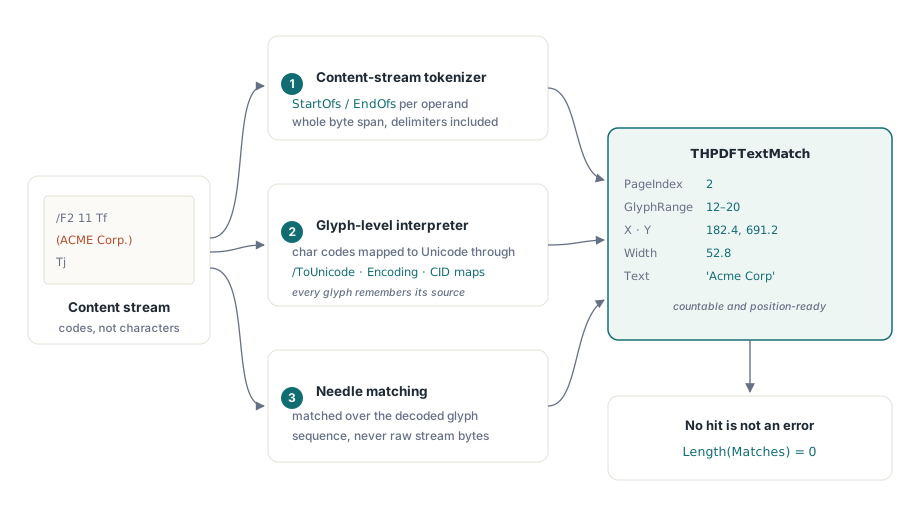
Cada coincidencia llega como un registro THPDFTextMatch: PageIndex, el rango de glifos inclusivo en GlyphStart y GlyphEnd, el origen en espacio de usuario en X e Y, el Width de la coincidencia, el TokenIndex y ItemIndex de origen, y el Text encontrado. PageIndex es basado en cero. Una aguja que no aparece da un array vacío y un resultado True, así que el código llamante no necesita ningún caso especial para "no se encontró nada"
var
  Pdf: THotPDF;
  Matches: THPDFTextMatchArray;
  I: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('invoices-2025.pdf') > 0 then
      if Pdf.SearchLoadedDocumentText('Acme Corp', False, Matches) then
        for I := 0 to High(Matches) do
          WriteLn(Format('page %d at (%.1f, %.1f), width %.1f: "%s"',
            [Matches[I].PageIndex + 1, Matches[I].X, Matches[I].Y,
             Matches[I].Width, Matches[I].Text]));
  finally
    Pdf.Free;
  end;
end;
Que ese bucle imprima algo depende, antes que nada, de los espacios. El texto de búsqueda se construye a partir de los glifos que la página pinta de verdad, un carácter por glifo, y un offset TJ que separa visualmente dos palabras es un número en un array, no un glifo. Un productor que fija los huecos entre palabras con offsets en lugar de un carácter de espacio produce "AcmeCorp" en la secuencia de glifos, y la aguja "Acme Corp" no la encontrará. Cuando una frase visible se niega a encontrarse, busca primero su palabra más larga y mira el Text de lo que vuelva
Las mayúsculas y minúsculas son lo otro que revisar. Con CaseSensitive a False, los builds desde Delphi XE2 en adelante comparan caracteres por el mapeo Unicode simple a minúsculas, que es independiente del locale, así que É encuentra é y las mayúsculas griegas o cirílicas encuentran sus formas en minúscula. Los builds con compiladores más antiguos solo pliegan de la A a la Z. El mapeo va de un carácter a un carácter, lo que mantiene cada posición de la aguja alineada con exactamente un glifo; la consecuencia es que ß no encuentra SS. Para flujos de UI de palabra completa, SearchLoadedPageTextWholeWord descarta las coincidencias que caen dentro de una palabra más larga, y GetLoadedSearchHitRect convierte una coincidencia en un único rectángulo para dibujar un resaltado
Buscar y reemplazar trabajan ambos sobre los streams /Contents propios de la página. El texto pintado dentro de un Form XObject, que es donde muchas herramientas meten cabeceras y pies estampados, vive en un stream aparte que la página invoca con Do, y queda fuera de las dos operaciones
Reescribir los bytes encontrados con ReplaceLoadedDocumentText
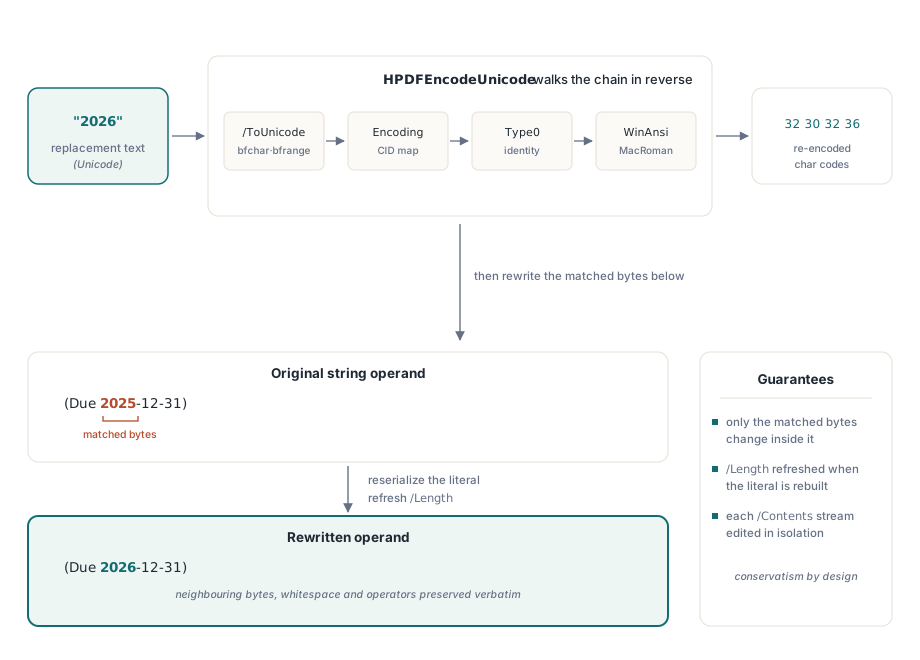
ReplaceLoadedPageText y ReplaceLoadedDocumentText reescriben cada aparición de una aguja recorriendo la decodificación de la fuente al revés. Cada carácter de reemplazo se busca por la misma cadena que usa el decodificador, pero en sentido inverso: entradas bfchar y bfrange de /ToUnicode, mapeos CID para fuentes Type0, mapeos de identidad, y las tablas predefinidas WinAnsi y MacRoman. Los códigos de carácter resultantes se escriben como cadena literal, o como cadena hexadecimal cuando algún byte cae fuera del ASCII imprimible, siguiendo las mismas reglas de escape que lee el parser del content stream
Solo cambian los bytes cubiertos por la coincidencia. Los bytes no encontrados dentro del mismo operando, el espacio en blanco entre tokens, los comentarios y todos los operadores alrededor pasan intactos. Reemplazar bca dentro de abcabc produce a + reemplazo + bc. El reemplazo puede ser más corto o más largo que la aguja, y cada stream del array /Contents de una página se procesa por su cuenta, así que la página sigue bien formada. Cuando una coincidencia se extiende por varios operandos de cadena, como Hello guardado como [(He) -20 (llo)] TJ, el reemplazo se escribe en el operando donde empieza la coincidencia y los bytes encontrados se quitan de los operandos siguientes
var
  Pdf: THotPDF;
  Rewrites: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('contract-draft.pdf') > 0 then
    begin
      if Pdf.ReplaceLoadedDocumentText('2025-12-31', '2026-12-31',
        True, Rewrites) then
        WriteLn(Format('%d operand rewrites', [Rewrites]));
      Pdf.SaveLoadedDocument('contract-final.pdf');
    end;
  finally
    Pdf.Free;
  end;
end;
La página no se recompone. El PDF no tiene reflow, así que un reemplazo más ancho que el original simplemente ocupa más sitio horizontal y puede chocar con lo que se pintó a su derecha; la posición del siguiente glifo la fijó el productor y no se mueve. Fechas, cadenas de versión, números de pieza y correcciones ortográficas de longitud parecida son el trabajo para el que está hecho este método. Reescribir un párrafo exigiría recomponer todo lo que viene después, así que ese cambio pertenece al documento fuente
¿Por qué un subconjunto de fuentes no puede poner caracteres que nunca contuvo?
Un carácter de reemplazo que el subconjunto incrustado nunca incluyó no tiene ningún código de carácter al que volver. Cuando un productor hace un subconjunto de una fuente, su CMap /ToUnicode y su codificación cubren solo los glifos que usó el documento original, y los contornos de glifo de todo lo demás simplemente no están en el fichero. Si el documento nunca imprimió una E mayúscula en esa fuente, no hay ninguna secuencia de bytes que la seleccione. Esa limitación está en el fichero, no en la herramienta que hace el reemplazo
ReplaceLoadedDocumentText trata un reemplazo no codificable de forma conservadora: si un solo carácter no puede recodificarse, esa aparición se salta entera. No hay excepción ni cadena medio reemplazada, y el texto original sigue legible. En el ejemplo de la fecha de arriba, el dígito 6 tiene que existir en alguna parte de esa misma fuente para que la reescritura tenga éxito. Supón que la fuente solo imprimió "2025" y unos totales de pedido sin ningún 6: las fechas se quedan como están
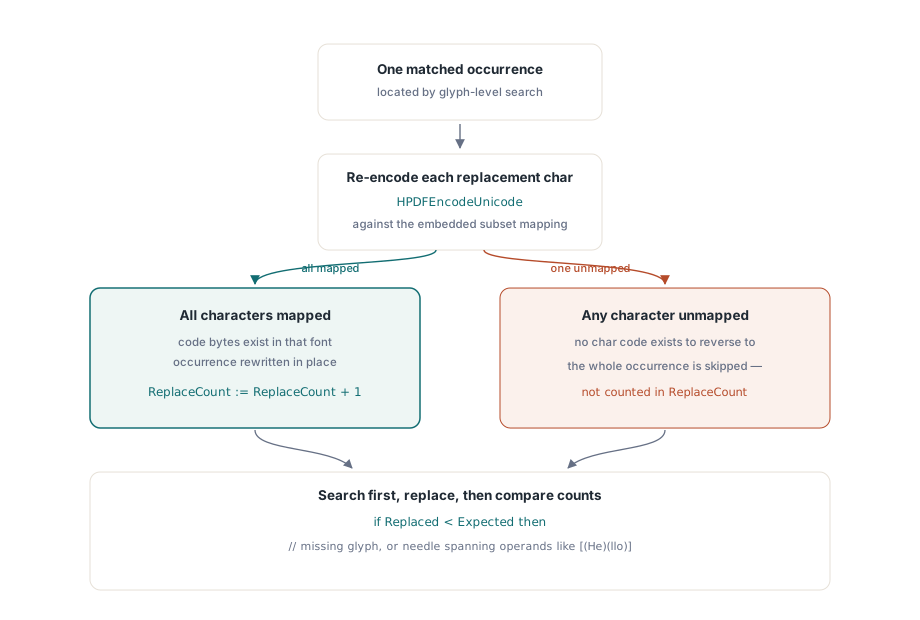
ReplaceCount reporta reescrituras de operandos, y una coincidencia repartida por varios operandos puede contabilizar más de una reescritura. Un conteo menor que el número de coincidencias sigue significando que algo se saltó, pero la respuesta exacta sale de buscar de nuevo tras el reemplazo. Lo que encuentre la segunda búsqueda es lo que se quedó atrás, con página y posición adjuntas
procedure ReplaceAndAudit(Pdf: THotPDF; const OldText, NewText: UnicodeString);
var
  Before, After: THPDFTextMatchArray;
  Rewrites, I: Integer;
begin
  // Volver a buscar solo funciona cuando NewText no contiene a su vez OldText
  Pdf.SearchLoadedDocumentText(OldText, True, Before);
  Pdf.ReplaceLoadedDocumentText(OldText, NewText, True, Rewrites);
  Pdf.SearchLoadedDocumentText(OldText, True, After);
  WriteLn(Format('%d found, %d operand rewrites, %d left',
    [Length(Before), Rewrites, Length(After)]));
  for I := 0 to High(After) do
    WriteLn(Format('  left on page %d at (%.1f, %.1f)',
      [After[I].PageIndex + 1, After[I].X, After[I].Y]));
end;
Cuando el subconjunto se queda corto: previsualizar y aplicar con una fuente nueva
Para las apariciones que el método a nivel de byte no puede codificar, PreviewLoadedPageTextReplacement y ApplyLoadedPageTextReplacement toman otra ruta: quitan los glifos encontrados y dibujan el reemplazo en su sitio con una fuente que tú eliges, al tamaño original y sobre la línea base original. Las THPDFLoadedTextReplacementOptions por defecto usan Arial al tamaño de fuente del texto encontrado, dimensionan la caja al ancho del texto encontrado y dejan Atomic activado. Con eso, una única coincidencia rechazada en la página hace rollback de las demás. La vista previa devuelve un plan con una entrada por coincidencia, cada una con su Status y, cuando se rechaza, un Reason
var
  Opts: THPDFLoadedTextReplacementOptions;
  Plan, Applied: THPDFLoadedTextReplacementPlan;
  I: Integer;
begin
  // Pdf es un THotPDF cargado; PageIndex es una página basada en cero que la auditoría marcó
  Opts := THPDFLoadedTextReplacementOptions.Default;
  Opts.Appearance.FontName := 'Arial';
  Opts.Appearance.OverflowPolicy := ltopShrinkToFit;
  Opts.Appearance.MinFontSize := 6;
  if not Pdf.PreviewLoadedPageTextReplacement(PageIndex, 'Acme Corp',
    'Apex Corporation', True, Opts, Plan) then
    for I := 0 to High(Plan.Results) do
      if Plan.Results[I].Status = ltrsRejected then
        WriteLn(Format('match %d at (%.1f, %.1f): %s',
          [I, Plan.Results[I].X, Plan.Results[I].Y, Plan.Results[I].Reason]));
  if (Plan.RejectedCount = 0) and (Plan.ReadyCount > 0) then
  begin
    Pdf.ApplyLoadedPageTextReplacement(Plan, Applied);
    WriteLn(Format('%d of %d matches applied',
      [Applied.AppliedCount, Applied.MatchedCount]));
  end;
end;
Los motivos de rechazo merecen imprimirse porque mapean directamente a la geometría de la página. Una coincidencia que salta de una línea de texto a la siguiente se rechaza, y el texto vertical también. Con la política de desbordamiento por defecto ltopReject, un reemplazo que no cabe en el ancho del texto encontrado también se rechaza. ltopShrinkToFit baja el tamaño escalonadamente hacia MinFontSize, que es por lo que el ejemplo lo fija para un reemplazo cinco caracteres más largo que la aguja. Un reemplazo que contenga caracteres que la fuente elegida no pueda mostrar también se rechaza
El plan lleva una huella del contenido de la página y de sus fuentes. Si algo cambia la página entre la vista previa y la aplicación, ApplyLoadedPageTextReplacement eleva EInvalidOpException en lugar de escribir en una página que la vista previa nunca vio. Las páginas con parejas q/Q o BT/ET desequilibradas, y los documentos que contienen campos de firma, elevan EArgumentException; los documentos firmados piden actualizaciones incrementales para que la revisión firmada siga intacta
El reemplazo a nivel de byte va primero, y la ruta de cambio de fuente solo corre en las páginas donde la auditoría todavía encuentra el texto antiguo. La reescritura a nivel de byte conserva la fuente original, sus métricas y su kerning, así que el texto editado encaja con sus vecinos de línea. La ruta de vista previa dibuja en un tipo de letra distinto, y en una línea compuesta en una fuente condensada o con serifa un lector atento notará el cambio. Cuando el objetivo es hacer desaparecer texto en lugar de reformularlo, la eliminación real de contenido es la mejor herramienta; redactar y reestructurar PDFs cargados en Delphi cubre ese camino
Qué cambia en el fichero guardado
Un content stream editado por ReplaceLoadedPageText se guarda sin comprimir. El stream se decodifica para editar y, cuando los bytes reconstruidos se escriben de vuelta, sus entradas /Filter y /DecodeParms se descartan y el /Length se refresca. El PDF es válido y se renderiza con normalidad; el coste es un fichero mayor para cada stream editado. Un trabajo por lotes sobre miles de facturas debería presupuestar ese crecimiento o ejecutar después una pasada de compresión
La ruta de vista previa y aplicación cambia algo más. Una página aplicada recibe un único stream de contenido nuevo sin comprimir en lugar de su /Contents original, más su propia copia del diccionario de recursos con la fuente de reemplazo añadida. Todo lo demás del documento se deja tranquilo: los streams intactos conservan su compresión, las fuentes e imágenes existentes no se reescriben, y las páginas sin coincidencias nunca se abren para escritura. Cómo aterrizan los objetos reescritos en la estructura de referencias cruzadas al guardar está tratado en object streams y actualizaciones incrementales en HotPDF
Búsqueda, reemplazo a nivel de byte, reemplazo con vista previa y aplicación, extracción y redacción corren todos sobre el mismo intérprete de content streams, desde Delphi 5 hasta el RAD Studio actual, sin dependencias externas. Las referencias de métodos, las opciones de reemplazo y una build de prueba están en la página de producto del HotPDF Delphi Component