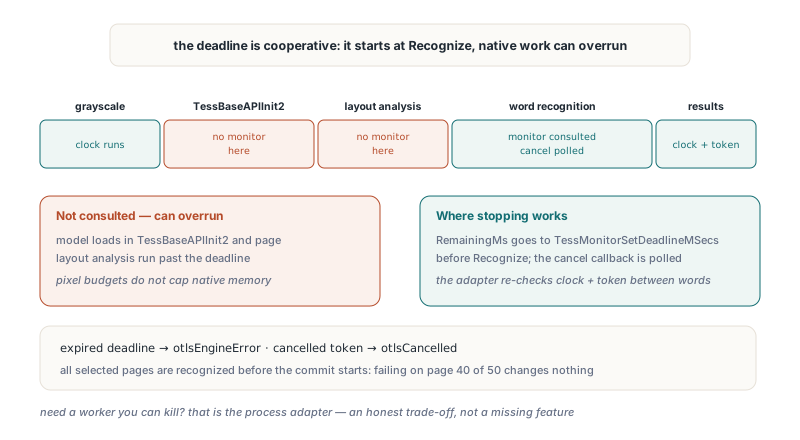
行程內 Tesseract 呼叫設定 5,000 ms 辨識逾時,不代表呼叫五秒後就會回來。模型組又大又多語言時,呼叫執行緒可能遠遠超過那個時刻還留在原生程式庫裡:強制執行期限的進度監視器是在詞辨識期間被輪詢的,而模型載入與頁面版面分析都發生在第一次輪詢之前。這段空檔、取消回呼的 C 回傳型別只有一個位元組這件事,以及一個交出您絕不能釋放的記憶體的迭代器,才是把 Tesseract C API 綁進 Delphi 的真正功夫;其餘都是管道工程
把 Tesseract DLL 接進 HotPDF 文字層
HotPDF 把行程內路徑暴露為 HPDFTesseractRecognition 單元裡的 HPDFCreateTesseractDLLOCREngine。工廠載入一支匯出 C API 的 Tesseract DLL,驅動 TessBaseAPIInit2、TessBaseAPIRecognize 與結果迭代器,回傳一個 IHPDFOCREngine。THotPDF.ApplyLoadedOCRTextLayer 收下這顆引擎,為掃描頁加上隱形、可搜尋的 Unicode 文字層——每種 HotPDF OCR 引擎走的都是同一個呼叫
工廠急切驗證。DLL 檔與 tessdata 目錄必須存在。語言識別碼只能含 ASCII 字母、數字、_ 與 +,chi_sim+eng 這種組合裡的每個模型都要有對應的 .traineddata 檔。21 個必要 export 全部解析得到,您才拿得到引擎。設定錯誤丟 EArgumentException,缺哪個 export 或模型指名道姓;載不起來的 DLL 丟 EOSError,帶著 Windows 錯誤碼,並提示檢查架構與相依套件
uses
  SysUtils, HPDFDoc, HPDFTesseractRecognition;

procedure MakeSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // Win64 應用程式需要 64 位元 DLL;檔名依您的建置而定,
  // 相依 DLL 放在同一個資料夾
  Engine := HPDFCreateTesseractDLLOCREngine('C:\OCR\Win64\libtesseract.dll',
    'C:\OCR\tessdata', 'chi_sim+eng');   // 使用 THPDFTesseractOptions.Default
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default;   // 300 DPI、MinimumConfidence 0.5
    // 空頁面清單代表每一頁;已有文字的頁面會跳過
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' words accepted, ', Info.DroppedWordCount, ' dropped');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;
THPDFTesseractOptions.Default 把 PageSegMode 設成 tpsAuto、EngineMode 設成 temDefault、TimeoutMilliseconds 設成 60,000、MaxPixels 設成 16,777,216。像素預算比大家預期的更早咬人:US Letter 頁在預設 300 DPI 渲染出 2,550 × 3,300 像素、約 840 萬,裝得下。把同一頁拉到 600 DPI:變成 5,100 × 6,600、約 3,370 萬像素,引擎在 Tesseract 看到影像之前就以 Invalid Tesseract DLL OCR request or pixel budget 拒收。要嘛調高 MaxPixels(上限 67,108,864),要嘛留在 300 DPI——對內文來說綽綽有餘;單邊另有 32,767 像素上限
DLL 用 LoadLibraryEx 與涵蓋 DLL 自身資料夾加預設安全目錄的搜尋旗標載入。Tesseract 相依的影像程式庫因此可以放在它旁邊,您不必碰 PATH、也不必依賴目前目錄。HotPDF 不捆綁、也不下載 OCR runtime 或任何語言模型;兩者都由您備妥
跟 tesseract.exe 相比,DLL 路徑改變了什麼
同一個辨識器也能透過寫 BMP、解析 TSV 的外接 tesseract.exe 配接器用到。兩種配接器餵的是同一條文字層管線,座標映射、信賴度過濾與全有全無提交的行為完全相同。不同的是像素怎麼進去、詞怎麼出來,以及辨識器行為失常時會發生什麼
| 面向 | tesseract.exe 配接器 | Tesseract DLL 配接器 |
|---|---|---|
| 工廠函式 | HPDFCreateTesseractOCREngine | HPDFCreateTesseractDLLOCREngine |
| 像素進入 | 私有暫存目錄裡的 BMP 檔 | 記憶體中的 8-bit 灰階緩衝區 |
| 詞輸出 | 詞級 TSV,上限 64 MiB | 結果迭代器,每詞 UTF-8 |
| 基線 | TSV 裡沒有;由管線估計 | 從 TessPageIteratorBaseline 直接傳出 |
| 頁面分割與引擎模式 | THPDFTesseractOptions 多載版,以 --psm 與 --oem 傳送 | THPDFTesseractOptions,送給 TessBaseAPISetPageSegMode 與 TessBaseAPIInit2 |
| 像素預算 | 有傳選項時套用 MaxPixels | 永遠套用 MaxPixels,外加單邊 32,767 像素 |
| 逾時 | 硬性:子行程被終止 | 合作式:Tesseract 必須自己察覺 |
| 崩潰與記憶體隔離 | 獨立行程 | 無,共享您的位址空間 |
有一項成本留在 DLL 身上。每筆 Recognize 呼叫都建立自己的 API 實體、跑一次 TessBaseAPIInit2,語言模型每頁初始化一次。檔案快取能緩解重載,但模型組又大又多語言時,它仍是每頁最大的固定成本,而且計入辨識期限。行程內 RapidOCR DLL 引擎做了相反的選擇,ONNX 模型在引擎終生常駐;那些邊界問題(C ABI、借用緩衝區、中斷不了的原生工作)則屬於同一家族
那生產環境該選哪個?桌面工具或只跑幾百份掃描件的批次作業,DLL 更合適:每頁不用起行程、磁碟上不留暫存點陣圖,歪斜的行還有真正的 baseline。接收陌生人 PDF 的長跑伺服器該留在 tesseract.exe:原生崩潰或失控配置在那裡只帶走一個子行程,而不是您的服務
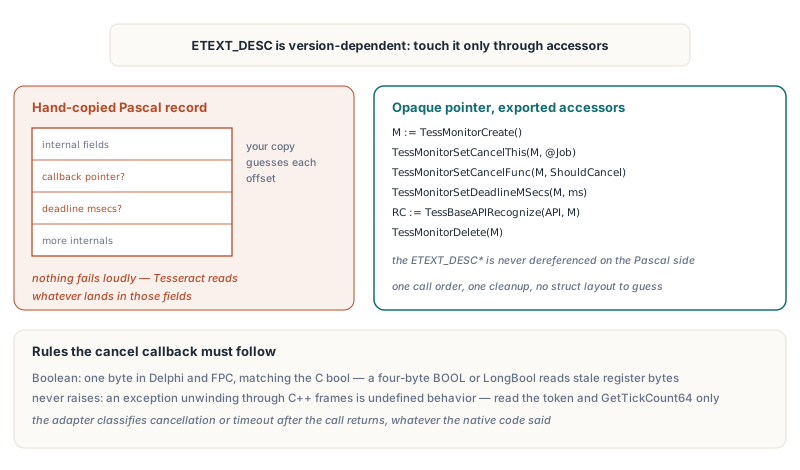
為什麼 Delphi 不能照抄 Tesseract 的 monitor 結構?
Delphi 無法安全鏡像 Tesseract 的進度監視器,因為 ETEXT_DESC 帶著會隨 Tesseract 建置而變動的內部欄位。照某一份標頭手工翻譯出來的記錄,把取消回呼與期限放在那份標頭恰好使用的偏移上;拿去對另一個建置跑,Tesseract 會從一個現在代表別的東西的欄位裡讀您的回呼指標,或根本找不到期限,辨識就一路跑到底
所以 HotPDF 配接器把 monitor 當不透明指標,只透過匯出函式碰它:TessMonitorCreate、TessMonitorSetCancelThis、TessMonitorSetCancelFunc、TessMonitorSetDeadlineMSecs 與 TessMonitorDelete。下面的草圖是您自己的綁定程式碼、不是 HotPDF API;它的宣告與配接器用 GetProcAddress 解析的一致
type
  // C: typedef bool (*TessCancelFunc)(void *cancel_this, int words);
  TTessCancelFunc = function(CancelThis: Pointer; Words: Integer): Boolean; cdecl;
  TTessMonitorCreate = function: Pointer; cdecl;   // ETEXT_DESC*,永不解參照
  TTessMonitorDelete = procedure(Monitor: Pointer); cdecl;
  TTessMonitorSetCancelFunc = procedure(Monitor: Pointer; Func: TTessCancelFunc); cdecl;
  TTessMonitorSetCancelThis = procedure(Monitor, CancelThis: Pointer); cdecl;
  TTessMonitorSetDeadlineMSecs = procedure(Monitor: Pointer; MSecs: Integer); cdecl;
  TTessBaseAPIRecognize = function(Handle, Monitor: Pointer): Integer; cdecl;

  // 您自己的作業狀態,不是 HotPDF 型別
  TOCRJob = record
    CancelRequested: Boolean;
    DeadlineTick: UInt64;
  end;
  POCRJob = ^TOCRJob;

function ShouldCancel(CancelThis: Pointer; Words: Integer): Boolean; cdecl;
begin
  // 跑在 Tesseract 的堆疊上:只讀旗標與時鐘,絕不丟例外
  Result := (CancelThis = nil) or POCRJob(CancelThis)^.CancelRequested or
    (GetTickCount64 >= POCRJob(CancelThis)^.DeadlineTick);
end;

// 用法,函式指標經 GetProcAddress 解析:
//   Monitor := MonitorCreate();
//   try
//     MonitorSetCancelThis(Monitor, @Job);
//     MonitorSetCancelFunc(Monitor, ShouldCancel);
//     MonitorSetDeadlineMSecs(Monitor, RemainingMs);
//     RC := BaseAPIRecognize(API, Monitor);
//   finally
//     MonitorDelete(Monitor);
//   end;
草圖把回呼型別定為 Boolean——在 Delphi 與 Free Pascal 都是一個位元組,對上 TessCancelFunc 裡的 C bool。四位元組的 Windows BOOL 與 Delphi LongBool 看似可互換,其實是不同型別:一邊寫一個位元組、另一邊讀四個,上方三個位元組是暫存器先前的殘值,false 可能以 true 的身分抵達。TessPageIteratorBoundingBox 回傳 int,Pascal 側宣告成 Integer——逐個回傳值讀 C 型別,別替整個 API 假設一條規則
回呼也絕不丟例外。Delphi 例外穿過 Tesseract 的 C++ 堆疊框架展開,是未定義行為。HotPDF 的回呼只讀取消權杖與單調遞增的 GetTickCount64 值,配接器在 TessBaseAPIRecognize 返回之後,把結果轉成取消或逾時診斷。原生回傳碼是不是 0,這項檢查照跑
Delphi 這一側擁有哪些原生指標?
HotPDF 的 Tesseract DLL 配接器每筆請求擁有三個原生物件(API 實例、monitor、結果迭代器),其餘全是借的。每筆 Recognize 呼叫建立自己的一組,並在 finally 區塊裡按固定順序釋放:TessResultIteratorDelete,然後 TessMonitorDelete,然後 TessBaseAPIDelete。釋放引擎介面時對 DLL 呼叫 FreeLibrary
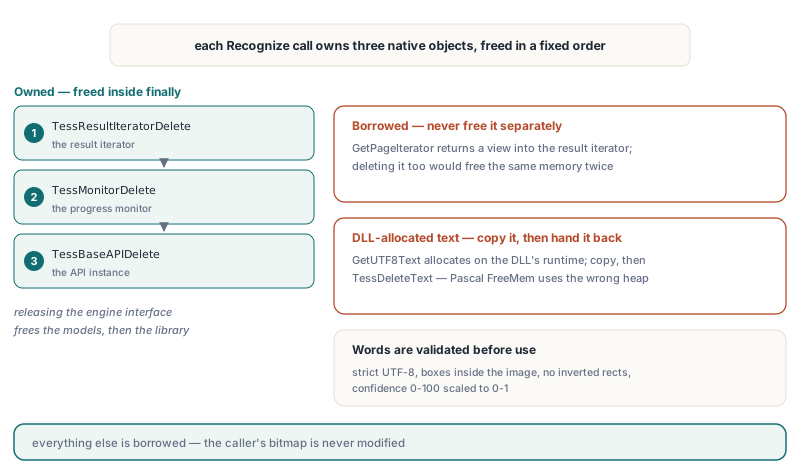
TessResultIteratorGetPageIterator回傳的是指向結果迭代器的視圖、不是新物件。配接器用它做TessPageIteratorBoundingBox與TessPageIteratorBaseline,絕不釋放;把它也刪掉會把同一塊記憶體釋放兩次TessResultIteratorGetUTF8Text回傳的字串由 DLL 自己的 runtime 配置。配接器解碼後在finally區塊裡經TessDeleteText歸還,因為 Pascal 的FreeMem會在錯的堆積上釋放- 詞文字先過帶長度檢查的嚴格 UTF-8 解碼。含控制字元、畸形 UTF-8、框落在影像外、矩形反轉或信賴度落在 0–100 之外的詞,一律讓請求失敗;配接器不修補
- 每筆請求的文字上限 1,048,576 個 UTF-16 code units,詞數也必須塞得進
ApplyLoadedOCRTextLayer隨每頁下發的預算
信賴度以 0–100 抵達、縮放到 0–1,所以 THPDFOCRTextLayerOptions.MinimumConfidence 對每種引擎都是同一個意思。Tesseract 有報 baseline 時,兩個端點直接傳出;文字以垂直為主的詞,改拿框寬當文字高度。沒有 baseline 時,文字層管線後備到幾何估計——跟 TSV 輸入的做法一模一樣
列舉選項在進 DLL 之前先做範圍檢查
工廠把 PageSegMode 與 EngineMode 的原始位元組複製進 Integer 之後才做範圍檢查。編譯器有權假設列舉變數永遠持有已宣告的值,直接對列舉寫 Ord(X) > Ord(High(T)) 這種測試,可能被摺疊成常數 false。這些序數以普通整數的身分進 DLL:THPDFTesseractPageSegMode 沿用 Tesseract 0 到 13 的頁面分割編號,THPDFTesseractEngineMode 沿用 0 到 3 的引擎模式編號。用 FillChar 清過、從串流讀入、或從 C++Builder 經整數轉型填入的選項記錄,都可能帶著 200 這種位元組;對複本驗證,就能把它變成工廠階段的 EArgumentException。工廠也拒收不會回傳詞的 tpsOSDOnly 與 tpsAutoOnly,並要求 tpsAutoOSD 與 tpsSparseTextOSD 配 osd.traineddata
辨識逾時實際上保證什麼?
Tesseract DLL 逾時是合作式的:HotPDF 能停掉自己的工作、請 Tesseract 也停,但無法強迫原生程式碼返回。時鐘從 Recognize 開跑起算,灰階轉換與模型初始化跟辨識本身共用同一筆預算。配接器在灰階轉換期間每 64 列、初始化之後、走訪結果時每個詞之前,各查一次經過時間與取消權杖。就在 TessBaseAPIRecognize 之前,它把剩餘毫秒交給 TessMonitorSetDeadlineMSecs
空檔藏在原生呼叫裡。Tesseract 只在詞辨識期間徵詢 monitor,所以 TessBaseAPIInit2 或頁面版面分析期間,慢的模型載入或病態版面可能先跑過期限、逾時才被回報。像素與輸出預算也管不到原生程式庫自己的記憶體用量。需要一個殺得乾脆的 worker 時,行程配接器才是那個工具
頁面分割是 DLL 配接器在彆扭輸入上回本的地方。欄位四散的表單、標籤與掃描表格,用 tpsSparseText 常常比自動分割辨識得更好——後者會去拼出不存在的欄與段。下面這個逾時對表單頁來說很短,卻仍得涵蓋模型初始化
procedure OCRFormPages(Doc: THotPDF; const Pages: array of Integer);
var
  Engine: IHPDFOCREngine;
  TessOptions: THPDFTesseractOptions;
  LayerOptions: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  TessOptions := THPDFTesseractOptions.Default;
  TessOptions.PageSegMode := tpsSparseText;  // 欄位四散,不拼欄
  TessOptions.EngineMode := temLSTMOnly;     // tessdata 裡要有 LSTM 模型
  TessOptions.TimeoutMilliseconds := 20000;  // 含模型初始化
  Engine := HPDFCreateTesseractDLLOCREngine('C:\OCR\Win64\libtesseract.dll',
    'C:\OCR\tessdata', 'eng+deu', TessOptions);

  LayerOptions := THPDFOCRTextLayerOptions.Default;
  LayerOptions.MinimumConfidence := 0.6;
  if not Doc.ApplyLoadedOCRTextLayer(Pages, Engine, LayerOptions, Info) then
    case Info.Status of
      otlsCancelled:
        Writeln('OCR cancelled, document unchanged');
      otlsEngineError:
        if Pos('timed out', string(Info.Diagnostic)) > 0 then
          Writeln('Tesseract timed out, document unchanged')
        else
          Writeln('Tesseract failed: ', string(Info.Diagnostic));
    else
      Writeln(string(Info.Diagnostic));
    end;
end;
逾時以 otlsEngineError 浮現,診斷訊息帶 Tesseract DLL OCR timed out;經 THPDFOCRTextLayerOptions.CancellationToken 設定的權杖以 otlsCancelled 浮現。兩種情況裡,ApplyLoadedOCRTextLayer 都先辨識完所有選中的頁、才開始提交,所以 50 頁裡第 40 頁失敗,已載入的文件原封不動。tpsSingleLine、tpsSingleBlock 與 tpsSparseText 只改分割;沒有一個能把歪的掃描件扶正
Free Pascal 與 Lazarus:過期像素與消失的中文
兩種 Tesseract 工廠都能在 Windows 版 Free Pascal 與 Lazarus 的 Win32 與 Win64 建置裡工作,前提是 Lazarus 套件已針對目標架構重建;一般移植見 HotPDF on Free Pascal and Lazarus Win64。輸入處理才是 FPC 行為不同的地方
透過 scanline 寫入的 LCL TBitmap,可能更新了原始影像卻沒重新整理 Windows 點陣圖 handle,對那個 handle 呼叫 GetDIBits 拿回的是舊像素。症狀很迷惑:直接畫到點陣圖上的文字辨識得到,經 scanline 渲染的頁面一個詞都沒有。FPC 之下,DLL 配接器改經 CreateIntfImage 讀取懂格式的快照——它尊重原始影像的像素格式與行序。Delphi 建置在私有的 24-bit 複本上保留 GetDIBits 路徑;兩種建置都不改呼叫方的點陣圖
tesseract.exe 配接器碰到的則是另一個問題。FPC 的 TStringList 存 ANSI 字串,把解碼後的 UTF-8 TSV 文字塞給 Lines.Text,系統 ANSI 代碼頁無法表示的中文或補充平面字元全部丟失。FPC 路徑把 TSV 當 UTF-8 位元組保留、在位元組層去掉 BOM、自行把每個詞解碼成 UnicodeString。DLL 配接器碰不到這問題,因為它直接從迭代器解碼每個詞
Tesseract DLL 配接器與行程配接器、內建 OCR 引擎一起隨 HotPDF 出貨,支援 Delphi、C++Builder 與 Free Pascal。版本與下載見 HotPDF Delphi PDF component 頁面