一條永遠不回報檔案結尾的 pipe,是 OCR 功能裡很刁鑽的追兇對象。您應用程式裡的一個執行緒讀著輔助程式的標準輸出、等 ReadFile 以 ERROR_BROKEN_PIPE 失敗;另一個執行緒用 CreateProcess、把 bInheritHandles 設成 True 啟動 tesseract.exe——因為要給子行程一個檔案當標準錯誤輸出,就得這麼做。輔助程式的 pipe 寫入端是可繼承的,於是 Tesseract 現在也握有一份副本,讀取執行緒一路掛到 Tesseract 跑完那一頁 — 而 300 DPI、載了兩套語言模型的掃描件,這可快不了
外接辨識器帶來的不只是這個掛死:子行程看得到什麼、半有效的輸出怎麼辦、像素框怎麼變成可搜尋的 PDF 文字。內建樣板比對 OCR 引擎刻意只覆蓋機器印刷的 ASCII 字母與數字;帶音調符號的名字、中文合約、混語言的檔案庫需要訓練過的語言模型,而 Tesseract 是常見的候選——它是個命令列程式,裝在您的執行檔旁邊就行
把 Tesseract 接進 HotPDF OCR 文字層
HotPDF 把本機安裝的 Tesseract 執行檔包成 IHPDFOCREngine——透過 HPDFTesseractRecognition 單元裡的 HPDFCreateTesseractOCREngine。把這顆引擎交給 THotPDF.ApplyLoadedOCRTextLayer:它渲染每個請求的頁面、每頁跑一次 Tesseract、過濾詞,然後在一個交易裡為所有請求的頁面寫入隱形 Unicode 文字層——否則一頁都不寫。座標映射、旋轉、信賴度過濾與提交,都是內建引擎已經在用的那條管線;改變的只有辨識本身
工廠在任何頁面被碰之前就丟 EArgumentException。執行檔與 tessdata 目錄必須存在;逾時必須落在 1 到 3,600,000 毫秒之間;語言只能含 ASCII 字母、數字、_ 與 +——它最終會上命令列,eng+chi_sim 是合法的,帶引號或空格的值是等著發生的注入。第二個多載收一份 THPDFTesseractOptions 記錄:它的 Default 給 --psm 3、--oem 3、每頁 60 秒與 16,777,216 像素上限,並拒收不會回傳詞的 tpsOSDOnly 與 tpsAutoOnly
uses
  SysUtils, HPDFTypes, HPDFDoc, HPDFTesseractRecognition;

function MakeSearchable(const SourceFile, TargetFile: string;
  Token: THPDFCancellationToken): Boolean;
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  TessOptions: THPDFTesseractOptions;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  TessOptions := THPDFTesseractOptions.Default; // psm 3、oem 3、60 秒、16,777,216 px
  TessOptions.TimeoutMilliseconds := 120000;    // 作用於每一頁
  // 執行檔或 tessdata 資料夾缺失、語言識別碼不合法、或選項超出範圍時,
  // 丟 EArgumentException
  Engine := HPDFCreateTesseractOCREngine(
    'C:\OCR\Tesseract\tesseract.exe',
    'C:\OCR\Tesseract\tessdata',
    'eng+chi_sim',                              // 多個模型以 '+' 相接
    TessOptions);
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default; // 300 DPI、MinimumConfidence 0.5
    Options.CancellationToken := Token;
    // 空頁面清單代表每一頁;已有文字的頁面會跳過
    Result := Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info);
    if Result then
    begin
      Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
        ' words kept, ', Info.DroppedWordCount, ' below the threshold');
      Doc.SaveLoadedDocument(TargetFile);
    end
    else
      case Info.Status of
        otlsCancelled:      Writeln('Cancelled, document unchanged');
        otlsEngineError:    Writeln('Engine: ', string(Info.Diagnostic));
        otlsBudgetExceeded: Writeln('Budget: ', string(Info.Diagnostic));
      else
        Writeln(string(Info.Diagnostic));
      end;
  finally
    Doc.Free;
  end;
end;
像素算術一次算清。A4 在 300 DPI 約 2,481 × 3,508 像素、將近 870 萬,裝得下;同解析度的 A3 約 3,508 × 4,961、接近 1,740 萬,會帶著像素預算診斷失敗,整個執行以 otlsEngineError 收場。只收逾時參數的那個多載完全不做像素上限。會接收外部檔案的服務,請用選項多載,預期會遇到大格式時,刻意調高 MaxPixels(上限 67,108,864)或調低 THPDFOCRTextLayerOptions.DPI
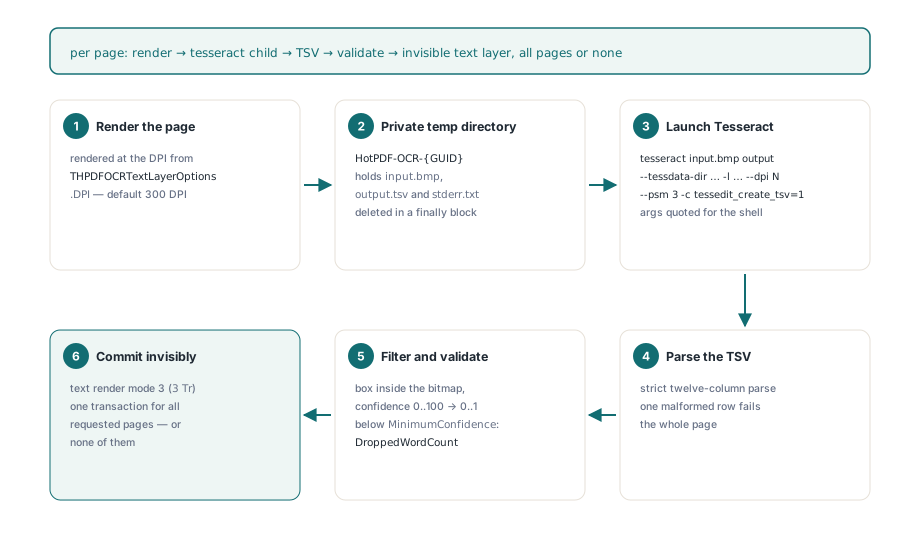
每一頁,引擎在暫存路徑下建一個私有的 HotPDF-OCR-{GUID} 目錄、把點陣圖存成 input.bmp、跑 tesseract input.bmp output --tessdata-dir … -l … --dpi N --psm 3 -c tessedit_create_tsv=1,設了引擎模式再加 --oem。路徑按 Windows 處理反斜線與內嵌引號的規則加引號,--dpi 帶上渲染解析度,Tesseract 不用猜。Tesseract 與它的 .traineddata 檔不捆綁;備妥它們是應用程式的事。在我們自己的 Linux 測試機上,辨識器從使用者層級的套裝執行——二進位、共用程式庫閉包與 tessdata 資料夾打包在一起——因為依賴 /usr/bin/tesseract 只在有人裝過系統套件的地方行得通
為什麼一行壞掉的 TSV 列會清空整頁?
Tesseract 配接器在第一行畸形列上就讓整頁失敗:解析到一半的詞清單,會產出與影像對不上帳的文字層,而存出來的 PDF 裡沒有任何東西說明哪些詞消失了。輸出必須是無內嵌 NUL 的嚴格 UTF-8;去掉可選的位元組順序記號後,第一行必須等於 Tesseract 的十二欄表頭——從 level 到 text。每一列必須切成恰好十二個欄位,切分在第十一個 tab 之後停止,所以辨識文字裡的 tab 會落進 text 欄、而不是造出第十三欄——那會被下面的控制字元檢查拒收
只有 level 5 的列是詞;頁、塊、段、行列出一律跳過,空的或純空白的詞也一樣。含控制字元(低於 U+0020,或 U+007F 到 U+009F)的詞讓整頁失敗。其餘欄位要整數幾何、以不變格式解析的信賴度——德文地區設定的應用程式照樣讀得懂 93.5、完全落在點陣圖內的框,以及 0 到 100 的信賴度。一個合法詞後面跟一行壞列,結果是零個詞
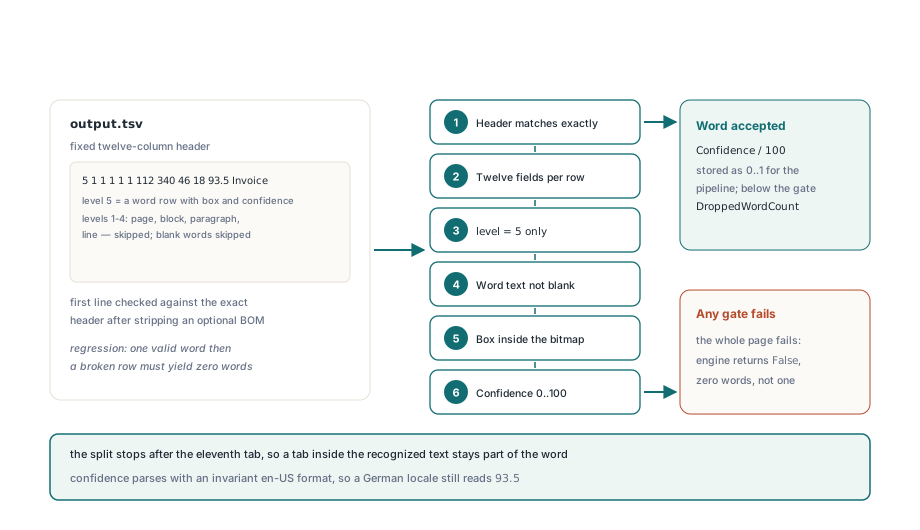
所以一行不對的列讓整個執行失敗、每一頁原封不動。這是對的取捨:重跑很便宜;而一份「搜尋發票編號偏偏漏掉最重要的那一頁」的可搜尋 PDF,往往幾個月後才在別人手裡浮上檯面
最後一步還會撞上一個您可能沒預期的預設。Tesseract 的信賴度是 0 到 100,管線除以 100,THPDFOCRTextLayerOptions.MinimumConfidence 預設 0.5——低於 50 的詞全部進 Info.DroppedWordCount、上不了頁面。乾淨的掃描件上這道地板合理;充滿雜訊的傳真上它可能吃掉大半文字,調低之前先比對 Info.ReceivedWordCount 與 Info.AcceptedWordCount
對已有文字的檔案再跑一次 OCR
SkipPagesWithText 預設為 True,第二次跑的人就會撞上它。假設一批檔案先前用 eng 處理過、現在要 eng+deu:每頁都已帶著隱形文字,Info.SkippedPageCount 會等於頁數。HotPDF 把自己寫的內容串流標記為自家的 OCR 層,ReplaceExistingOCRTextLayer 靠這個標記重新辨識那些頁面——丟掉舊層、保留原始頁面內容
Options := THPDFOCRTextLayerOptions.Default;
Options.ReplaceExistingOCRTextLayer := True;  // 換掉我們先前寫的層
Options.UseOptionalContentGroup := True;      // 層名為 'OCR Text Layer'
Options.CancellationToken := Token;
if Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
  Writeln(Info.ReplacedPageCount, ' replaced, ',
    Info.SkippedPageCount, ' skipped, ',
    Info.RecognizedPageCount, ' recognized')
else
  Writeln(string(Info.Diagnostic));
掃描器驅動程式 OCR 過的檔案沒有這種標記,它的頁面照樣算「有文字的頁」。把 SkipPagesWithText 關掉,等於在第一層上面再疊一層隱形文字,每個搜尋命中都出現兩次。那些檔案別動
Tesseract 行程繼承哪些 handle?
Tesseract 子行程從 HotPDF 只繼承兩個 handle:一個開在 NUL 上、供標準輸入與輸出,一個開向私有目錄裡的 stderr.txt。開頭那個 pipe 掛死來自 CreateProcess 本身:要傳標準 handle 就必須 bInheritHandles = True,而它光是這樣就會把宿主行程裡每個可繼承的 handle——包括不相關程式碼開的 pipe、檔案與事件——全部交出去。HotPDF 用 STARTUPINFOEX 加一個帶 PROC_THREAD_ATTRIBUTE_HANDLE_LIST 的屬性清單與 EXTENDED_STARTUPINFO_PRESENT 旗標:bInheritHandles 仍是 True,但只有清單上的 handle 過得去
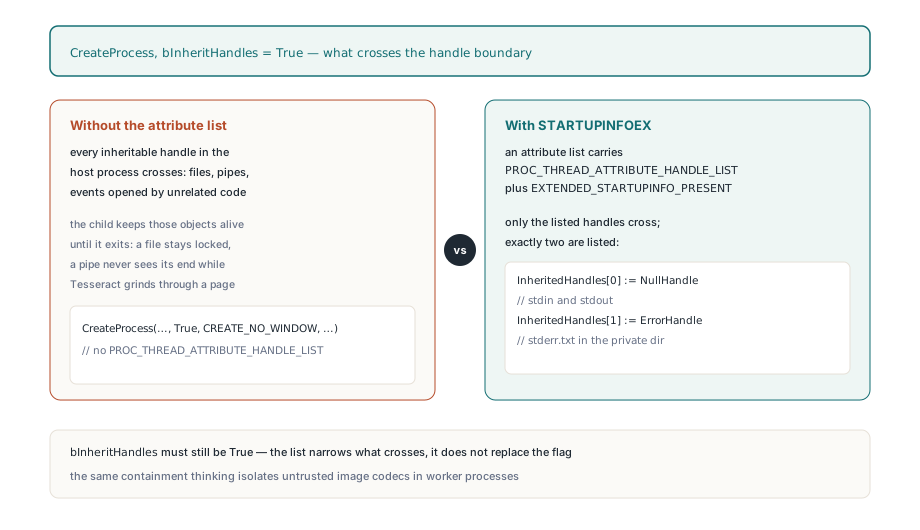
同樣的模式應該進入您應用程式啟動的每一個其他子行程——一個什麼都繼承的啟動器,就足以掛死行程裡每一個 pipe 讀取端:
// 給您自己 CreateProcess 呼叫的範式(片段:NullHandle、ErrorHandle、
// Exe、CommandLine、WorkDir 與 ProcessInfo 在別處宣告)。
// 較舊的 Delphi RTL 不宣告屬性清單函式;編譯器找不到時,
// 自行從 kernel32 加 external 宣告
// 正式程式碼裡請檢查每個 BOOL 回傳值
type
  TStartupInfoExRec = record
    StartupInfo: TStartupInfo;
    AttributeList: Pointer;
  end;
const
  HANDLE_LIST_ATTRIBUTE = $00020002;   // PROC_THREAD_ATTRIBUTE_HANDLE_LIST
  EXTENDED_STARTUP_FLAG = $00080000;   // EXTENDED_STARTUPINFO_PRESENT
var
  Startup: TStartupInfoExRec;
  HandleList: array[0..1] of THandle;
  Size: NativeUInt;
begin
  FillChar(Startup, SizeOf(Startup), 0);
  HandleList[0] := NullHandle;         // 以 bInheritHandle = True 建立
  HandleList[1] := ErrorHandle;        // 同上
  Size := 0;
  InitializeProcThreadAttributeList(nil, 1, 0, Size);
  GetMem(Startup.AttributeList, Size);
  InitializeProcThreadAttributeList(Startup.AttributeList, 1, 0, Size);
  UpdateProcThreadAttribute(Startup.AttributeList, 0, HANDLE_LIST_ATTRIBUTE,
    @HandleList[0], SizeOf(HandleList), nil, nil);
  Startup.StartupInfo.cb := SizeOf(Startup);
  // ……照常設定 dwFlags 與 hStdInput / hStdOutput / hStdError ……
  CreateProcess(PChar(Exe), PChar(CommandLine), nil, nil,
    True,                              // 有 handle 清單時仍然必須
    CREATE_NO_WINDOW or EXTENDED_STARTUP_FLAG,
    nil, PChar(WorkDir), Startup.StartupInfo, ProcessInfo);
  // 子行程結束後:DeleteProcThreadAttributeList、FreeMem、CloseHandle
end;
橋接腳本還多一個 Windows 細節。Python launcher 可以再起一個直譯器行程,而終止您建立的那個行程,留下來的是它。當引擎拿到的是腳本路徑——下文的 RapidOCR 配接器就是——HotPDF 先以掛起狀態啟動子行程、把它放進帶 JOB_OBJECT_LIMIT_KILL_ON_JOB_CLOSE 的 job object、然後恢復執行:關掉 job,整棵行程樹一起結束。同樣的圍堵思路驅動著在 worker 行程裡隔離 PDF 影像編解碼器——那裡的子行程不可信;這裡的子行程可信,但握著它裡面 handle 的不止您的行程
取消、逾時與全有全無的提交
IHPDFOCREngine.Recognize 只回傳一個布林值,False 同時涵蓋「Tesseract 失敗」與「使用者按了取消」。Tesseract 執行期間,配接器每 25 毫秒輪詢權杖與逾時,取消時清理現場、回傳 False。照字面理解這會被讀成 otlsEngineError,所以 Recognize 回傳 False 時,ApplyLoadedOCRTextLayer 先查權杖。每個請求頁面的辨識與內容建構都在文件交易開啟之前完成,所以 50 頁裡第 40 頁取消,回報的是 otlsCancelled、50 頁全部維持載入時的樣子。其餘限制同一風格:
- 逾時從每筆
Recognize呼叫開頭起算,所以 60,000 ms 預設是每頁上限 - 逾時或取消當下還在跑的子行程被終止、最多等 5 秒;私有目錄在
finally區塊裡刪除,刪除最多重試一秒——行程結束後輸出檔案可能短暫被鎖 output.tsv上限 64 MiB、stderr.txt上限 1 MiB,子行程執行中與結束後都檢查- 每頁的詞數與 UTF-16 code units 受
MaxWordsPerPage、MaxTotalWords與MaxTextCodeUnits的剩餘額度約束;超過就讓整個執行失敗,而不是把清單砍半 - 非零結束碼連同
stderr.txt的至多 4,096 字元一起回來——得知某個.traineddata檔缺失的最快途徑
頁面裡的隱形文字層長什麼樣
HotPDF 以文字渲染模式 3 寫詞——不填充也不描邊(ISO 32000-1 §9.3.6)——掃描影像保持可見,搜尋與複製則作用在詞上。內容串流以 3 Tr 開 BT;每個詞拿到基線上的 Tm 矩陣、以框高像素乘 72 除以渲染 DPI 的字型大小,以及把字串拉到框寬的 Tz 縮放。這個拉伸讓搜尋高亮正好落在影像裡那個詞上
TSV 有框、沒有基線,所以每條基線放在框底緣上方五分之一框高處。拉丁或西里爾這類以空格分詞的文字裡,左右相鄰的詞之間由拉伸的空格補滿空隙,複製出來的文字保留分詞;中文沒有。字形經由共享、不內嵌的 Type0 字型輸出,Identity-H 編碼加生成的 ToUnicode CMap,每個不同的 Unicode 純量一個 CID——中文、帶音調的拉丁字母與補充平面字元因此都活過複製與搜尋。一次 run 至多 65,535 個不同純量;ISO 19005 要求字型內嵌,所以 PDF/A 輸出需要另外內嵌合規字型。要檢查結果:存檔、重載,跑一遍從已載入 PDF 擷取文字的普通路徑——預期的詞在預期的頁上回得來,這層就是真的
RapidOCR 與原生 DLL:同一份契約
簡體中文掃描件用 HPDFCreateRapidOCREngine(PythonExecutable, BridgeScript, ModelDirectory, TimeoutMilliseconds):同一個行程執行器與 TSV 解析器直接重用,橋接腳本路徑跟著 Python 執行檔,語言固定為 chi_sim。HotPDF 以 tools/OCR/rapidocr_tsv.py 出貨這支橋接腳本:它需要 rapidocr 與 onnxruntime 套件、本機 ONNX 模型與一個字型檔、拒絕自動下載、寫出 Tesseract 形狀的 TSV;THPDFRapidOCROptions 多載可設模型檔、執行緒數與像素上限。兩個配接器背後的通用工廠——HPDFLocalTSVRecognition 裡的 HPDFCreateLocalTSVOCREngine——收任何「吃 Tesseract 風格參數、寫十二欄 TSV」的程式,handle 清單、逾時、取消與預算全部繼承
HPDFCreateTesseractDLLOCREngine(LibraryPath, TessDataDirectory, Language) 則改在行程內載入 Tesseract C API:自報 Tesseract (native DLL)、預先檢查每個請求的 .traineddata 都存在、把取消與逾時映射到 Tesseract 自己的進度監視器。它每頁省一次行程啟動與一次 BMP 來回;執行檔版則把辨識器的崩潰與記憶體增長擋在您的位址空間之外。處理使用者自己掃描件的桌面工具,DLL 沒問題;吞陌生人文件的服務,命令列引擎更穩。無論哪種,辨識都跑在 Windows、一次一頁、對著渲染出的點陣圖——歪斜與髒污的掃描件,請在進引擎之前先處理
OCR 配接器、文字層寫入器、餵養它們的渲染器與驗證輸出的擷取,全部住在單一原生 VCL 元件裡,供 Delphi 與 C++Builder 使用。您的擷取或歸檔應用需要可搜尋 PDF 輸出時,HotPDF Delphi PDF component 涵蓋了 OCR 引擎以外的一切——引擎由您自行安裝