在保有標準 Macintosh 字形順序的 TrueType 字型裡,"Total" 這個詞在 PDF 內容串流中可以是 <0037005200570044004F> Tj。這五個雙位元組值是內嵌字型裡的字形編號,字串本身完全沒說它們要畫 T、o、t、a、l。把這些位元組當 UTF-16 讀,你會得到 7RWDO,頁面上顯示的卻是 Total,因為畫一個字形只需要「代碼對字形」的映射,把文字要回來卻需要「代碼對 Unicode」的映射,而檔案可能從頭到尾就沒帶
為什麼擷取出來的文字會變成亂碼?
內容串流記錄的是字元代碼,代碼的意義完全取決於字型。Tj 與 TJ 運算子(ISO 32000-1 §9.4.3)帶的位元組字串,要透過前一個 Tf 選中的字型來解讀:同一個位元組 0x41,在 WinAnsi 下是字母 A,在子集字型裡可以是任意字形,在復合 CJK 字型裡則可能是兩位元組 CID 的一半。ISO 32000-1 §9.10 把文字擷取正是當成這個解碼問題處理,從字型字典提供的一切把每個代碼對映回 Unicode,而且明講了:符合規範的檔案並不保證提供足夠資訊讓你做到這件事
每一則「從這份 PDF 複製貼上就出亂碼」的回報,源頭都是這一條。產生器內嵌了沒帶 /ToUnicode 表的子集字型,寫出的仍是合法檔案,渲染也完全正常。字形都在,缺的是反向映射,擷取器只能靠二手證據把它重建出來:字型宣告的編碼、字形名稱、Adobe 公開的字元集、內嵌字型程式裡的 cmap 表。一個 API 願意試其中幾樣、全部失敗時又交給你什麼,實務上就是各家擷取程式庫的分水嶺
用 ExtractLoadedPageText 取得閱讀順序文字
HotPDF Delphi Component 透過 function ExtractLoadedPageText(PageIndex: Integer; out AText: UnicodeString): boolean 傳回已載入頁面的閱讀順序文字。頁索引從 0 起算,結果是原生的 Delphi UnicodeString,頁面沒有可讀的內容串流時函式回傳 False 而不是拋例外。它對任何載入的 PDF 都管用:客戶寄來的發票、掃描中心交件的報告,還有那種沒人說得出名字的軟體產出的合約
var
  Pdf: THotPDF;
  PageCount, I: Integer;
  PageText, AllText: UnicodeString;
begin
  Pdf := THotPDF.Create(nil);
  try
    PageCount := Pdf.LoadFromFile('invoice.pdf');  // 傳回頁數
    AllText := '';
    for I := 0 to PageCount - 1 do
      if Pdf.ExtractLoadedPageText(I, PageText) then
        AllText := AllText + PageText + #13#10;
  finally
    Pdf.Free;
  end;
end;想把整份文件收進一個字串,ExtractLoadedPagesText(PageRange, PageSeparator) 接受從 1 起算的範圍,例如 '1,3-5,7-'(空字串代表每一頁),並在頁與頁之間放上 PageSeparator,預設是跳頁字元 #12。大文件更適合走 ExtractLoadedPagesTextToStream,它逐頁把 UTF-8 寫進 TStream,並回傳處理了幾頁
擷取的文字就是頁面顯示的內容。方塊中心落在可視範圍(媒體框內的裁切框)之外的字形會被排除,裁切後頁面上的印刷標記不會混進你的索引。頁面畫出的 Form XObject 裡的文字也算在內,並以各 Form XObject 的 /BBox 為裁切範圍。同一個位置畫兩次的字元——偽粗體的老招——只讀一次;文字擷取中的偽粗體與重複字形一文細說這個情況怎麼被偵測
換行遵循一條簡單的幾何規則。字形原點沿書寫方向移動超過文字高度的一半時開新行,高度取這個字形與前一個字形在頁面單位上 ascent 到 descent 兩者中較大者。量字形方塊而不是量 Tf 的尺寸運算元,正是關鍵所在:不少產生器靠文字矩陣縮放文字、給 Tf 傳 1,以那個運算元為門檻的話,每個上標字都會斷行,旋轉文字更會一字一行。空格的處理同理。產生器用 TJ 調整量或 Td 挪動文字位置來分隔單詞時,當前一個字形自身寬度之後的間隙超過字形高度的 0.15,就補一個空格,而且中日韓字元之間永不補。解碼器解不開的代碼變成空格,所以就算個別字形陣亡,單詞邊界還在。水平文字按內容串流順序輸出;直排 CJK 段落會重組成由右至左、由上至下閱讀的欄。頁面文字中的空格與換行細說這些門檻
網格、欄或結構順序
當位置本身帶著語義(表格、表單、程式碼清單,任何你要按欄 diff、grep 或剖析的東西),ExtractLoadedPageTextLayout 才是對的選擇。它把字形聚成基線,每條基線按 X 排序,並以頁面字形前進量與字號的中位數為格距,在等寬字元網格上重現水平和垂直空白。基線上的大間隙變成一串空格,基線之間的大間距變成空行
uses System.IOUtils;
...
var
  Grid: UnicodeString;
begin
  if Pdf.ExtractLoadedPageTextLayout(0, Grid) then
    TFile.WriteAllText('page1.txt', Grid, TEncoding.UTF8);
  // 欄、縮排與表格對齊會以字元網格上的
  // 空格與空行保留下來
end;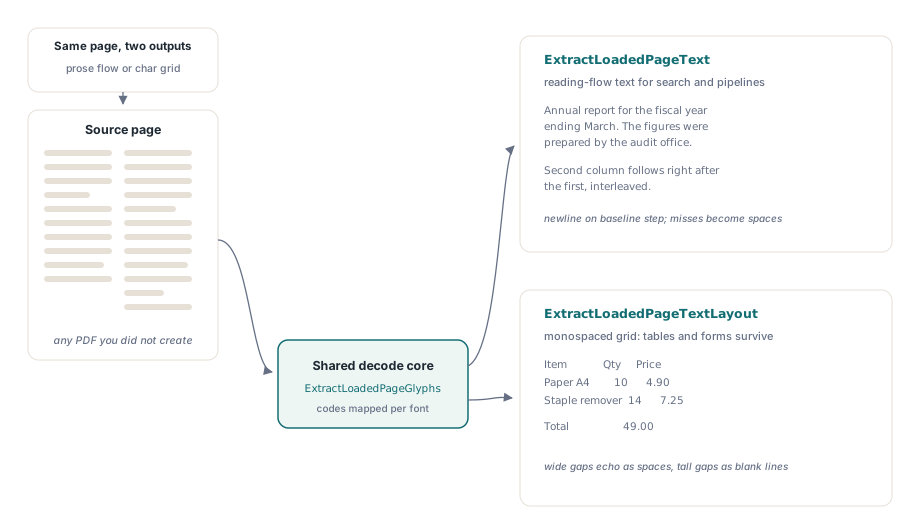
兩個呼叫走同一套解碼機制,選哪個都不犧牲保真度。網格辦不到的是重排散文:雙欄文章會兩欄並排、忠實呈現,拿去 diff 是對的,拿去餵摘要器就錯了。補這個缺口的是另外兩個呼叫。ExtractLoadedPageTextColumns(PageIndex, AText, ColumnGapMultiplier) 在相鄰字形的間隙超過中位前進量的倍數(預設 3.0)時切開每一列,並用定位點分隔各段。ExtractLoadedPageStructureText(PageIndex, AText, UntaggedGlyphCount) 走訪帶標籤 PDF 的結構樹(ISO 32000-1 §14.8.4),按撰寫順序傳回標記內容段落;頁面沒有可用的結構樹時回傳 False,UntaggedGlyphCount 則告訴你有多少字形放不進去
文字若是要給人或語言模型讀的,先試結構順序,不行再退回 ExtractLoadedPageText。結構樹是作者刻意聲明的順序,幾何方法再怎麼做都只是猜。欄位就是資料的場合留給網格。結構順序文字擷取細說標記內容怎麼對到樹上
HotPDF 如何把字元代碼解成 Unicode
HotPDF Delphi Component 按優先順序排好一條後備鏈來解每個字元代碼,答不上來的策略把代碼交給下一棒。字型的 /ToUnicode CMap(ISO 32000-1 §9.10.3)排第一,因為它是產生器專門為擷取寫下的唯一映射。接著是 /Encoding /Differences 陣列裡的字形名稱,對照 Adobe Glyph List 解讀;然後是 /Encoding CMap 本身,內嵌成串流或以名稱引用,名稱為 Uni…-UTF16 形式時代表代碼本來就是 UTF-16。復合字型繼續沿 Adobe 字元集(Adobe-GB1、Adobe-CNS1、Adobe-Japan1、Adobe-Korea1、Adobe-KR)從 CID 對到 Unicode,再經 /CIDToGIDMap 進到內嵌字型程式的 cmap 表,從字形反向對回 Unicode。簡單字型則退回 WinAnsi、MacRoman、Standard 與 MacExpert 表,最後同樣落到那張內嵌 cmap。整條鏈都解不開的代碼定為 0
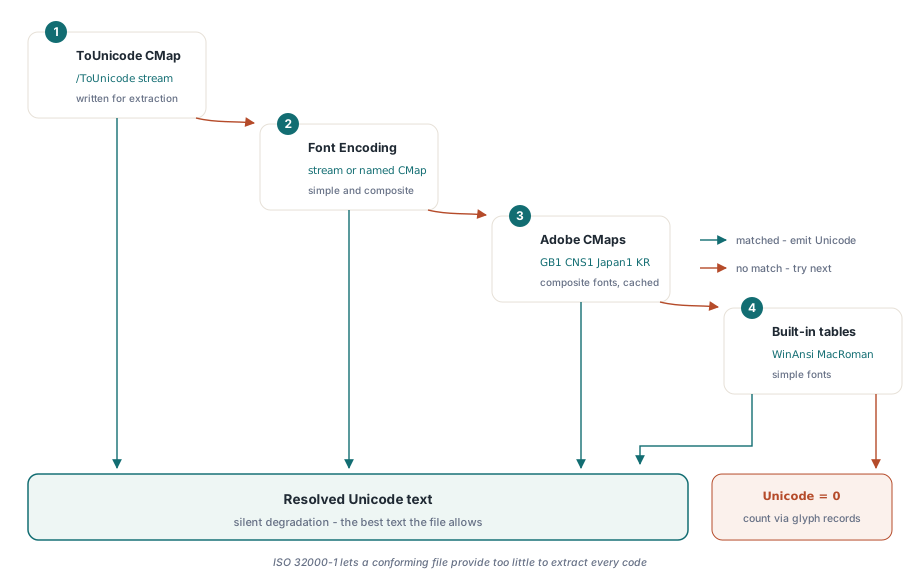
真正救回大批沒帶 /ToUnicode 的子集字型的,就是內嵌 cmap 這一步:字型程式裡通常還留著自己的 Unicode cmap,把它反向讀回來就能救回大部分文字。但這畢竟是重建。共用同一個字形的兩個 Unicode 字元會讀回同一個值(cmap 列了哪個就是哪個),所以重建出的文字拿來搜尋和建索引很好,要當法律紀錄用之前請先核對
Adobe 字元集的資料放在磁碟上。HotPDF 在 resources\CMap 資料夾裡附了 CMap 與 cid2code.txt 檔,每個檔案在每個行程裡最多剖析一次並快取結果;光 Adobe-GB1 一張圖就約 2 MB 文字,不會想每頁都重剖析。預先定義的 CMap 也有內建表版本,所以用 UniGB-UTF16-H 這類具名 CMap 編碼的字型,沒有那個資料夾照樣解得開。需要資料夾的是 Identity-H CJK 字型的 CID 對 Unicode 表。CMapResourcePath 屬性指向放這些字元集子資料夾的位置;留空時,HotPDF 會在執行檔旁及其上一兩層找 resources\CMap
Pdf := THotPDF.Create(nil);
try
  // 放 Adobe-GB1-6、Adobe-CNS1-7、Adobe-Japan1-7 ... 的資料夾
  Pdf.CMapResourcePath := 'C:\MyService\resources\CMap';
  Pdf.LoadFromFile(FileName);
  ...
finally
  Pdf.Free;
end;
在任何服務、ISAPI 模組或外掛 DLL 裡請明確設定這個路徑。這類宿主裡 ParamStr(0) 指的是宿主行程,往往不是你部署的資料夾,而資料夾不在也不會拋例外,CJK 頁面只是會在原本該由字元集表補上的地方留下洞。複雜文字塑形與 HotPDF在寫入端遇到的正是同一個「代碼對字形」難題
CMap 語法的兩個陷阱
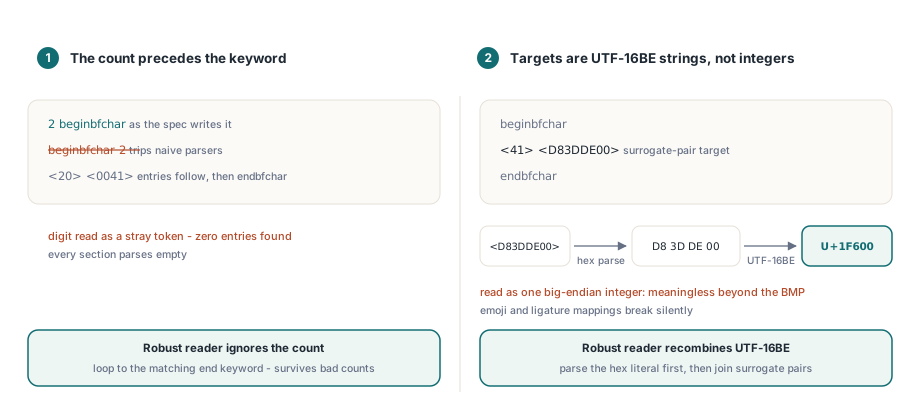
CMap 檔看起來好剖析,但有兩個細節絆倒過大多數人的第一次嘗試。記錄數寫在段落關鍵字之前:段落開頭是 2 beginbfchar,不是 beginbfchar 2。預期數字在關鍵字後面的剖析器會把那個數字當成迷路記號吞掉,然後在每個段落裡找到零筆記錄。HotPDF 的讀取器完全無視記錄數,一路迴圈到配對的 endbfchar 或 endbfrange 為止,順便也容得下宣告數字寫錯的真實世界檔案
第二個陷阱是 bfchar 與 bfrange 的目標是 UTF-16BE 字串。目標 <D83DDE00> 指的是 U+1F600,一組必須重新合併成單一代碼點的代理對,把那四個位元組當大端整數讀,基本多文種平面以外的每個字元——emoji 也在內——都會得到毫無意義的值。HotPDF 先把十六進位字面值解成原始位元組,再重組 UTF-16BE 代碼單元,連字映射產生的多字元目標也一併處理,例如一個 fi 字形對到兩個字母
用 ExtractLoadedPageGlyphs 數出未解開的字形
ExtractLoadedPageGlyphs(PageIndex, AGlyphs) 把文字呼叫底層的字形記錄以 THPDFGlyphArray 攤開給你。每個 THPDFGlyphRecord 帶著原始 Code、CodeByteWidth(1、2 或 4,由 CMap 的 codespacerange 決定)、解出的 Unicode 代碼點與連字用的 UnicodeSequence、生效的 FontKey 與 FontSize、使用者空間的 X 與 Y 原點、Advance、四角字形四邊形,還有 GlyphEndX / GlyphEndY——字詞間距規則的量測起點,即字形自身寬度的終點。做定位高亮或自己的版面演算法,這些資訊夠用了
var
  Glyphs: THPDFGlyphArray;
  I, Unresolved: Integer;
begin
  if Pdf.ExtractLoadedPageGlyphs(0, Glyphs) then
  begin
    Unresolved := 0;
    for I := 0 to High(Glyphs) do
      if Glyphs[I].Unicode = 0 then
        Inc(Unresolved);
    if Unresolved > 0 then
      ShowMessageFmt('%d of %d glyphs have no Unicode mapping',
        [Unresolved, Length(Glyphs)]);
  end;
end;
在把文字交給下游之前,數 Unicode = 0 的記錄是評估一份文件最誠實的辦法。這個數字跟文字呼叫看到的會略有出入,要有預期:本呼叫傳回頁面自身內容串流裡的每一個字形,包括裁切框之外的和偽粗體畫的重複字形,也不深入 Form XObject。每筆記錄還存了 TokenIndex、ItemIndex 與 ByteOffset,把字元拴回它的來源運算元;在既有 PDF 中搜尋與取代就是建立在這三個欄位上
有些檔案無文字可給。掃描頁就是一張大圖,沒有文字運算子,擷取如實回傳空字串,往前的路是 OCR,從從已載入的 PDF 擷取頁面影像起步。加密文件用 LoadFromFile(FileName, Password) 打開後就能正常擷取,因為串流在解譯器讀取之前就已解密。字型與內容串流和文件其他部分走同一條過濾器鏈解碼,解不開的 /ToUnicode 串流會退到下一個策略,頁面其餘部分照樣擷取。同一套物件讀取器也支撐著編輯已載入文件的中繼資料,一次進件就能既讀文字又補中繼資料
閱讀順序、網格、分欄與結構順序擷取,加上字形層級存取,全部隨支援 Delphi 與 C++Builder 的HotPDF Delphi Component 出貨,純 Object Pascal,不依賴外部 DLL 或作業系統文字服務,所以怪檔案進了佇列時,你可以直接步進解碼器,看每個代碼是哪個策略接的