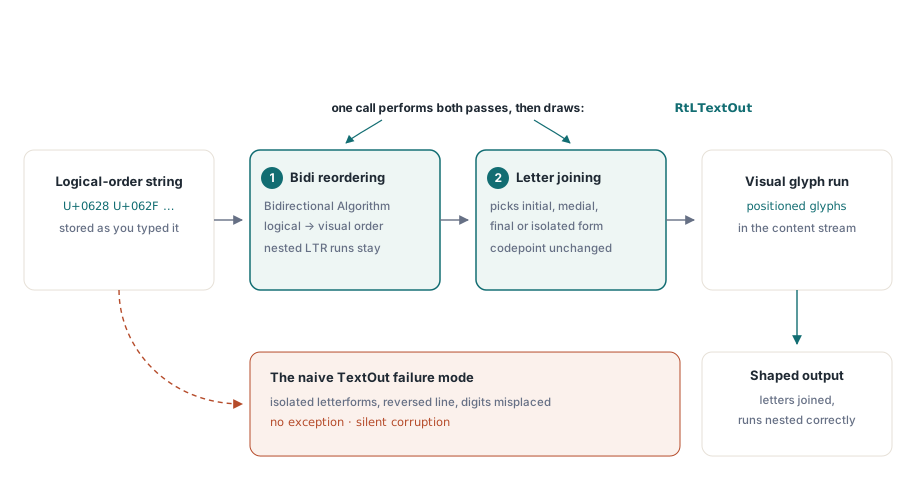
把阿拉伯文片語 يوضح ملف PDF 傳給 TextOut,再打開結果看看。字母跑錯了方向,而且每一個都以孤立形出現,跟下一個之間留著看得見的空隙,好像有人把英文倒著打、還在每個字元之間敲了空白鍵。沒有例外被觸發。沒有警告被印出。輸出就是錯的,而它之所以錯,是因為阿拉伯文所依賴的兩道各自獨立的轉換從來沒有發生。弄清楚那兩道轉換是什麼、哪一個呼叫會執行它們,就幾乎等於弄清楚了複雜文字系統的 PDF 輸出這回事
HotPDF 是給 Delphi 與 C++Builder 用的原生 VCL PDF 元件,它透過一個獨立的呼叫替您做掉由右至左的工作。它也在幾個明確的地方就此止步,而您會想在投入某個語系之前先知道那些地方,所以本文梳理的是概念與誠實的邊界;那個呼叫本身的實作設定則在 RtLTextOut 參考文章裡
為什麼一個正確的字串印出來還是錯的
Unicode 以邏輯順序保存文字,也就是您打字與朗讀的順序。算繪器則必須以視覺順序把字形放下去。對由左至右的文字系統來說,這兩種順序重合,沒有人會想到它。對阿拉伯文與希伯來文來說則不然,而當同一行混雜了方向時,比方說一句阿拉伯文裡帶著拉丁字串「PDF」或一個以數字寫成的價格,Unicode 雙向演算法(UAX #9)就精確決定那些由左至右的片段要如何巢狀在由右至左的行裡。那是第一道轉換,重排,而略過它正是整行翻掉的原因
第二道是上下文塑形。一個阿拉伯字母依它落在字中的什麼位置而畫得不一樣:詞首、詞中、詞尾,或獨立站立。碼位自始至終都一樣,變的只有字形。一條把每個碼位直接交給它預設字形的管線,產出的正是開頭那一段裡那種斷開的孤立形輸出。希伯來文跳過這一步,因為它的字母不連寫,但它仍然需要重排。阿拉伯文兩者都要,這也就是為什麼用來測試的字串是阿拉伯文,不是希伯來文
在桌面上這些都不是您的問題。當一個 VCL 表單把阿拉伯文畫進 TEdit 時,作業系統的文字堆疊會默默地把它重排並塑形,而這正是為什麼在螢幕上看起來完美的字串,到了樸素的 PDF 裡就壞掉。內容串流不儲存可編輯的文字。它儲存的是已定位的字形,所以誰發出這道串流,誰就繼承了原本由作業系統代勞的塑形工作。RtLTextOut 就是把那份工作接回來的那個呼叫
RtLTextOut 替您塑形什麼
HotPDF 把拉丁路徑與複雜文字系統路徑分成兩個不同的方法。TextOut 以您給它的順序印出您給它的東西。RtLTextOut 則先執行兩道轉換——橫跨整行的雙向重排、針對連寫文字系統的上下文分析——然後才印。要套用哪一套文字系統的規則,是經由字型的字元集傳進去的,而不是經由呼叫本身,所以方向在每一個呼叫點都是一個明確的選擇,而不是從字元猜出來的。逐參數的設定、字元集的值、字型註冊的步驟,以及一個完整可編譯的範例,全都在 RtLTextOut 參考文章裡;本文只談這些轉換的意義、它們在哪裡停下,以及如何證明它們真的生效了
即使在這個高度上,仍有一條使用規則很要緊:輸入必須是邏輯順序,因為 RtLTextOut 會自己執行那次反轉,而一個您已經手動翻過的字串出來會被翻兩次——參考文章走過那個陷阱與它的清理方式。這個陷阱值得在此一提的理由,是它為什麼撐得過測試。一個被翻了兩次的純阿拉伯文字串可以看起來完全正確,只有當某一行帶著一個拉丁單字或一個數字時才會散掉,因為那些內嵌的區段不再按 UAX #9 所規定的方式巢狀。臭蟲不在算繪;它在於餵給演算法的是已經處理到一半的文字
同樣這種混合方向的行為,絆倒審查者的次數比絆倒程式碼還多。在一行由右至左的文字裡,數字與內嵌的拉丁單字仍然由左往右讀。一個沒接觸過雙向排版的人看著算繪出來的發票,會看到帳號相對於周圍的阿拉伯文讀起來是「反」的,然後把它寫成臭蟲。那是規範上正確的結果。在驗收準則裡寫一小段註記,寫在第一次母語人士審閱之前,就省下那趟往返
重排與連寫何時足夠,何時不夠
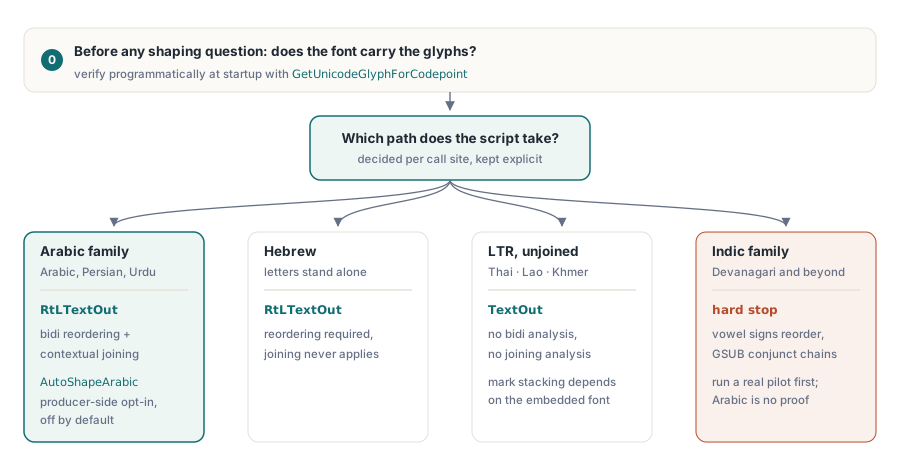
對阿拉伯文與希伯來文的行文——報表、發票、合約、信件——重排加上上下文連寫就是全部的工作,RtLTextOut 一個人扛得起來。邊界出現在排版要求的東西多過連寫的時候。HotPDF 在阿拉伯文這一側的答案是一個需自行啟用的生產端塑形器:設定 AutoShapeArabic := True,元件就會在雙向掃描之前把邏輯順序的區段改寫成 Unicode 呈現形式,於是連寫形是依邏輯上的鄰居算出來的,連字合併也被烤進 PDF 實際承載的碼位裡,而不是留給檢視器去解。這個開關預設為關閉,而在它維持關閉時輸出是位元組穩定的,所以把它打開是逐條文件管線的一項刻意決定,不是一次全域升級。同樣的自行啟用模式也延伸到 HotPDF 所塑形的其他連寫型由右至左文字系統:Syriac、N'Ko、Adlam 與 Hanifi Rohingya 各自有一個對應阿拉伯文那個旗標的自動塑形旗標
選用的 OpenType 特性又是另一套機制。任意連字與類似的單一替換特性走的是 GetSingleSubstituteGlyph(GID, 'liga'),它一次解一項替換——先是輸入字形 ID,其次是特性標籤——並在該特性不適用時原封不動傳回輸入字形。那足以驅動一份由您自己維護的、已知而有限的連字清單。它不是一套完整的 GSUB 引擎,而這道差別,正是雄心勃勃的語系計畫出錯之處:一條把阿拉伯文處理得無懈可擊的塑形管線,證明的是重排與連寫,別無其他
跨文字系統的涵蓋範圍
阿拉伯文同時操練兩道轉換,這就是為什麼它是拿來測試的字串,也是為什麼一次阿拉伯文的通過,是這條管線能動最有力的單一證據。希伯來文需要重排但不需要連寫,因為它的字母各自站立;如果希伯來文算繪正確而阿拉伯文出來是斷開的,那就是雙向那一半沒問題、上下文那一半根本沒跑。波斯文與烏爾都文搭的是阿拉伯文字系統,並承襲它的行為,不過烏爾都文偏好 Nastaliq 風格是一項字型決策,而它在易讀性上的後果應該由母語讀者來判斷
泰文則完全坐在界線的另一側。它由左至右,所以不需要雙向處理,而它的字母不連寫,所以不需要上下文分析;泰文字串跟拉丁文一樣走一般的 TextOut 路徑。泰文真正有的是堆疊標記——基底子音上下方的母音與聲調符號——而它們擺得正不正,取決於字型有沒有把它的結合標記做成不靠塑形引擎也能堆疊。多數專門的泰文字型都做到了。請拿您實際要嵌入的那套字型測試,不是拿一套長得像的
天城文與印度系其餘家族則是誠實的硬性止步點。它們的母音符號會繞著子音叢重排,而它們的合體字透過一連串依上下文而定的替換形成,那是完整 GSUB 的地盤,超出重排與連寫之外。如果藍圖上有印度系語系,請在您承諾之前拿真實的客戶字串跑一次真正的試行——阿拉伯文能動並不能證明天城文也會動。CJK 字串、帶堆疊變音符號的越南文,以及混合的歐洲文字,全都走一般路徑而不做雙向分析,而且值得在報表程式碼裡把這兩條路徑實體分開,一條常式處理 RTL 區段、另一條處理其餘一切,好讓語系邏輯在呼叫點就看得見,而不是藏在某個有人會忘了設的旗標背後
字形涵蓋在塑形跑起來之前就已定案
塑形是從字型裡挑字形。如果字型沒帶著它們,就沒有東西可挑,這也就是為什麼那個經典的部署失敗——在開發者的機器上完美無瑕,在客戶伺服器上經過一次無聲的字型替換後變成一格格空方塊——是涵蓋問題,不是塑形問題。實務上的療法是註冊一套您自己出貨的字型,而不是信任機器上剛好裝了什麼,參考文章逐步走過這件事。概念上的重點是,涵蓋必須在任何塑形問題有意義之前就先確立,而且它可以用程式確立,不必靠肉眼盯輸出
// 在 RegisterUnicodeTTF 之後,針對您資料實際
// 用到的碼位稽核涵蓋範圍
GID := Pdf.GetUnicodeGlyphForCodepoint($0628);  // U+0628 ARABIC LETTER BEH
LogGlyphAudit($0628, GID);
註冊本身帶著兩項限制——內嵌 Unicode 處理的 PDF 1.5 下限,以及字型的嵌入權限位元——兩者都跟設定步驟一起涵蓋於 RtLTextOut 參考文章。屬於這裡的是稽核的習慣:GetUnicodeGlyphForCodepoint 是您的預警系統。在服務啟動時走一遍您資料實際會用到的碼位範圍,並記下傳回來的字形 ID。這樣一來,涵蓋缺口會在推行期間以啟動日誌裡的一行呈現,而不是以一張已經送到客戶手上的發票裡缺字的形式呈現
閱讀順序屬於文件,不屬於字形
把每一個字形都弄對了,仍然留著一件事沒做。ISO 32000-1 §12.2 定義了一項名為 /Direction 的檢視器偏好設定,用來陳述文件整體的閱讀順序。它不碰任何字形。它做的是告訴檢視器如何排列雙頁跨頁、對頁版面該從哪一側開始,以及閱讀介面該往哪個方向偏。這些在單一頁面上都看不出來,而那正是它被遺忘的原因
// 在文件層級宣告由右至左的閱讀順序
Pdf.Direction := RightToLeft;  // 會把 vpDirection 加進 ViewerPreferences
設定 Direction 就是全部的工作:屬性的設定式會把 vpDirection 加進文件的 ViewerPreferences,所以一行就把這項偏好帶進檔案。如果文字是經由 RtLTextOut 送出去的,這件事您白撿,因為那個呼叫會以副作用的方式翻轉文件方向——參考文章談到一份混合文件何時需要把它撤銷。您必須自己設定的情況,是一份以任何其他方式產生的由右至左文件,例如來自您在上游先塑形好、再走一般路徑畫出來的輸入。把它漏掉,您盯著的那份單頁證明看起來兩種情況一模一樣;然後有人印了一本雙面小冊,跨頁出來是鏡像的,而成因是幾週前少寫的那一行
驗證塑形後的輸出
請端到端地驗證,因為一頁可以看起來正確,對下游的一切卻毫無用處。三項檢查能找出多數問題。從 Acrobat 把文字複製出來,拿碼位跟您的來源字串比對。用檢視器的文件內搜尋去找一個您在頁面上看得見的字。以及在一台沒有您開發用字型的機器上開啟輸出,那台最可能讓字型替換現形。這些都取代不了一位母語讀者看一份真實文件,那會抓到任何合成語料都抓不到的東西。請在這個格式出貨之前,把那次審閱排進行事曆
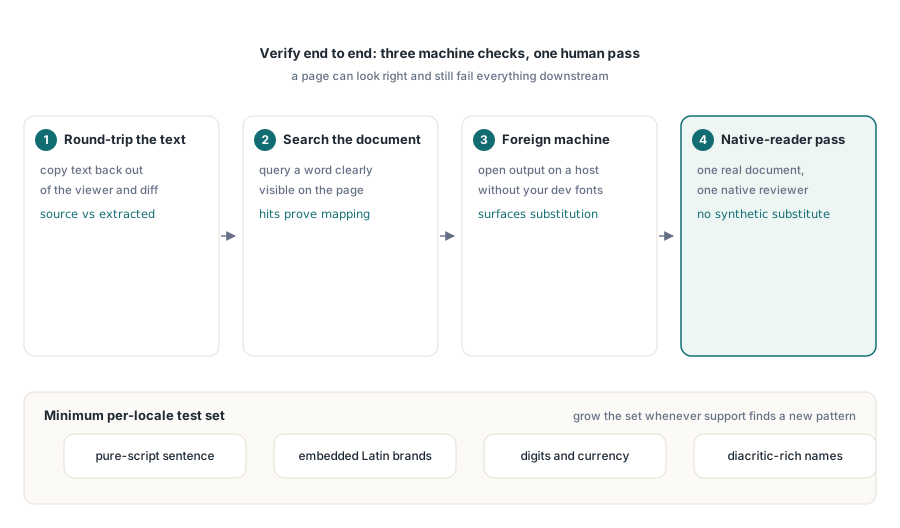
請刻意挑選測試字串,而不是回收翻譯者去年送來的隨便什麼東西。每個語系可行的最低配備是:一句純文字系統的句子、一句內嵌拉丁品牌名的句子、一行帶數字與貨幣的內容,以及帶變音符號或結合標記的姓名。真實的客戶姓名會打破填充文字碰不到的假設,所以每當一件支援案揭露一個您沒見過的樣式時,就讓迴歸集合多長出一個字串
字型註冊、子集化與日常的文字繪製 API,涵蓋於 用 HotPDF 做報表輸出、字型與影像的文章。當同一批文件還必須符合無障礙設定檔時,PDF/A 與 PDF/UA 驗證那篇文章裡的語言標記與結構規則,就疊在這裡的塑形工作之上
上述由右至左與 Unicode 字型 API 隨給 Delphi 與 C++Builder 的 HotPDF Delphi Component 一同出貨;產品頁連結了完整的文字輸出參考