內容串流片段 [(Reference)-333(Manual)] TJ 畫出兩個字詞、中間有明顯間距,卻一個空格字元都不含。那個間距是筆的移動:ISO 32000-1 §9.4.3 告訴閱讀器在畫 Manual 之前,把下一個字形右移字型大小的 333/1000。只抄字元、不管幾何的擷取器回傳 ReferenceManual,以它為源的搜尋索引永遠匹配不到 “Reference Manual” 這個片語。TeX 輸出、不少 Distiller 檔案與大多數兩端對齊的版面,都用這種方式分詞
換行則從另一頭出錯。抬高的上標把一行切成兩半,斜向的 DRAFT 浮水印一行一個字元地抵達,裁切過的校樣以沒有任何檢視器會顯示的印廠標記行開頭。這些檔案沒有一個是壞的;每一個都用了一種合法的文字擺放方式,而字元複製型擷取器剛好會讀錯
從字形幾何重建字詞空格
HotPDF Delphi Component 的 THotPDF.ExtractLoadedPageText 依字形位置判定斷詞,串流裡的空格字元只是它讀取的訊號之一。沿上一個字形的書寫方向,它量測該字形自身寬度終點到目前字形原點的距離,距離超過目前字形盒高的 0.15(在使用者空間從升部量到降部)時插入一個空格。對上面的 TJ 片段,三分之一個 em 對任何普通正文字體都輕鬆越過這條線,所以頁面文字讀作 Reference Manual
兩個條件會把空格攔下來。現有文字已以空白結尾、或下一個字形就是空白(空格、tab、不換行空格、全形空格)時,不加,所以確實輸出空格的生產器不會得到雙倍空格。兩個 CJK 字元之間也不加。漢字、假名、韓文與全形字形都算在內,因為對齊會把中文或日文行拉開,那個拉伸不代表詞的邊界。與兩者分開的另一條:高度為零的字形盒,以 Tf 大小當它的盒高。這條規則用到的每個數字都存在字形記錄上,間距看起來不對的檔案可以逐字形重播驗證
uses
  SysUtils, HPDFDoc, HPDFContentStream;

// 印出 ExtractLoadedPageText 會轉成空格的間距。
// 僅限水平文字;ExtractLoadedPageGlyphs 回傳頁面
// 內容串流,不含 Form XObject 文字、不套裁切過濾
procedure DumpWordGaps(Pdf: THotPDF; PageIndex: Integer);
var
  Glyphs: THPDFGlyphArray;
  I: Integer;
  Height, Gap: Double;
begin
  if not Pdf.ExtractLoadedPageGlyphs(PageIndex, Glyphs) then
    Exit;
  for I := 1 to High(Glyphs) do
  begin
    if Glyphs[I].Vertical or Glyphs[I - 1].Vertical then
      Continue;
    // 字形盒升部到降部的高度,使用者空間
    Height := Sqrt(Sqr(Glyphs[I].QuadX[3] - Glyphs[I].QuadX[0]) +
      Sqr(Glyphs[I].QuadY[3] - Glyphs[I].QuadY[0]));
    if Height <= 0 then
      Height := Abs(Glyphs[I].FontSize);
    // 上一個字形自身寬度終點起的間距
    Gap := Glyphs[I].BaselineStartX - Glyphs[I - 1].GlyphEndX;
    if (Height > 0) and (Gap > 0.15 * Height) then
      Writeln(Format('U+%.4x gap %.2f height %.2f: space',
        [Glyphs[I].Unicode, Gap, Height]));
  end;
end;
為什麼從字形自身寬度量起、而不是從筆的位置?
因為字形畫完後的筆位置,已經摻進與斷詞毫無關係的間距。ISO 32000-1 §9.4.4 把水平位移定義為字形寬度乘字型大小,加上字元間距 Tc,加上單詞間距 Tw,全部再乘水平縮放 Tz。每個字形記錄兩端都有:BaselineEndX / BaselineEndY 握有完整位移,GlyphEndX / GlyphEndY 只握目前大小下的字體前進量與 Tz。兩者在用負 Tc 收緊字距、又在每個字形後以 TJ 調整把空間還回來的檔案上分道揚鑣。從筆位置量,每一次「還回來」看起來都像間距,“95后” 這種中文詞就變成 “9 5 后”。從字形自身寬度量,調整只是把 Tc 拿走的還回來,詞保持完整
門檻綁在字形盒高而非 Tf 大小上,理由相近。Word 匯出的檔案常寫 1 Tf、把真實尺寸放在帶縮放的 Tm 裡,字型大小運算元讀作 1,文字卻有 10 點高。以那個運算元為準的規則,會把門檻壓到這種頁面上的 0.15 點,普通的字距對就開始被讀成斷詞。盒高是在所有矩陣都套用之後量測的,所以帶縮放矩陣的 1 Tf 與樸素的 10 Tf 產出相同文字
兩個邊界情況直接源自幾何。用非常鬆的字距排的標題——Tc 一項就在字母間撐開超過文字高度的 0.15——會擷取成 S P A C E D。頁面上看起來就是這樣,我們寧願原樣回傳,也不加一個猜測哪些寬間距是字距調整、哪些是真正詞界的啟發式;那種猜測會開始吞掉緊密對齊欄位裡的真斷詞,對搜尋是更糟的失敗。同一基準線上不按順序畫出的片段產生負間距、無空格相接。在連續正文中這種情況很少見
擷取文字裡的換行什麼時候出現?
ExtractLoadedPageText 在「上一個字形原點到目前原點的移動、投影到上一個書寫方向法線上的分量」超過兩個字形較大盒高的一半時,開新的一行。沿基準線的移動永不計入換行,不論筆跳多遠
拿原始 Y 位移與 Tf 大小一半比較的規則,會朝兩個方向失敗。帶 1 Tf 與縮放 Tm 時,門檻縮到半個單位,被 0.4 的文字抬升抬起的上標就斷行了;某些排版引擎留在 run 之間的微小基準線抖動也一樣。同一條規則還完全無視 X。在旋轉 Tm 之下的文字——比如那個斜向浮水印——每個字形都往頁面下方踩一步,輸出成一行一個字元,而投影法對 45 度的 run 與水平 run 一視同仁
取兩個高度的較大者,在同線混用尺寸時至關重要。36 點的展示字後面跟著低了幾點的 8 點說明文字,判準是較大字形高度的一半,這一對就留在同一行;只按小字形判,說明文字會自己掉到一行。文字抬升是字形原點的一部分,所以上標抬高的基準線也是對著同一個半高來量
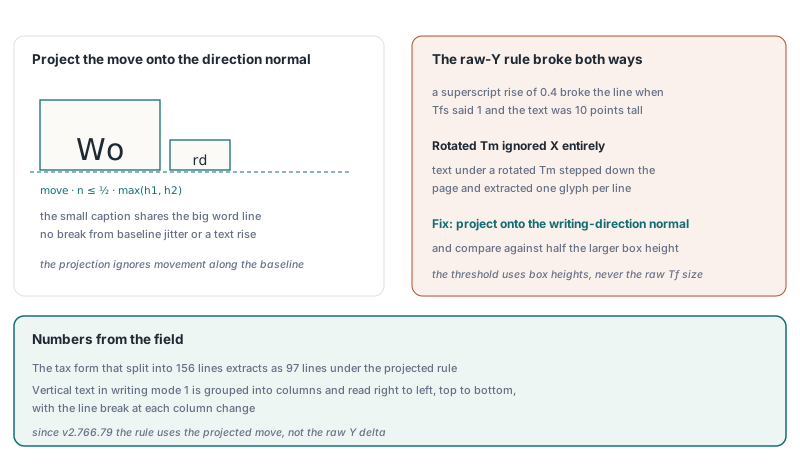
書寫模式 1(§9.7.4.3)的直排文字走另一條路。那些字形按原點 X 分組成欄、以半個字型大小為欄寬容差,然後由右至左、由上至下讀取,每次換欄插一個換行。直排日文正文混著水平頁首的頁面,在兩個方向之間的每次切換處也會有換行
哪些字形進得了頁面文字
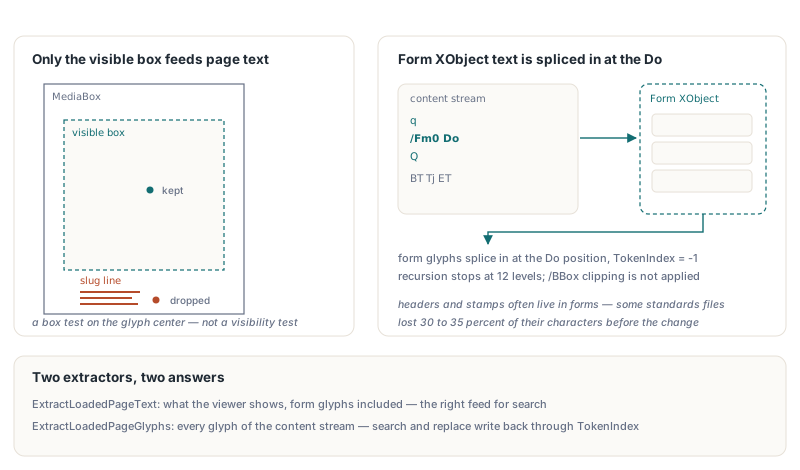
ExtractLoadedPageText 回傳檢視器顯示的文字。它只保留盒心落在 GetLoadedPageVisibleBox 之內的字形——即被 MediaBox 裁切的 CropBox(§14.11.2)——設在裁切區之外的印廠標記行與其他印刷記號文字就此出局。ExtractLoadedPageGlyphs 仍回傳頁面內容串流的每一個字形、標記行在內,給需要的任務。這個過濾是對每個字形單點的幾何測試。被裁切路徑藏住、畫成白色、或被影像蓋住的文字照樣出來,因為判定真實可見度意味著渲染頁面
uses
  SysUtils, HPDFDoc, HPDFContentStream;

var
  Pdf: THotPDF;
  Raw, Merged: THPDFGlyphArray;
  PageText: UnicodeString;
  L, B, R, T: Single;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.LoadFromFile('trimmed-proof.pdf');
    if Pdf.GetLoadedPageVisibleBox(0, L, B, R, T) then
      Writeln(Format('Visible box: %.1f %.1f %.1f %.1f', [L, B, R, T]));
    // 頁面內容串流的每一個字形,印廠標記行在內
    if Pdf.ExtractLoadedPageGlyphs(0, Raw) then
      Writeln(Length(Raw), ' glyphs in the page content stream');
    // 頁面串流加 Form XObject 文字,按繪製順序、裁切之前
    if Pdf.ExtractLoadedPageGlyphsWithForms(0, Merged) then
      Writeln(Length(Merged), ' glyphs including forms');
    // 頁面顯示的樣子:表單文字嵌入、裁切外字形剔除
    if Pdf.ExtractLoadedPageText(0, PageText) then
      Writeln(PageText);
    // 同一套間距規則套在未過濾串流上,方便比對差異
    Writeln(HPDFAssemblePageText(Raw));
  finally
    Pdf.Free;
  end;
end.
經 Form XObject 畫出的文字是頁面文字的一部分。頁首、印章與浮水印常常住在表單裡,只讀頁面內容串流的擷取器永遠看不到。HotPDF 記錄每個 Do 與當下的 CTM,以表單的 /Matrix 乘上該 CTM 解讀(§8.10.1),把表單的字形嵌在 Do 的位置,並遞迴進入巢狀表單。沒有自己的 /Resources 的表單,借用畫出它的串流的資源——§7.8.3 描述的較舊安排。盒心落在表單 /BBox 之外的字形被剔除,因為表單繪製時就以那個盒裁切。直接或經由另一個表單畫出自己的表單不會被進入第二次,巢狀在 12 層停止
表單字形帶 TokenIndex = -1 與 ItemIndex = -1。同樣的理由讓 ExtractLoadedPageGlyphs 只限頁面串流字形:搜尋、取代與遮蔽經 TokenIndex 把修改寫回,陣列裡混進表單字形會把它們指向另一條串流的位元組。需要在字形層級拿合併清單時,ExtractLoadedPageGlyphsWithForms 在可見盒過濾之前、按繪製順序回傳
間距規則之前還有一道處理。疊印的 logo 與以小偏移畫兩次同段文字假冒的粗體,不去除的話每個字母都會擷取成雙份。某字形在早先字形沿基準線十分之一、橫向五分之一的範圍內、以相同尺寸畫出相同字元時,只保留一份;空格絕不會被這樣移除。文字擷取中的假粗體與重複字形一文細講那個案例
跨越 q 與 Q 的文字狀態
只在 q 時保存 CTM 的擷取器,Q 之後的文字必然解碼錯誤。文字狀態參數——字型、大小、Tc、Tw、Tz、TL、渲染模式與抬升——屬於圖形狀態(§9.3.1),Q 必須把它們與堆疊上的其他一切一起還原(§8.4.2)。有個模式能很快暴露這個錯誤:某個表格儲存格在 q … Q 內選了雙位元組的 Identity-H 字型,Q 之後的文字沒有自己的 Tf、卻顯示單位元組 WinAnsi 字串。保留內層字型的直譯器把那些位元組成對地讀,目錄的前導點就變成一串不相干的 CJK 字元。HotPDF 的直譯器在每個 q 把全部八個文字狀態值連同 CTM 一起推入、每個 Q 一起彈出
以上每一條在每一頁都成立,所以整份文件能一次呼叫寫進 UTF-8 檔案。ExtractLoadedPagesTextToStream 接受從 1 起算的頁面範圍(空字串代表每一頁)、頁與頁之間寫入的分隔符、以及位元組順序記號旗標,回傳擷取的頁數。輸出附加在串流目前位置之後,記憶體裡任何時刻都不會握著超過一頁文字的量
uses
  SysUtils, Classes, HPDFDoc;

var
  Pdf: THotPDF;
  Output: TFileStream;
  Pages: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.LoadFromFile('report.pdf');
    Output := TFileStream.Create('report.txt', fmCreate);
    try
      // 空範圍 = 每一頁;頁間插換頁字元;UTF-8 BOM
      Pages := Pdf.ExtractLoadedPagesTextToStream(Output, '', #12, True);
      Writeln(Pages, ' pages extracted');
    finally
      Output.Free;
    end;
  finally
    Pdf.Free;
  end;
end.
為工作挑對文字 API
搜尋與索引該餵 ExtractLoadedPageText:它遵循內容串流順序、反映頁面顯示的樣子。它腳下的解碼鏈——從 /ToUnicode 對應表到 CID 字型——在以 HotPDF 從已載入 PDF 擷取文字一文有完整說明。內容串流順序最吃虧的地方,是製作工具最後才寫頁首、或把兩欄交錯寫出的有標記文件;對那些,結構順序文字擷取改走結構樹的製作順序,而非從幾何推斷。鎖在表格裡的資料,跨頁的帶型別表格擷取更合適,它連值一起回傳儲存格。要編輯頁面的程式碼該用 ExtractLoadedPageGlyphs,它的 token 索引直指即將改寫的位元組
這些範例用到的字形記錄欄位,連同其餘的文字擷取 API 與試用版,都記載在HotPDF Delphi PDF Component 產品頁