TerminateThread 看起來是停掉某個 OCR 呼叫的直覺做法——那個呼叫在同一張掃描頁上磨蹭的時間早就超過 UI 願意等的極限。Windows 文件解釋了為什麼不行:目標執行緒若握著 process heap lock,這把鎖永遠放不掉,其他執行緒的下一筆配置可能從此卡死。OCR 一旦跑進您自己的行程,唯一安全的停止方式就是合作式——在推論階段之間的檢查點停——這正是「模型只載一次、保持溫熱」的代價
多數 Delphi 團隊先試的替代方案是子行程。每頁一個 Python worker 確實隨時殺得掉,很有吸引力,但每次呼叫都要啟動直譯器、匯入 runtime、載入偵測與辨識模型,然後才讀到第一個像素。假設一個檔案庫作業有 500 頁:這套啟動流程要跑 500 次,部署物裡還多了一個緊挨著原生執行檔的 Python 環境
用 HPDFCreateRapidOCRDLLOCREngine 把掃描變成可搜尋 PDF
HotPDF 透過 HPDFCreateRapidOCRDLLOCREngine 行程內執行 RapidOCR,函式宣告在 HPDFRapidOCRRecognition 單元裡。工廠載入 HotPDFRapidOCR.dll,一次性初始化 ONNX 偵測、可有可無的角度分類與辨識模型,回傳一個 IHPDFOCREngine。這顆引擎接上 THotPDF.ApplyLoadedOCRTextLayer 的方式與其他 OCR 引擎完全相同:文件渲染每一頁、DLL 在頁面上跑 CPU 推論、結果以隱形 Unicode 文字層提交。免 Python、免子行程。配接器提供 Delphi、C++Builder 與 Windows FPC/Lazarus 建置
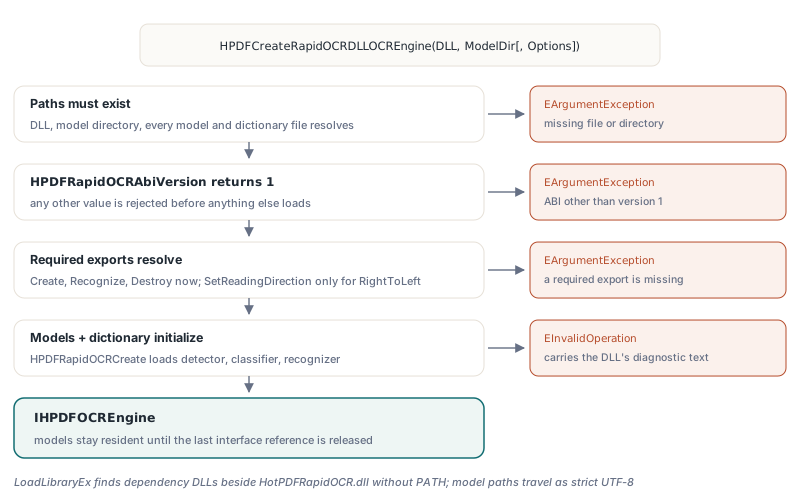
驗證發生在工廠裡,在任何頁面被碰之前。每個模型與字典檔都必須解析得到,HPDFRapidOCRAbiVersion 必須回傳 1,必要的 export 必須在 HPDFRapidOCRCreate 建模型之前就存在。設定錯誤丟 EArgumentException;模型載不起來丟 EInvalidOperation,帶著 DLL 自己的診斷訊息——例如字典與辨識模型對不上
uses
  SysUtils, HPDFTypes, HPDFDoc, HPDFRapidOCRRecognition;

procedure MakeSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // 模型在這裡載入,不在任何辨識期限的壓力之下。
  // THPDFRapidOCRDLLOptions.Default 裡的相對名稱
  // 以模型目錄為基準解析
  Engine := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models');
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default;  // 300 DPI、MinimumConfidence 0.5
    // 空頁面清單 = 每一頁;SkipPagesWithText 預設為 True
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' lines accepted, ', Info.DroppedWordCount, ' dropped');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;
THPDFRapidOCRDLLOptions.Default 指名 ch_PP-OCRv3_det_infer.onnx、ch_PP-OCRv3_rec_infer.onnx、ch_ppocr_mobile_v2.0_cls_infer.onnx 與 ppocr_keys_v1.txt,單一 CPU 執行緒、每次請求 16,777,216 像素上限、每筆辨識呼叫 60,000 ms 期限。其他文字系統用 THPDFRapidOCRDLLOptions.ForLanguage:保留這些預設,換進九個設定檔之一的 <profile>/recognition.onnx 與 <profile>/dictionary.txt,從繁體中文、西里爾文到阿拉伯文、天城文都有。一顆引擎只讀一種語言;按頁或按文件挑設定檔。模型與字典為什麼總是成對出行,見 HotPDF 的 RapidOCR 多語言模型與 CTC 字典一文
引擎在 Info.EngineName 裡自報為 RapidOCR (native DLL)。把這個字串寫進日誌:同一個服務若還跑著外接 Tesseract OCR 行程配接器或內建模板比對 OCR 引擎,這是判斷壞頁出自哪個辨識器的最快方法
為什麼這個 C ABI 只講 int32_t 與 UTF-8 位元組?
HotPDFRapidOCR.dll 邊界只用固定寬度整數、裸指標與明確的位元組長度,因為 Delphi、C++Builder 與 Free Pascal 跟 MSVC 之間共有的只有 C 呼叫慣例。std::string、std::vector 或 C++ 例外都帶著屬於特定編譯器與特定 runtime 程式庫的記憶體版面與堆疊展開模型,讓任何一個跨進 Pascal 程式碼,下場就是堆疊損毀,或堆積區塊被錯的配置器釋放
ABI 版本 1 是一份很短的規則清單。每個 export 都是 cdecl、回傳 int32_t 狀態碼:1 成功、0 失敗。每個可能失敗的函式都收一個歸呼叫方所有的診斷緩衝區與位元組容量,DLL 寫入 NUL 結尾的 UTF-8 訊息、超長就截斷。DLL 內部,每個 export 本體都包在 try 裡,同時掛 catch (const std::exception &) 與 catch (...):ONNX Runtime 錯誤、OpenCV 斷言或畸形字典,都變成狀態 0 加訊息
| Export | 角色 | 配接器何時解析 |
|---|---|---|
HPDFRapidOCRAbiVersion | 回傳 1;其他值一律拒收 | DLL 載入後立刻 |
HPDFRapidOCRCreate | 載入偵測、可有可無的分類、辨識模型與字典 | 工廠裡 |
HPDFRapidOCRRecognize | 跑一張點陣圖,每行文字回呼一次 | 工廠裡 |
HPDFRapidOCRDestroy | 釋放模型實體 | 工廠裡 |
HPDFRapidOCRSetReadingDirection | 可有可無的由右至左列序 | 只在設了 RightToLeft 時 |
讀向 export 刻意延遲解析,讓沒有它的 DLL 建置照樣服務所有由左至右的請求。配接器用 LoadLibraryEx 載入程式庫,搜尋旗標涵蓋 DLL 自己的資料夾與預設的安全目錄;放在 HotPDFRapidOCR.dll 旁邊的 ONNX Runtime 或 OpenCV 相依不必改 PATH 就找得到。模型與字典路徑以 UTF-8 跨界,DLL 在用寬字元 API 開檔之前先用嚴格模式的 MultiByteToWideChar 轉換——C:\Users\Łukasz 這種模型目錄或西里爾使用者名稱照樣正常開啟
有一條規則藏在建置檔裡而非標頭檔。DLL 靜態連結 ONNX Runtime 與 OpenCV,CMake 專案預設靜態 release CRT(/MT)。混進用 /MD 編的靜態程式庫,運氣好吃到連結錯誤,運氣不好得到兩座互不相通的堆積。請準備與 DLL 相同 CRT 模式的程式庫
從 TBitmap 到一行文字之間發生了什麼?
HotPDF 把渲染頁的一份獨立 top-down BGR 複本交給 DLL,DLL 對每個辨識出的行回呼一次。回呼裡的文字是借來的:指標只在回呼返回前有效,所以配接器當場複製
Delphi 上,快照來自強制 pf24bit 的私有 TBitmap,用負 biHeight 的 GetDIBits 讀出:得到由上而下的行、補齊四位元組對齊,stride 以明確參數傳給 DLL。FPC 上配接器走 CreateIntfImage 讀取。呼叫方的點陣圖絕不會被改動。大小檢查在配置複本之前就跑:單邊至多 32,767 像素,總量不超過 MaxPixels——預設 16,777,216,可提到 67,108,864
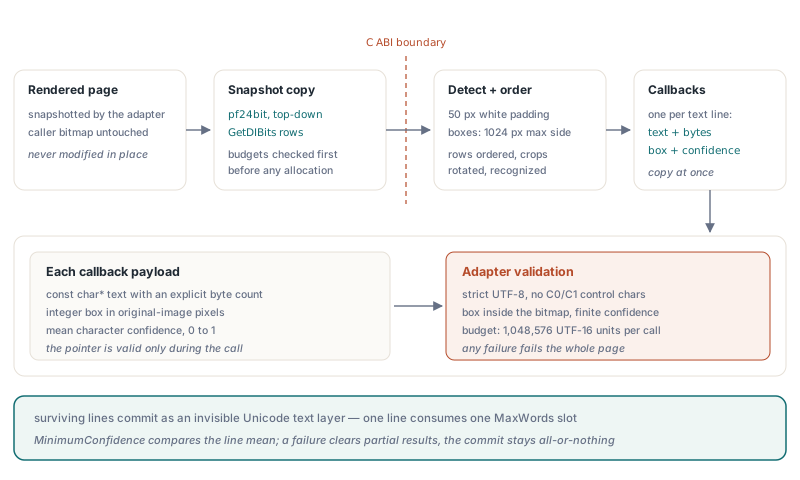
DLL 內部,影像先補 50 像素白邊,文字區域偵測時長邊縮到至多 1,024 像素,框再排成水平列。開啟角度分類器時,只有上下顛倒分數超過 0.9 才把裁切區轉 180 度,免得弱預測把短詞翻面。每一行最後以 const char*、位元組數、原圖像素座標的整數框與平均字元信賴度抵達。配接器對收下的東西很嚴:
- UTF-8 用
MB_ERR_INVALID_CHARS解碼,畸形位元組序列讓整頁失敗,而不是把替換字元種進可搜尋層 - C0 與 C1 控制字元一律拒收;只有空白的行直接跳過
- 框必須落在點陣圖內,信賴度必須是 0 到 1 之間的有限值
- 文字計入該次請求的
MaxTextCodeUnits,每次呼叫硬上限 1,048,576 個 UTF-16 單元;Basic Multilingual Plane 之外的字元一個算兩個 - 回呼裡的 Pascal 例外會被當場接住、存起來、轉成回傳 0,DLL 於是停手;存下的訊息成為
Info.Diagnostic
調輸出時,這些細節裡有兩個要留意。單位是行、不是詞:每行占一個 MaxWords 名額,Info.AcceptedWordCount 與 Info.DroppedWordCount 數的都是行,搜尋命中亮出的是整行的框。MinimumConfidence 比的是整行的平均字元信賴度,二十個乾淨字元裡混一個糊掉的,很少拖垮整行。把門檻提高到 0.7 或 0.8,丟的是整行、從來不是單一字元。空白頁以零行成功收場;任何失敗都丟棄部分結果,多頁提交保持全有或全無
一顆引擎、一份模型、一次一位呼叫者
每顆 RapidOCR DLL 引擎終生只擁有一份模型實體,該引擎上的 Recognize 呼叫由 critical section 排隊串行。握住 IHPDFOCREngine 參照,模型才留在記憶體裡;所以批次作業應該建一次引擎、跨所有文件重複使用
procedure OcrBatch(const Files: TStrings; const OutputDir: string);
var
  Models: THPDFRapidOCRDLLOptions;
  Engine: IHPDFOCREngine;
  Doc: THotPDF;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
  I: Integer;
begin
  Models := THPDFRapidOCRDLLOptions.ForLanguage('ru-RU');
  Models.UseAngleClassifier := False;    // 正立的掃描件:不載分類器模型
  Models.Threads := 4;                   // 1..64,收斂到作用中的處理器數
  Models.TimeoutMilliseconds := 120000;  // 每筆 Recognize 呼叫,合作式
  Engine := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models', Models);
  Options := THPDFOCRTextLayerOptions.Default;
  for I := 0 to Files.Count - 1 do
  begin
    Doc := THotPDF.Create(nil);
    try
      Doc.AutoLaunch := False;
      if (Doc.LoadFromFile(Files[I]) > 0) and
        Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
        Doc.SaveLoadedDocument(IncludeTrailingPathDelimiter(OutputDir) +
          ExtractFileName(Files[I]))
      else
        Writeln(Files[I], ': ', string(Info.Diagnostic));
    finally
      Doc.Free;
    end;
  end;
end;  // 最後一個參照釋放:模型銷毀,DLL 接著卸載
Threads 同時設定引擎裡每個 ONNX session 的 intra-op 與 inter-op 執行緒數,DLL 會把它收斂到作用中的處理器數。兩個執行緒共用一顆引擎,推論永遠不並行;第二個只能等。但這個等不是瞎等 EnterCriticalSection:配接器用 TryEnterCriticalSection 嘗試取鎖、每次嘗試之間睡 25 ms,並且每次都檢查取消權杖與期限,排隊中的請求照樣能取消
期限時鐘在進 Recognize 當下、還沒取鎖之前就起跳。排在別頁後面等待的時間照樣計入 TimeoutMilliseconds。四個 worker 執行緒共用一顆引擎、期限 60 秒時,第四頁可能根本沒碰到模型就逾時。正確做法是給每個 worker 自己的引擎:代價是每顆引擎一份模型副本,而這份記憶體換來可預期的逾時與真並行;只有請求少到幾乎不會排隊時,共用引擎才說得過去
原生 OCR 呼叫為什麼無法在推論中途被殺掉?
原生 RapidOCR 呼叫無法在推論中途被殺,因為它跑在您的執行緒上、您的行程裡,正在一個對執行中的 Run 沒有中斷 API 的 ONNX Runtime session 中間。DLL 配接器的取消是合作式的:DLL 在偵測前後、每個裁切區分類之後、每行辨識完成之後呼叫 abort 回呼,在回呼回傳 0 的第一個檢查點停手。已經開跑的那次 Run 會先跑完
強硬手段比等待更糟。TerminateThread 會讓 CRT 堆積鎖、ONNX Runtime 的執行緒池、所有 OpenCV 狀態停在事發當下的任意樣子;呼叫還在執行時 FreeLibrary,等於把堆疊上的程式碼直接卸載。兩者都沒有安全的做法,配接器因此一概不碰。到期的期限以 otlsEngineError 回來、帶逾時診斷;被取消的權杖以 otlsCancelled 回來:
// 權杖由呼叫方建立,與 UI 執行緒共用,
// 使用者按下 Stop 時由 UI 執行緒呼叫 Token.Cancel
function OcrWithStop(Doc: THotPDF; const Engine: IHPDFOCREngine;
  Token: THPDFCancellationToken): Boolean;
var
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  Options := THPDFOCRTextLayerOptions.Default;
  Options.CancellationToken := Token;
  Result := Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info);
  if not Result then
    case Info.Status of
      otlsCancelled:
        // 在下一個階段或行檢查點停手;文件不變
        Writeln('Cancelled');
      otlsEngineError:
        // 含合作式期限逾期與原生診斷
        Writeln('Engine: ', string(Info.Diagnostic));
      otlsBudgetExceeded:
        // 觸及 Options 裡的頁面、像素、詞或內容上限
        Writeln('Budget: ', string(Info.Diagnostic));
    else
      Writeln(string(Info.Diagnostic));
    end;
end;
這就是行程配接器與行程內 DLL 之間真正的取捨,沒有哪一邊贏下每一列:
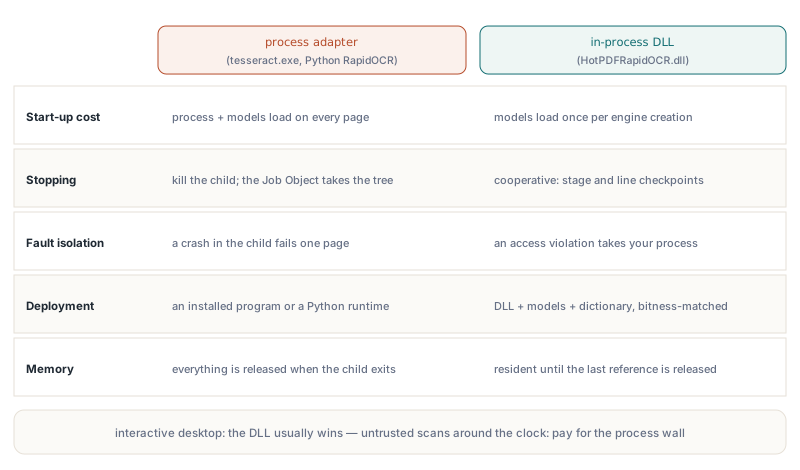
- 啟動成本:Tesseract 與 Python RapidOCR 配接器每頁起一個行程、載一次模型;DLL 每顆引擎只載一次
- 停手:子行程可以直接終止,Python worker 還跑在關閉即殺的 Job Object 裡、整棵行程樹一起走;DLL 只能在階段與行邊界停
- 故障隔離:
tesseract.exe崩潰只賠一頁;DLL 裡的存取違規把您的整個行程帶走 - 部署:行程配接器要一套裝好的程式或 Python 環境;DLL 只要它自己、它的模型與字典,且位元數要跟應用程式匹配
- 記憶體:行程配接器在子行程退出時全部歸零;DLL 引擎的模型常駐到最後一個介面參照釋放
一次 OCR 一頁、需要一個能在一個推論階段內回應的靈敏 Stop 按鈕的互動式桌面應用,選 DLL。全天吞不可信掃描件的伺服器,付每頁啟動成本、保留行程邊界:一張刻意構造、會讓辨識器崩潰的影像應該只賠一頁——有子行程時,它確實只賠一頁
建置 HotPDFRapidOCR.dll 與挑選模型
HotPDFRapidOCR.dll 從 Native/RapidOCR 的 C++ 原始碼建出來,用 MSVC、C++17、Windows SDK 與 CMake 3.20 以上。tools/Build-HotPDFRapidOCR.ps1 輔助腳本收原生原始碼、ONNX Runtime 與 OpenCV 目錄,外加 -Platform Win32 或 Win64,結果寫到 Lib/Native/RapidOCR/<Platform>/。兩種位元數都出貨就兩種都建:32 位元的 Delphi 應用載不了 64 位元 DLL,而您準備的靜態程式庫同時要對上目標架構與 CRT 模式
模型有自己的相容規則。偵測器是 DB 文字偵測器;辨識器接受 NCHW 版面、固定輸入高度 32 或 48 的 CTC 模型,模型宣告動態高度時按 48 執行。模型格式必須是靜態連結的 ONNX Runtime 讀得了的版本;PP-OCRv5 這類較新的匯出可能要求較新的 runtime,讀不了的模型在初始化時失敗並附診斷訊息。tools/Install-RapidOCRModels.ps1 安裝 PP-OCRv3 與 PP-OCRv4 模型包,全部對著釘死的 SHA256 雜湊驗過,偵測器與分類器以 Default 期望的檔名共用。除非 runtime 建置也在您手上,否則留在這些模型包上
字典必須是無 BOM 的 UTF-8、順序與模型的字元順序完全一致,條目數必須等於模型的輸出類別數。CRLF 換行沒問題。模型在 metadata 裡自帶字元清單時,模型初始化會逐條逐位比對字典檔——長度恰好正確的字典照樣過不了。DLL 絕不替缺模型下載
HotPDF 把原生 RapidOCR 配接器、行程式 OCR 配接器、餵養它們的頁面渲染器與隱形 Unicode 文字層寫入器全部打包,收在單一原生 VCL 元件裡,供 Delphi 與 C++Builder 使用。對要在沒裝 Python 的機器上產出可搜尋 PDF 的擷取與檔案庫軟體,HotPDF Delphi PDF component 讓您只需要部署 DLL 與它的模型檔