拿一份俄文發票餵給載入了西里爾模型、卻還在讀中文字典的辨識器,回來的是一排排完全合法的漢字。每一行都是格式完好的 UTF-8,每一行都進了可搜尋文字層,而搜尋頁面上印著的任何詞都找不到結果。模型本身沒失職:CTC 辨識器從不輸出字元,只輸出類別編號,把類別 1,204 對應到字形的唯一憑據就是那份字典檔
還有三種相鄰的故障,拉丁字母的示範一個都碰不到:每一行丟掉最後一個字元、英文文字回來沒有詞間空格、阿拉伯文文字框按由左至右的順序返回。每一種都能追溯到某條字典規則、某個迴圈邊界或某種排序——都容易做到「幾乎正確」。連同開頭那個,四種故障的起點是同一處:把語言標籤變成模型加字典的那一步
HotPDF 的 RapidOCR 語言預設:一個標籤、一組釘死的配對
在 HotPDF 裡,THPDFRapidOCRDLLOptions.ForLanguage 把語言標籤變成指向模型目錄底下 <profile>/recognition.onnx 與 <profile>/dictionary.txt 的選項。其餘設定全部來自 THPDFRapidOCRDLLOptions.Default:共用的偵測器、可有可無的角度分類器、單一執行緒、每次請求 16,777,216 像素的預算,以及 60 秒逾時。標籤會轉小寫、底線換成連字號、前後空白去除,所以 'zh_TW'、'ZH-tw' 與 ' zh-tw ' 都解析到同一個設定檔
比對是對著一份明列的別名清單進行,沒有前綴比對。'zh-Hant-TW' 與 'zh-MO' 會被接受,因為它們名列其中;'pt-AO' 就不行,ForLanguage 在開啟任何檔案之前就丟出 EArgumentException。這麼嚴是有意的:前綴規則會悄悄把 'zh-Hant-SG' 或某個未來的標籤送去共用前兩個字母的設定檔,而中文光靠前兩個字母根本判不出文字系統
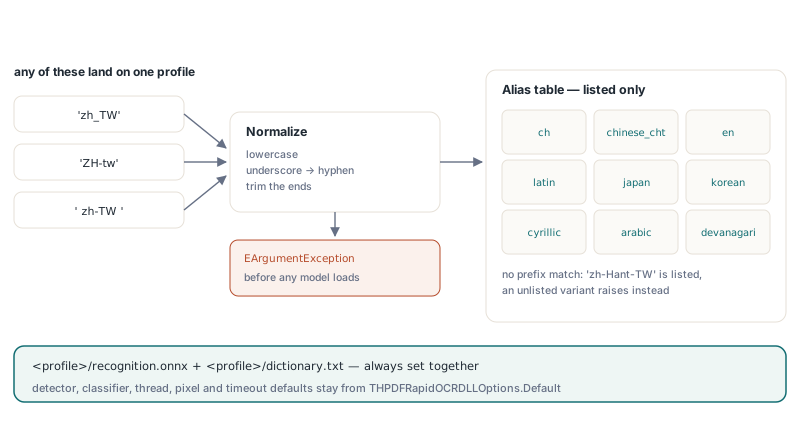
| 設定檔 | 語言 | 範例標籤 | 一列內的框順序 |
|---|---|---|---|
ch | 簡體中文與英文 | zh, zh-CN, zh-Hans, chi_sim | 由左至右 |
chinese_cht | 繁體中文 | zh-TW, zh-HK, zh-Hant, chi_tra | 由左至右 |
en | 英文 | en, en-US, en-GB, eng | 由左至右 |
latin | 法文、德文、西班牙文、葡萄牙文、義大利文、荷蘭文、土耳其文 | fr, de, es-419, pt-BR, tr | 由左至右 |
japan | 日文 | ja, ja-JP, jpn | 由左至右 |
korean | 韓文 | ko, ko-KR, kor | 由左至右 |
cyrillic | 俄文、烏克蘭文、保加利亞文、白俄羅斯文 | ru, ru-RU, uk, bg | 由左至右 |
arabic | 阿拉伯文、波斯文、烏爾都文 | ar, ar-SA, fa, ur | 由右至左 |
devanagari | 印地文、馬拉地文、尼泊爾文 | hi, mr, ne | 由左至右 |
配接器本身什麼都不下載。模型檔用隨附的輔助腳本備妥一次即可,例如 tools/Install-RapidOCRModels.ps1 -Destination C:/OCR/models -Language ch,chinese_cht,cyrillic,九個設定檔全裝則用 -Language All。輔助腳本會把共用的偵測器與分類器放到 Default 期望的根檔名上,各設定檔各占一個資料夾。引擎建立、DLL 邊界與執行緒議題在行程內 RapidOCR DLL 那篇文章裡有完整說明;檔案備妥後,一份簡體中文掃描件就能這樣變成可搜尋
uses
  SysUtils, HPDFDoc, HPDFRapidOCRRecognition;

procedure MakeChineseScanSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Models: THPDFRapidOCRDLLOptions;
  Layer: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // ch/recognition.onnx + ch/dictionary.txt,共用偵測器與分類器
  Models := THPDFRapidOCRDLLOptions.ForLanguage('zh-CN');
  // 模型在這裡載入;引擎請跨文件重複使用
  Engine := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models', Models);
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Layer := THPDFOCRTextLayerOptions.Default;  // 300 DPI、MinimumConfidence 0.5
    // 空頁面清單 = 每一頁;SkipPagesWithText 不動已有文字的頁面
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Layer, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' lines, ', Info.UniqueScalarCount, ' distinct characters');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;
那段輸出有兩個數字得仔細讀。原生管線每個偵測到的文字行回報一筆結果,所以這裡的 AcceptedWordCount 數的是行數;MinimumConfidence 拿來跟整行字元信賴度的平均值比,平均只有 0.45 的行會整行丟棄。UniqueScalarCount 是文字層必須映射進字型與 ToUnicode 表的不同 Unicode 純量個數。中文內文頁應該把這個數字推到遠超過拉丁頁面所需的那幾十個;中文掃描件跑出拉丁等級的數字,通常代表載錯了設定檔
只換辨識模型為什麼會生出亂碼?
因為模型和字典是同一張查找表的兩半,只有字典知道那些索引是什麼意思。RecognitionModel 指到 cyrillic/recognition.onnx、CharacterDictionary 卻還寫著中文檔,模型吐出來的西里爾索引個個合法,舊字典卻把它們翻成隨機漢字。ForLanguage 永遠一起設定這兩個欄位;手工組出來的選項也該守同一條規矩:兩個要動就一起動
最直覺的防護——拿字典大小對模型輸出寬度——必要但仍不夠。兩份字典可以條目數相同、順序不同,錯位一個,每個字元就跟著平移一位。所以 HotPDF 的 RapidOCR DLL 在工廠初始化辨識器時查兩次:模型輸出類別數必須等於字典條目數加二;接著若 ONNX 檔內嵌 character metadata 清單,再逐行比對字典。任一項失配都會讓 HPDFCreateRapidOCRDLLOCREngine 帶著原生診斷訊息丟出 EInvalidOperation——問題在啟動當下就浮上來,而不是埋在客戶的檔案庫裡
「加二」來自類別版面:類別 0 是 CTC blank,類別 1 到 N 是按檔案順序排的字典行,最後一個類別是空格。有些字典自己就帶一個單一空格條目,那行必須原封不動保留下來。這裡好心的 Trim 會闖真禍:它把空格條目修成空字串,整張表跟著平移或搖壞。DLL 會去掉檔尾的 CR 讓 CRLF 檔載得進來,並拒收 UTF-8 位元組順序記號、空行,以及含 tab 或殘留 CR 的條目
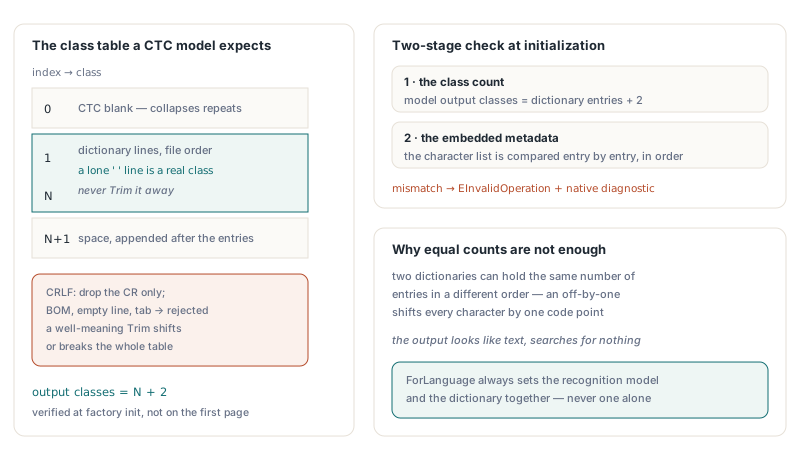
字典是自己維護的話,在建置或部署腳本裡放一道事前檢查,這些問題就能在引擎開口之前被抓出來。下面的函式是您自己的程式碼,照上面的規則寫成
// 您自己的輔助函式,不是 HotPDF API:照 CTC 辨識器的期望建類別表,
// 並拒收 DLL 會拒收的字典缺陷
uses
  SysUtils, IOUtils;

function BuildCTCClassTable(const FileName: string): TArray<string>;
var
  Text, Entry: string;
  Lines: TArray<string>;
  I, Last: Integer;
begin
  Text := TEncoding.UTF8.GetString(TFile.ReadAllBytes(FileName));
  if (Text <> '') and (Text[1] = #$FEFF) then
    raise EArgumentException.Create('Dictionary must be UTF-8 without a BOM');
  Lines := Text.Split([#10]);
  Last := High(Lines);
  if (Last >= 0) and (Lines[Last] = '') then
    Dec(Last);                                   // 檔尾的換行
  if Last < 0 then
    raise EArgumentException.Create('Dictionary is empty');
  SetLength(Result, Last + 3);
  Result[0] := '';                               // 類別 0:CTC blank
  for I := 0 to Last do
  begin
    Entry := Lines[I];
    if (Entry <> '') and (Entry[Length(Entry)] = #13) then
      SetLength(Entry, Length(Entry) - 1);       // CRLF:只去掉 CR
    if (Entry = '') or (Pos(#9, Entry) > 0) or (Pos(#13, Entry) > 0) then
      raise EArgumentException.CreateFmt('Invalid dictionary line %d', [I + 1]);
    Result[I + 1] := Entry;                      // 絕不 Trim:' ' 是一個類別
  end;
  Result[Last + 2] := ' ';                       // 最後一個類別:空格
  // Length(Result) 必須等於模型輸出類別數
end;
Greedy CTC 解碼與它的三個邊界陷阱
Greedy CTC 解碼在每個時間步挑分數最高的類別、把連續重複塌縮成一個字元、丟掉 blank。靠 blank,真正疊字的字母才活得下來。辨識模型把一行文字讀成一串窄窄的垂直切片,每個切片對每個類別各給一個機率。一行 AA中 可能產生 A A blank A 中 space 這樣的 argmax 序列:前兩個 A 步塌縮成一個,blank 把它跟下一個 A 隔開,輸出就是 AA中 ,結尾空格原樣保留。沒有 blank 規則,book 和 bok 會解碼出同一個結果
解碼器一短,邊界差一就特別容易犯,而且每種錯各有自己認得出來的症狀。內層 argmax 迴圈少跑一個類別,空格類別就永遠贏不了,每行英文或拉丁文回來都黏成一根長詞,片語搜尋跟著失效。外層迴圈少跑一個時間步,每行最後一個字元憑空消失,兩個字的標籤等於丟了一半文字。忘了讓 blank 重置重複防護,疊字就塌掉:hello 裡的 ll、或疊詞 谢谢。要給自訂管線寫解碼器,這三種案例正好湊成一組精簡測試集。HotPDF 的解碼器涵蓋最後一個類別與最後一個時間步、保留以 blank 分隔的重複,並拒收不是有限值或落在 0 到 1 之外的分數,類別數對不上字典也一樣拒收
// 自訂管線的解說範例,不是 HotPDF API:邊界正確的 greedy CTC 解碼。
// Scores 存 Steps * Classes 個機率,
// 每個時間步一列
function GreedyCTCDecode(const Scores: array of Single;
  Steps, Classes: Integer; const Characters: array of string): string;
var
  Step, C, Best, Previous: Integer;
  BestScore: Single;
begin
  if (Classes < 3) or (Length(Characters) <> Classes) or
    (Length(Scores) <> Steps * Classes) then
    raise EArgumentException.Create('Model output does not match the dictionary');
  Result := '';
  Previous := 0;                            // 類別 0 是 CTC blank
  for Step := 0 to Steps - 1 do             // 涵蓋最後一個時間步
  begin
    Best := 0;
    BestScore := Scores[Step * Classes];
    for C := 1 to Classes - 1 do            // 涵蓋最後一個類別(空格)
      if Scores[Step * Classes + C] > BestScore then
      begin
        Best := C;
        BestScore := Scores[Step * Classes + C];
      end;
    if (Best <> 0) and (Best <> Previous) then
      Result := Result + Characters[Best];
    Previous := Best;                       // blank 會重置重複防護
  end;
end;
帶語言模型的 beam search 能救回一些 greedy 解碼判錯的曖昧切片,代價是實實在在的速度,外加第二組要管版本的檔案。對 300 DPI 渲染的印刷文件,greedy 解碼是正確的預設;模型看不到的東西,也不該靠解碼器補救。字元替換表同理:模型把帶音調符號的字母讀成基礎字母時,拿替換表去補輸出,救了一種語言、壞了另一種。可搜尋層裡一個錯字比一個缺字更糟——搜尋會找錯文件,而不是找不到文件——所以辨識出的文字照模型產出的樣子原樣進 PDF
由右至左的阿拉伯文,文字行怎麼排序?
DLL 把偵測到的文字框由上而下排序,垂直重疊達較小框高一半以上的框併成同一列,每列再由左至右排序;設了 RightToLeft 就改由右至左。已辨識行內的字元永遠不會反向。列分組要緊,因為偵測器常把一條視覺行拆成好幾個框——例如標籤與值中間隔著一大段空隙——只按上緣座標排序的話,兩個框只要上緣差一兩個像素,就會跟下一行穿插在一起
阿拉伯文是唯一讓 ForLanguage 設 RightToLeft := True 的設定檔:DLL 改按各框右緣排序、從右邊界起算。效果僅此而已。模型對一行回傳的文字早已是 Unicode 邏輯順序——阿拉伯讀者閱讀與輸入的順序,也正是 PDF 文字擷取與搜尋所期望的順序。為了在 Delphi 偵錯器裡「看起來正常」而把字串反向,會弄壞搜尋、複製貼上與螢幕閱讀器。雙向顯示與字形整形是 PDF 檢視器的職責
一顆引擎服務一種語言設定檔,也沒有自動的文字系統偵測。混用文字系統的文件,每種設定檔一顆引擎,各套各的頁面。ApplyLoadedOCRTextLayer 接受明確的頁面清單,每次呼叫自成一個交易;阿拉伯文頁面失敗時,回滾的是那次呼叫,已寫好的中文層不受波及
uses
  SysUtils, HPDFDoc, HPDFRapidOCRRecognition;

function CreateRapidEngine(const Tag: string): IHPDFOCREngine;
var
  Models: THPDFRapidOCRDLLOptions;
begin
  // 沒列在清單上的標籤丟 EArgumentException,在任何模型載入之前
  Models := THPDFRapidOCRDLLOptions.ForLanguage(Tag);
  Models.MaxPixels := 33554432;          // 給 300 DPI 的 A3 頁面留餘裕
  Result := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models', Models);
end;

procedure OCRMixedArchive(Doc: THotPDF);
var
  Chinese, Arabic: IHPDFOCREngine;
  Layer: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  Chinese := CreateRapidEngine('zh-TW');  // chinese_cht 設定檔
  Arabic := CreateRapidEngine('ar-SA');   // arabic 設定檔,RightToLeft = True
  Layer := THPDFOCRTextLayerOptions.Default;
  if not Doc.ApplyLoadedOCRTextLayer([0, 1, 2], Chinese, Layer, Info) then
    raise Exception.Create(string(Info.Diagnostic));
  if not Doc.ApplyLoadedOCRTextLayer([3], Arabic, Layer, Info) then
    raise Exception.Create(string(Info.Diagnostic));
end;
MaxPixels 那行不是白寫的。每次請求 16,777,216 像素的預設預算,跑 300 DPI 的 A4 與 US Letter 綽綽有餘;A3 在 300 DPI 約 3508 × 4961 像素、將近 1,740 萬,這種請求會被拒絕,Info.Diagnostic 回報請求無效或像素預算不足。把 MaxPixels 提到 67,108,864 上限,或為大格式調低 THPDFOCRTextLayerOptions.DPI。由右至左排序走的是 DLL 匯出函式 HPDFRapidOCRSetReadingDirection,配接器只在設了 RightToLeft 時才去找它;沒有這個匯出的 DLL 建置照樣服務由左至右的設定檔,而用它建阿拉伯文引擎會丟出 EArgumentException,指名缺哪個匯出
釘死的模型包,以及自訂配對必須通過什麼
HotPDF 的 RapidOCR DLL 靜態連結一份 ONNX Runtime,讀得了這份 runtime 認得的 ONNX 檔案格式版本,更新的格式一概不行。新的模型匯出可能採用更新的格式,這種檔案會在引擎建立時被拒,並附上原生診斷訊息。正是這層配對,讓每個語言包都指向一組確定的辨識器與字典——在隨附 runtime 下載得進來、過得了類別檢查——也讓語言包永遠不標榜「最新」
Install-RapidOCRModels.ps1 在磁碟上強制這層配對。清單裡每個檔案都帶 SHA256 雜湊:既有檔案雜湊不同時,安裝就此打住、檔案原地保留,由您決定搬走或刪除;每個下載先寫到暫存名,雜湊核對通過才歸位。這擋住了字典問題的無聲版本:有人手工把新的 recognition.onnx 複製進設定檔資料夾,類別數恰好對上,第一個警訊卻是客戶反映明明看得見的詞搜尋找不到。用 -SkipClassifier 安裝時,要在選項裡設 UseAngleClassifier := False,因為 Default 預期分類器檔案存在,引擎建立時也會查
辨識器載入時也檢查模型的輸入形狀:接受固定高度 32 或 48 像素的 NCHW float 輸入,也接受動態高度——按 48 執行。固定高度是其他值的模型,引擎建立會失敗,訊息是「Unsupported recognition model input or output shape」
九個設定檔都蓋不到的文字系統,可以把 RecognitionModel 與 CharacterDictionary 指到自己的檔案,上面的每一項檢查照樣生效——配對失耦會在引擎建立時、也就是您的測試執行裡失敗。RapidOCR 設定檔都套不上的頁面,做可搜尋 PDF 的 Tesseract 配接器接的是同一個 ApplyLoadedOCRTextLayer 呼叫;機器印刷的 ASCII 表單,內建模板比對 OCR 引擎則連模型檔都不需要
語言預設、原生 RapidOCR 配接器與 OCR 文字層,都包含在HotPDF Delphi PDF Component 之內,適用 Delphi、C++Builder 與 Windows 上的 FPC/Lazarus 專案