HotPDF 通过 HPDFCreateTesseractDLLOCREngine 在你的 Delphi 进程内跑 Tesseract——这个 v2.772.0 加入的工厂动态加载 Tesseract 5 兼容 DLL,驱动它的 C API(TessBaseAPIInit2、TessBaseAPIRecognize、结果迭代器),返回一个 IHPDFOCREngine。THotPDF.ApplyLoadedOCRTextLayer 用这个引擎给扫描 PDF 页面加上一层不可见、可搜索的 Unicode 文本
同一个识别器此前也能通过 写 BMP、解析 TSV 的外部 tesseract.exe 适配器用上。那条路能用,但每一页都要为进程启动、临时位图文件和一个没有基线、无法控制页面分割的文本格式付账。调 DLL 三个都免了,同时也免掉了进程墙——这意味着 Pascal 绑定直接坐在 C 结构、C 布尔值和 C 分配的字符串上。这个适配器值得知道的东西,大部分都在「绑定会在哪里悄悄出错」
怎么在 Delphi 里用 HotPDF 进程内跑 Tesseract?
在 Delphi 里用 HotPDF 进程内跑 Tesseract,只需 HPDFTesseractRecognition 单元里的一次工厂调用,加上每个 HotPDF OCR 引擎都用的那个 ApplyLoadedOCRTextLayer。工厂迫不及待地校验:DLL 文件与 tessdata 目录必须存在,语言标识符只能含 ASCII 字母、数字、_ 和 +,chi_sim+eng 这类组合里的每个模型都得有对应的 .traineddata 文件,全部 21 个必需导出必须可解析,然后才返回引擎。配置错误抛 EArgumentException;DLL 加载失败抛 EOSError,带 Windows 错误码和一条「检查位数与依赖」的提示
uses
  SysUtils, HPDFDoc, HPDFTesseractRecognition;

procedure MakeSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // Win64 应用需要 64 位 DLL;依赖 DLL 放它旁边
  Engine := HPDFCreateTesseractDLLOCREngine('C:\OCR\Win64\libtesseract-5.dll',
    'C:\OCR\tessdata', 'chi_sim+eng');   // THPDFTesseractOptions.Default
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default;   // 300 DPI,MinimumConfidence 0.5
    // 空页面列表表示全部页面;已有文本的页面跳过
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' words accepted, ', Info.DroppedWordCount, ' dropped');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;
THPDFTesseractOptions.Default 把 PageSegMode 设为 tpsAuto,EngineMode 设为 temDefault,TimeoutMilliseconds 设为 60,000,MaxPixels 设为 16,777,216。像素预算比看上去要紧。US Letter 页面在默认 300 DPI 下渲染成 2,550 × 3,300 像素、约 840 万,装得下。同一页 600 DPI 就是 5,100 × 6,600、约 3,370 万,适配器在 Tesseract 见到第一个像素之前就拒收。要么调高 MaxPixels(上限 67,108,864),要么保持 DPI 不动;每一维也另有 32,767 像素的上限
DLL 用 LoadLibraryEx 加载,搜索标志覆盖 DLL 自身文件夹加默认安全目录,所以 Tesseract 依赖的图像库可以放在它旁边,不用碰 PATH 或当前目录。HotPDF 不捆绑、也不下载任何 OCR 运行时或模型;两者都由你准备
与 tesseract.exe 适配器相比有什么不同?
DLL 适配器拿进程隔离换来更丰富的输出和更低的每页开销。两个适配器接进同一条文本层流水线,坐标映射、置信度过滤和全有或全无提交完全一致;不同的只是像素怎么进、词怎么出
| 维度 | tesseract.exe 适配器 | Tesseract DLL 适配器 |
|---|---|---|
| 工厂 | HPDFCreateTesseractOCREngine | HPDFCreateTesseractDLLOCREngine |
| 像素输入 | 私有临时目录里的 BMP 文件 | 内存中的 8-bit 灰度缓冲 |
| 词输出 | 词级 TSV,上限 64 MiB | 结果迭代器,每词 UTF-8 |
| 基线 | 不可用 | 从 TessPageIteratorBaseline 透传 |
| 页面分割与引擎模式 | 仅自动分割 | THPDFTesseractPageSegMode、THPDFTesseractEngineMode |
| 超时 | 硬超时:终止子进程 | 协作式:Tesseract 得自己察觉 |
| 崩溃与内存隔离 | 独立进程 | 没有,共享你的地址空间 |
有一项成本没有消失。每次 Recognize 调用都创建自己的 API 实例并调用 TessBaseAPIInit2,语言模型因此按页初始化,而不是每引擎一次。操作系统文件缓存能缓解重载,但在大型多语言模型集上它仍是每页主要的固定成本,而且计入识别期限。进程内 RapidOCR DLL 引擎取的是相反的设计,ONNX 模型在引擎生命周期内常驻;边界问题(C ABI、借用缓冲、不可打断的原生工作)则是同一族
为什么 Delphi 不能照抄 Tesseract 的 monitor 结构体?
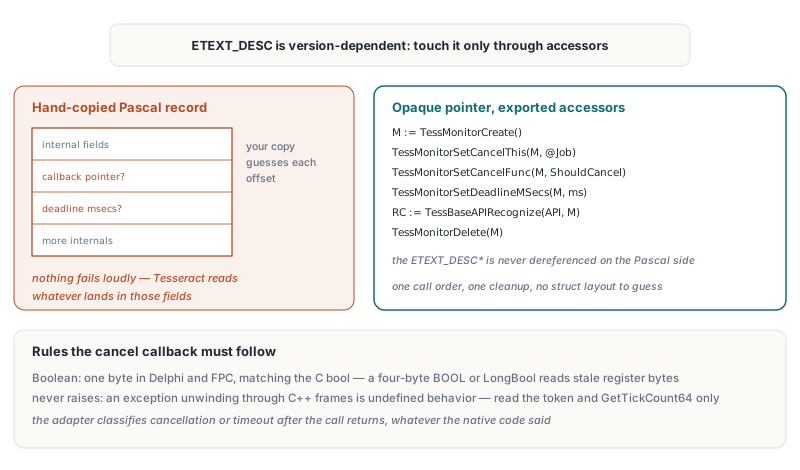
Delphi 无法安全镜像 Tesseract 的进度 monitor,因为 ETEXT_DESC 里有随版本变化的内部字段,手工抄的记录在某些构建上会把取消回调和期限放到错误的偏移。出事时没有任何东西大声失败。Tesseract 只是从一个现在装着别的东西的字段里读你的回调指针,或者压根没看到期限
所以 HotPDF 把 monitor 当不透明指针,只经导出函数碰它:TessMonitorCreate、TessMonitorSetCancelThis、TessMonitorSetCancelFunc、TessMonitorSetDeadlineMSecs 和 TessMonitorDelete。你出于别的原因自己绑 C API,同样的模式照用。下面的示意是你自己的绑定代码,不是 HotPDF API,与 HotPDF 内部用的声明一致
type
  // C: typedef bool (*TessCancelFunc)(void *cancel_this, int words);
  TTessCancelFunc = function(CancelThis: Pointer; Words: Integer): Boolean; cdecl;
  TTessMonitorCreate = function: Pointer; cdecl;   // ETEXT_DESC*,永不解引用
  TTessMonitorDelete = procedure(Monitor: Pointer); cdecl;
  TTessMonitorSetCancelFunc = procedure(Monitor: Pointer; Func: TTessCancelFunc); cdecl;
  TTessMonitorSetCancelThis = procedure(Monitor, CancelThis: Pointer); cdecl;
  TTessMonitorSetDeadlineMSecs = procedure(Monitor: Pointer; MSecs: Integer); cdecl;
  TTessBaseAPIRecognize = function(Handle, Monitor: Pointer): Integer; cdecl;

  TOCRJob = record
    CancelRequested: Boolean;
    DeadlineTick: UInt64;
  end;
  POCRJob = ^TOCRJob;

function ShouldCancel(CancelThis: Pointer; Words: Integer): Boolean; cdecl;
begin
  // 跑在 Tesseract 的栈上:只读标志和时钟,绝不抛异常
  Result := (CancelThis = nil) or POCRJob(CancelThis)^.CancelRequested or
    (GetTickCount64 >= POCRJob(CancelThis)^.DeadlineTick);
end;

// 用法,函数指针由 GetProcAddress 解析:
//   Monitor := MonitorCreate();
//   try
//     MonitorSetCancelThis(Monitor, @Job);
//     MonitorSetCancelFunc(Monitor, ShouldCancel);
//     MonitorSetDeadlineMSecs(Monitor, RemainingMs);
//     RC := BaseAPIRecognize(API, Monitor);
//   finally
//     MonitorDelete(Monitor);
//   end;
示意里有两个细节是刻意的。回调返回 Boolean,在 Delphi 和 Free Pascal 里都是一个字节,与 TessCancelFunc 里的 C bool 匹配。四字节的 Windows BOOL 或 Delphi LongBool 看着能互换,其实不能:一边写一个字节、另一边读四个字节时,返回寄存器的高位字节是残留在那里的任意值,false 可能以 true 的面目到达。同一个头文件还火上浇油,因为 TessPageIteratorBoundingBox 这类函数返回 int,HotPDF 声明为 Integer。逐个读返回值的 C 类型,别假设整个 API 一个约定
第二个细节是回调从不抛异常。Delphi 异常穿过 Tesseract 的 C++ 栈帧展开是未定义行为,所以 HotPDF 的回调只读取消令牌和一个单调的 GetTickCount64 值。适配器在 TessBaseAPIRecognize 返回之后把结果转成取消或超时诊断,而且无论原生返回码如何都做这项检查
Delphi 侧拥有哪些原生指针?
HotPDF 的 Tesseract DLL 适配器每个请求拥有三个原生对象——API 实例、monitor 和结果迭代器——其余全部借用。每次 Recognize 调用创建自己的一套,并在 finally 块里按序释放:TessResultIteratorDelete,然后 TessMonitorDelete,然后 TessBaseAPIDelete。释放引擎接口会卸载库
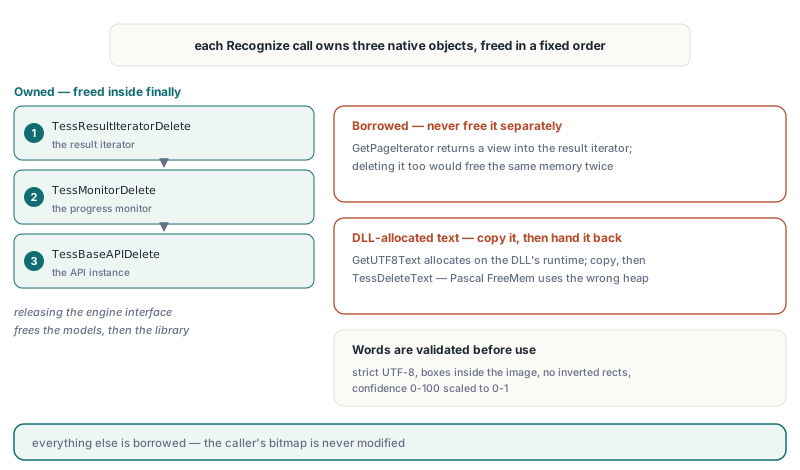
TessResultIteratorGetPageIterator返回的是结果迭代器内部的借用视图,不是新对象。HotPDF 用它做TessPageIteratorBoundingBox和TessPageIteratorBaseline,从不释放;单独删它会释放同一块内存两次TessResultIteratorGetUTF8Text返回 DLL 自己的运行时分配的字符串。HotPDF 拷贝它,并在finally块里经TessDeleteText归还;Pascal 的FreeMem会在错误的堆上释放- 词文本经严格 UTF-8 校验解码并在转换前做长度检查。带控制字符、畸形 UTF-8、框跑出图像、矩形颠倒或置信度落在 0–100 之外的词让整个请求失败,而不是被悄悄修补
- 每次请求的文本总量上限 1,048,576 个 UTF-16 码元,词数必须装得下
ApplyLoadedOCRTextLayer下发的请求预算
置信度以 0–100 到达,缩放到 0–1,所以 THPDFOCRTextLayerOptions.MinimumConfidence 对每个引擎含义一致。Tesseract 报告基线时两个端点都透传;否则文本层流水线回退到几何估算——对 TSV 输入也正是这么做的
枚举进 DLL 之前为什么要校验?
HotPDF 把 PageSegMode 和 EngineMode 的原始序数先拷进 Integer 再做范围检查,因为编译器可能假设枚举变量总持有已声明的值,把 Ord(X) > Ord(High(T)) 折叠成常量 false。序数不是摆设:THPDFTesseractPageSegMode 沿用 Tesseract 0 到 13 的页面分割编号,THPDFTesseractEngineMode 沿用 0 到 3 的引擎模式编号,两者都以普通整数进 DLL。用 FillChar 构建、从流填充、或从 C++Builder 以强转整数传来的选项记录,都可能带着 200 这样的字节。校验拷贝出来的序数,把它变成工厂时刻的 EArgumentException,而不是原生代码里的未定义模式。工厂还拒收不产词的 tpsOSDOnly 和 tpsAutoOnly,并要求 tpsAutoOSD 与 tpsSparseTextOSD 配有 osd.traineddata
识别超时到底保证什么?
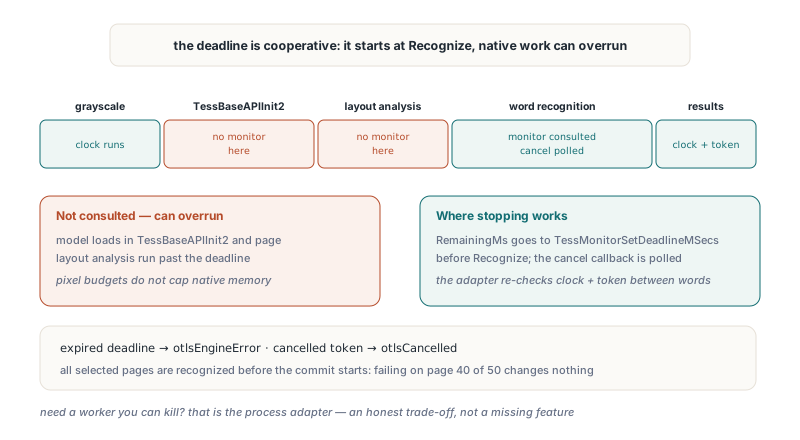
Tesseract DLL 的超时是协作式的:HotPDF 能停下自己的工作、请求 Tesseract 停下,但没法强迫原生代码返回。时钟从 Recognize 开始计时,所以位图转换和模型初始化与识别共享同一份预算。HotPDF 在灰度转换期间和遍历结果的词与词之间检查已用时间与取消令牌,并在调用 TessBaseAPIRecognize 之前把剩余毫秒交给 TessMonitorSetDeadlineMSecs
缝隙在原生调用内部。Tesseract 的 monitor 在词识别期间被查询,在 TessBaseAPIInit2 或页面版面分析期间不会,所以慢的模型加载或病态版面可能在超时被报告之前就跑过期限。像素与输出预算也不约束原生库自己的内存用量。需要一个能杀的 worker,就用进程适配器;这是诚实的取舍,不是缺失的功能
页面分割是 DLL 适配器在困难输入上显本事的地方。字段散落的表单、标签和扫描表格,用 tpsSparseText 往往比自动分割识别得更好——后者总想拼装出根本不存在的栏和段落
procedure OCRFormPages(Doc: THotPDF; const Pages: array of Integer);
var
  Engine: IHPDFOCREngine;
  TessOptions: THPDFTesseractOptions;
  LayerOptions: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  TessOptions := THPDFTesseractOptions.Default;
  TessOptions.PageSegMode := tpsSparseText;  // 字段散落,不拼栏
  TessOptions.EngineMode := temLSTMOnly;     // tessdata 里要有 LSTM 模型
  TessOptions.TimeoutMilliseconds := 20000;  // 含模型初始化
  Engine := HPDFCreateTesseractDLLOCREngine('C:\OCR\Win64\libtesseract-5.dll',
    'C:\OCR\tessdata', 'eng+deu', TessOptions);

  LayerOptions := THPDFOCRTextLayerOptions.Default;
  LayerOptions.MinimumConfidence := 0.6;
  if not Doc.ApplyLoadedOCRTextLayer(Pages, Engine, LayerOptions, Info) then
    case Info.Status of
      otlsCancelled:
        Writeln('OCR cancelled, document unchanged');
      otlsEngineError:
        Writeln('Tesseract failed or timed out: ', string(Info.Diagnostic));
    else
      Writeln(string(Info.Diagnostic));
    end;
end;
超时以 otlsEngineError 浮现,诊断是 Tesseract DLL OCR timed out;取消的令牌以 otlsCancelled 浮现。两种情况下,ApplyLoadedOCRTextLayer 在开始提交事务之前就已识别完所有选中页,所以 50 页中第 40 页失败,加载的文档保持原样。注意 tpsSingleLine、tpsSingleBlock 和 tpsSparseText 只改分割;它们没有一个能拉直倾斜的扫描件
Free Pascal 与 Lazarus:过期像素与丢失的中文
从 v2.772.1 起,经过两个 FPC 专属修复,两个 Tesseract 工厂都能在 Windows Free Pascal 与 Lazarus 的 Win32、Win64 构建里工作。先为目标架构重建 Lazarus 包;通用移植见 HotPDF 在 Free Pascal 与 Lazarus Win64 上
第一个修复关乎像素。LCL 的 TBitmap 经 scanline 写入后可能更新了原始图像却没刷新 Windows 位图句柄,于是在那个句柄上 GetDIBits 返回旧像素。症状一度让人抓狂:直接画到位图上的文字能识别,HotPDF 的 PDF 渲染器渲染出的页面却给出空词表。FPC 侧适配器现在经 CreateIntfImage 读取格式感知的快照,尊重原始图像的像素格式与行序。Delphi 构建在私有 24 位副本上保留 GetDIBits 路径。两个构建都不修改调用者的位图
第二个修复归 tesseract.exe 适配器。FPC 的 TStringList 存 ANSI 字符串,把解码后的 UTF-8 TSV 文本赋给 Lines.Text 会无声丢掉系统 ANSI 代码页表示不了的每个中文或增补平面字符。FPC 路径现在把 TSV 按 UTF-8 字节保存,在字节层面剥掉 BOM,逐词解码成 UnicodeString。DLL 适配器从没这个问题,因为它直接从迭代器逐词解码
速查
- 工厂:
HPDFTesseractRecognition里的HPDFCreateTesseractDLLOCREngine(LibraryPath, TessDataDirectory, Language[, Options]),v2.772.0 加入,FPC 支持在 v2.772.1 - 默认值:
tpsAuto、temDefault、60,000 ms、16,777,216 像素;超时范围 1–3,600,000 ms,像素上限 67,108,864 - DLL 位数与应用匹配,依赖 DLL 放 Tesseract DLL 旁边
- 把 monitor 当不透明指针;绝不把
ETEXT_DESC抄进 Pascal 记录 - 取消回调声明为
cdecl、返回单字节Boolean,绝不让异常逃出它 - 迭代器文本用
TessDeleteText释放;绝不释放从结果迭代器拿到的页面迭代器 - 把期限当协作式的:模型初始化与版面分析可能超期
- 需要硬终止或崩溃隔离时,用 tesseract.exe 适配器
Tesseract DLL 适配器、进程适配器和内置 OCR 引擎都随面向 Delphi、C++Builder 与 Free Pascal 的 HotPDF Delphi PDF 组件交付;版本与下载见 HotPDF 产品页