TerminateThread 看起来是拦下一个 OCR 调用的显然办法——它已经在某一页扫描件上磨蹭得超过了 UI 愿意等的时间。Windows 文档解释了为什么不能这么做:如果目标线程恰握着进程堆锁,这把锁永远不会释放,其他任何线程上的下一次分配都可能永远阻塞。OCR 一旦跑进你自己的进程,唯一安全的停止就是协作式的停止,在推理阶段之间的检查点上收手——这就是「模型只加载一次并保持热身」的代价
大多数 Delphi 团队先试的另一条路是子进程。每页一个 Python worker 随时可以杀掉,这很有吸引力,但每次调用都要启动解释器、导入运行时、加载检测与识别模型,然后才读进第一个像素。假设档案作业有 500 页:这套启动功课要跑 500 遍,部署里也就多了一套与原生可执行文件作伴的 Python 环境
用 HPDFCreateRapidOCRDLLOCREngine 把扫描件变成可搜索 PDF
HotPDF 通过 HPDFCreateRapidOCRDLLOCREngine 在进程内跑 RapidOCR,工厂声明在 HPDFRapidOCRRecognition 单元里。它加载 HotPDFRapidOCR.dll,一次性初始化 ONNX 检测、可选角度分类和识别模型,返回一个 IHPDFOCREngine。这个引擎接进 THotPDF.ApplyLoadedOCRTextLayer 的方式与其他 OCR 引擎完全一样:文档渲染每一页,DLL 在页面上跑 CPU 推理,结果作为一层不可见的 Unicode 文本提交。没有 Python,没有子进程。适配器随 Delphi、C++Builder 与 Windows FPC/Lazarus 构建一起发布
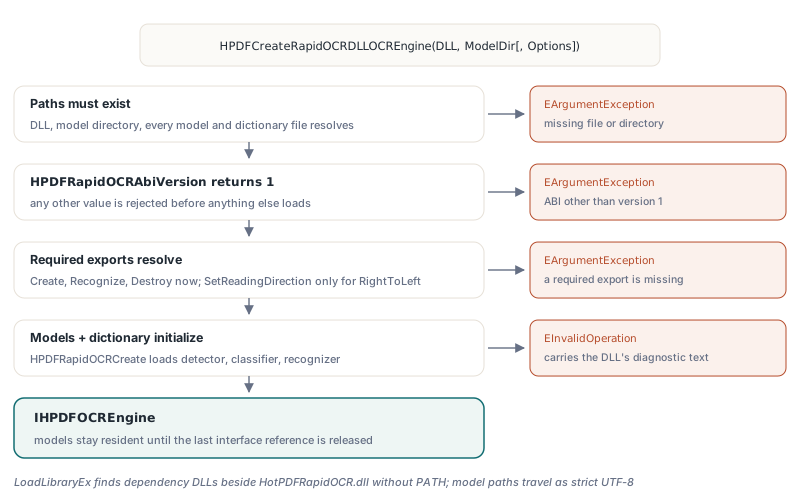
校验发生在工厂里,任何页面都还没碰。每个模型与字典文件必须可解析,HPDFRapidOCRAbiVersion 必须返回 1,必需的导出必须就位,然后 HPDFRapidOCRCreate 才构建模型。配置错误抛 EArgumentException;拒绝加载的模型抛 EInvalidOperation,带上 DLL 自己的诊断,比如与识别模型不匹配的字典
uses
  SysUtils, HPDFTypes, HPDFDoc, HPDFRapidOCRRecognition;

procedure MakeSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // 模型在这里加载,在任何识别期限之外。
  // THPDFRapidOCRDLLOptions.Default 里的相对名字
  // 相对模型目录解析
  Engine := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models');
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default;  // 300 DPI,MinimumConfidence 0.5
    // 空页面列表 = 全部页面;SkipPagesWithText 默认开启
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' lines accepted, ', Info.DroppedWordCount, ' dropped');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;
THPDFRapidOCRDLLOptions.Default 指名 ch_PP-OCRv3_det_infer.onnx、ch_PP-OCRv3_rec_infer.onnx、ch_ppocr_mobile_v2.0_cls_infer.onnx 和 ppocr_keys_v1.txt,单 CPU 线程、16,777,216 像素输入上限、每次识别调用 60,000 ms 期限。其他文字种类用 THPDFRapidOCRDLLOptions.ForLanguage:保留这些默认值,把 <profile>/recognition.onnx 加 <profile>/dictionary.txt 换成九个配置之一的对应文件,从繁体中文、西里尔到阿拉伯语和天城文。每个引擎读一种语言;按页或按文档挑配置。模型与字典为什么总是成对出行,见 HotPDF 的 RapidOCR 多语言模型与 CTC 字典
引擎在 Info.EngineName 里自报 RapidOCR (native DLL)。把这条字符串记进日志:同一个服务还跑着外部 Tesseract OCR 进程适配器或内置模板匹配 OCR 引擎时,这是判断哪个识别器产出了坏页面最快的办法
为什么 C ABI 只说 int32_t 和 UTF-8 字节?
HotPDFRapidOCR.dll 的边界只用定宽整数、裸指针和显式字节长度,因为 Delphi、C++Builder 与 Free Pascal 同 MSVC 之间,除了 C 调用约定之外毫无共享。std::string、std::vector 或 C++ 异常,各自带着只属于某一个编译器、某一个运行时库的内存布局与展开模型;放任何一个跨进 Pascal 代码,结局不是栈被踩烂,就是堆块被错误的分配器释放
ABI 版本 1 是一小串规则。每个导出都是 cdecl,返回 int32_t 状态:1 成功,0 失败。每个可能失败的函数都带一个调用者所有的诊断缓冲区和以字节计的容量,DLL 写入一条 NUL 结尾、按容量截断的 UTF-8 消息。DLL 内部,每个导出函数体都包在 try 里,同时带 catch (const std::exception &) 和 catch (...):ONNX Runtime 错误、OpenCV 断言或畸形字典,一律变成状态 0 加文本
| 导出 | 职责 | 适配器何时解析 |
|---|---|---|
HPDFRapidOCRAbiVersion | 返回 1;其他任何值都被拒收 | DLL 加载后立刻 |
HPDFRapidOCRCreate | 加载检测、可选分类、识别模型与字典 | 在工厂里 |
HPDFRapidOCRRecognize | 跑一幅位图,每个文本行发一个回调 | 在工厂里 |
HPDFRapidOCRDestroy | 释放模型实例 | 在工厂里 |
HPDFRapidOCRSetReadingDirection | 可选的从右到左行序 | 仅当设置了 RightToLeft |
读向导出刻意延迟解析,好让没有它的 DLL 构建照样服务所有从左到右的请求。适配器用 LoadLibraryEx 加载库,搜索标志覆盖 DLL 自身文件夹加默认安全目录,所以放在 HotPDFRapidOCR.dll 旁边的 ONNX Runtime 或 OpenCV 依赖,不用改 PATH 就能找到。模型与字典路径以 UTF-8 过边界,DLL 打开文件之前先用严格模式的 MultiByteToWideChar 转换,再走宽字符 API。C:\Users\Łukasz 下的模型目录、西里尔用户名,都能正常打开
有一条规则活在构建文件里而不是头文件里。DLL 静态链接 ONNX Runtime 和 OpenCV,CMake 工程默认静态 release CRT(/MT)。混进按 /MD 编译的静态库,运气好是链接错误,运气不好是两个互不相认的堆。准备的静态库必须与 DLL 同一种 CRT 模式
从 TBitmap 到文本行之间发生了什么?
HotPDF 交给 DLL 一幅独立的自顶向下 BGR 页面副本,DLL 为每个识别出的行发回一个回调。回调里的文本是借给你的:指针只在回调返回前有效,所以适配器当场拷贝
Delphi 侧,快照来自一个强制 pf24bit 的私有 TBitmap,用负 biHeight 的 GetDIBits 读取:得到自顶向下、按四字节对齐填充的行,步距作为显式参数传给 DLL。FPC 侧经 CreateIntfImage 读取。调用者的位图绝不被修改。尺寸检查在分配副本之前运行:每边至多 32,767 像素,总量不超过 MaxPixels——默认 16,777,216,可提到 67,108,864
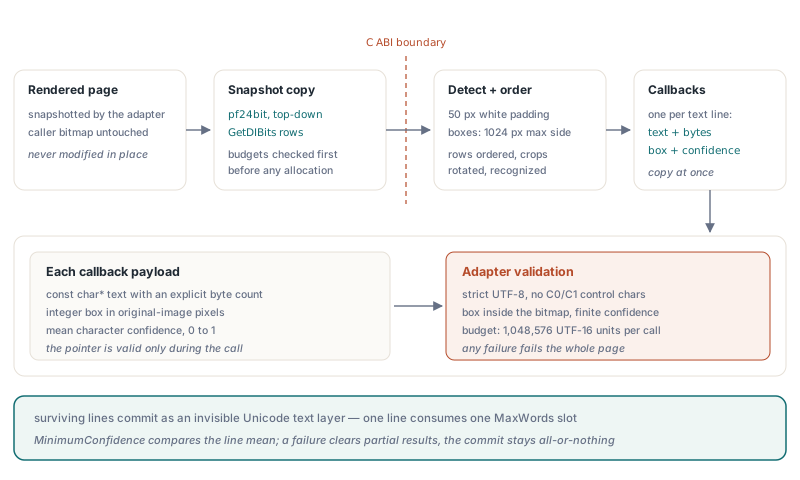
DLL 内部,图像先垫上 50 像素的白边,文本区域以长边最多 1,024 像素检测,框排成水平行。启用角度分类器时,只有倒置得分超过 0.9 的裁切才转 180 度,弱预测不至于掀翻短词。随后每一行以 const char*、字节数、以原图像素计的整数框和平均字符置信度到达。适配器收货很挑剔:
- UTF-8 用
MB_ERR_INVALID_CHARS解码,畸形字节序列让整页失败,而不是往可搜索层里种下替换字符 - C0 与 C1 控制字符拒收;纯空白的行跳过
- 框必须落在位图之内,置信度必须是 0 到 1 之间的有限值
- 文本量按请求的
MaxTextCodeUnits计数,每次调用硬上限 1,048,576 个 UTF-16 单元;基本多文种平面之外的字符算两个单元 - 回调里的 Pascal 异常就地捕获、存储并转成 0 返回,让 DLL 停下;存下的消息成为
Info.Diagnostic
其中两个细节在你调输出时要紧。单位是行不是词:每行占一个 MaxWords 槽位,Info.AcceptedWordCount 和 Info.DroppedWordCount 数的是行,搜索命中高亮整个行框。MinimumConfidence 对照的是行的平均字符置信度,所以二十个干净字符里夹一个涂花的,很少拖垮整行。把阈值提到 0.7 或 0.8,丢的是整行,从来不是单个字符。空白页以零行成功;任何失败都丢弃部分结果,多页提交保持全有或全无
一个引擎,一份模型,一次一个调用者
每个 RapidOCR DLL 引擎终生恰好持有一份模型实例,对该引擎的 Recognize 调用由临界区串行化。握着 IHPDFOCREngine 引用,模型才留在内存里,所以批量作业应当创建引擎一次,跨每个文档复用
procedure OcrBatch(const Files: TStrings; const OutputDir: string);
var
  Models: THPDFRapidOCRDLLOptions;
  Engine: IHPDFOCREngine;
  Doc: THotPDF;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
  I: Integer;
begin
  Models := THPDFRapidOCRDLLOptions.ForLanguage('ru-RU');
  Models.UseAngleClassifier := False;    // 摆正的扫描件:不加载分类器模型
  Models.Threads := 4;                   // 1..64,钳到活动处理器数
  Models.TimeoutMilliseconds := 120000;  // 每次 Recognize 调用,协作式
  Engine := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models', Models);
  Options := THPDFOCRTextLayerOptions.Default;
  for I := 0 to Files.Count - 1 do
  begin
    Doc := THotPDF.Create(nil);
    try
      Doc.AutoLaunch := False;
      if (Doc.LoadFromFile(Files[I]) > 0) and
        Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
        Doc.SaveLoadedDocument(IncludeTrailingPathDelimiter(OutputDir) +
          ExtractFileName(Files[I]))
      else
        Writeln(Files[I], ': ', string(Info.Diagnostic));
    finally
      Doc.Free;
    end;
  end;
end;  // 最后一个引用释放:模型销毁,随后 DLL 卸载
Threads 同时设定引擎里每个 ONNX 会话的 intra-op 与 inter-op 线程数,DLL 把它钳到活动处理器数。两个线程共享一个引擎,推理永远不会并行;第二个等着。这个等待不是盲目的 EnterCriticalSection:适配器用 TryEnterCriticalSection 试锁,两次尝试之间睡 25 ms,每次都检查取消令牌和期限,排队中的请求仍然可以取消
期限时钟在进入 Recognize 时启动,早于拿锁。排在别的页面后面等锁的时间,也算进 TimeoutMilliseconds。四个 worker 线程挤一个引擎、期限 60 秒,第四页可能还没摸到模型就超时了。换成每个 worker 自己的引擎:代价是每个引擎在内存里多一份模型,这份内存换来可预测的超时和真并行;只有请求少到几乎不排队的场合,共享一个引擎才说得过去
为什么原生 OCR 调用没法在推理中途被杀?
原生 RapidOCR 调用没法在推理中途被杀:它跑在你的线程上、你的进程里、一个对进行中的 Run 没有中断 API 的 ONNX Runtime 会话中间。DLL 适配器的取消因此是协作式的。DLL 在检测前后、每个裁切分类之后、每识别完一行之后调用中止回调,在回调返回 0 的第一个检查点停下。已经开始的那次 Run 总要跑完
强硬手段都比等待更糟。TerminateThread 会把 CRT 堆锁、ONNX Runtime 的线程池和任何 OpenCV 状态留在它碰巧所处的状态下。调用还在执行时调 FreeLibrary,卸载的是栈上正在执行的代码。两者都做不出安全版本,适配器从不尝试。到期的期限以 otlsEngineError 带超时诊断返回;取消的令牌以 otlsCancelled 返回:
// Token 由调用者创建并与 UI 线程共享,
// 用户按下停止时 UI 线程调用 Token.Cancel
function OcrWithStop(Doc: THotPDF; const Engine: IHPDFOCREngine;
  Token: THPDFCancellationToken): Boolean;
var
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  Options := THPDFOCRTextLayerOptions.Default;
  Options.CancellationToken := Token;
  Result := Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info);
  if not Result then
    case Info.Status of
      otlsCancelled:
        // 在下一个阶段或行检查点停下;文档不变
        Writeln('Cancelled');
      otlsEngineError:
        // 包含协作式期限到期与原生诊断
        Writeln('Engine: ', string(Info.Diagnostic));
      otlsBudgetExceeded:
        // Options 里的页面、像素、词数或内容上限被触及
        Writeln('Budget: ', string(Info.Diagnostic));
    else
      Writeln(string(Info.Diagnostic));
    end;
end;
这就是进程适配器与进程内 DLL 之间真正的取舍,没有哪一边在每一行都赢:
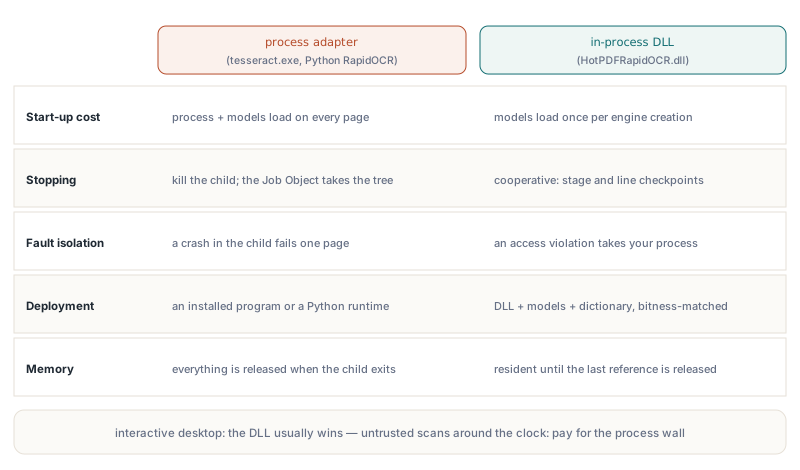
- 启动成本:Tesseract 与 Python RapidOCR 适配器每页都要起进程、加载模型;DLL 每个引擎只加载一次模型
- 停止:子进程可以直接终止,Python worker 跑在关闭即杀的 Job Object 里、整棵进程树一起走;DLL 只能在阶段与行检查点停下
- 故障隔离:
tesseract.exe崩溃只废一页;DLL 内部的访问违例带走你的整个进程 - 部署:进程适配器需要装好的程序或 Python 环境;DLL 需要它自己、它的模型和字典,并与应用的位数匹配
- 内存:子进程退出时进程适配器全部释放;DLL 引擎的模型常驻到最后一个接口引用消失
一次 OCR 一页、需要一个能在一次推理阶段内返回的响应式停止按钮的交互式桌面应用,选 DLL。全天候吞不可信扫描件的服务器,花那点每页启动成本、保留进程边界:一张构造出来能让识别器崩溃的图片,应该只废一页——有子进程在,它就只废一页
构建 HotPDFRapidOCR.dll 与挑选模型
HotPDFRapidOCR.dll 用 MSVC、C++17、Windows SDK 和 CMake 3.20 或更高版本,从 Native/RapidOCR 的 C++ 源码构建。tools/Build-HotPDFRapidOCR.ps1 辅助脚本接收原生源码、ONNX Runtime 与 OpenCV 目录,外加 -Platform Win32 或 Win64,把产物写到 Lib/Native/RapidOCR/<Platform>/。两个位宽都发布就都构建:32 位 Delphi 应用加载不了 64 位 DLL,你准备的静态库也必须同时匹配目标架构与 CRT 模式
模型有自己的兼容规则。检测器是 DB 文本检测器。识别器接受 NCHW 布局、固定输入高度 32 或 48 的 CTC 模型,模型声明动态高度时按 48 跑。模型格式必须是静态链接的 ONNX Runtime 认得的;PP-OCRv5 这类新导出可能要求更新的运行时,读不了的模型带着诊断在初始化时失败。tools/Install-RapidOCRModels.ps1 安装按钉死的 SHA256 哈希验证过的 PP-OCRv3 与 PP-OCRv4 包,共享检测器与分类器放在 Default 期望的文件名下。不去掌控运行时构建的话,就守着这些包
字典必须是无 BOM 的 UTF-8,字符顺序与模型完全一致,条目数必须与模型输出类数匹配。CRLF 行尾没问题。模型在元数据里内嵌自己的字符列表时,模型初始化会把每个条目及其位置与字典文件比对,所以只是长度对的字典照样失败。DLL 从不下载缺失的模型
HotPDF 把原生 RapidOCR 适配器与基于进程的 OCR 适配器、喂养它们的页面渲染器、不可见 Unicode 文本层写入器打包在一起,全部装进一个面向 Delphi 与 C++Builder 的原生 VCL 组件。对要在没装 Python 的机器上产出可搜索 PDF 的采集与归档软件,HotPDF Delphi PDF component 让你只剩 DLL 和它的模型文件要部署