一根永远不报文件结尾的管道,是 OCR 功能里很难追的怪 bug。你应用里的一个线程读辅助程序的标准输出,等 ReadFile 以 ERROR_BROKEN_PIPE 失败。另一个线程经 CreateProcess 启动 tesseract.exe,bInheritHandles 设为 True——因为要给子进程一个标准错误文件就是这么干的。辅助程序的管道写端是可继承的,于是 Tesseract 也握有一份拷贝,读线程就挂着,一直挂到 Tesseract 跑完这一页 — 而在装了两个语言模型的 300 DPI 扫描件上,这并不快
外部识别器带来的不只是这个挂死:子进程能看见什么、对半有效的输出怎么办、像素框怎么变成可搜索的 PDF 文本。内置模板匹配 OCR 引擎刻意只覆盖机打的 ASCII 字母和数字。带重音的人名、中文合同、混合语言的档案需要训练过的语言模型,而 Tesseract 是顺理成章的候选——它是个命令行程序,可以装在你的可执行文件旁边
把 Tesseract 接进 HotPDF 的 OCR 文本层
HotPDF 经 HPDFTesseractRecognition 单元里的 HPDFCreateTesseractOCREngine 把本地安装的 Tesseract 可执行文件包装成 IHPDFOCREngine。把引擎交给 THotPDF.ApplyLoadedOCRTextLayer:它渲染每个请求的页面,每页跑一次 Tesseract,过滤单词,然后以一个事务为所有请求页面写入不可见 Unicode 文本层——要么全写,要么一个都不写。坐标映射、旋转、置信度过滤和提交都是内置引擎已有的管线;变的只有识别
工厂在任何页面被碰之前就抛 EArgumentException:可执行文件与 tessdata 目录必须存在,超时必须在 1 到 3,600,000 毫秒之间,语言只能含 ASCII 字母、数字、_ 和 +——它终究要上命令行:eng+chi_sim 合法,带引号或空格的值是等着发生的注入。第二个重载接收 THPDFTesseractOptions 记录,其 Default 给出 --psm 3、--oem 3、每页 60 秒和 16,777,216 像素上限,并拒收 tpsOSDOnly 和 tpsAutoOnly 这两个不出词的模式
uses
  SysUtils, HPDFTypes, HPDFDoc, HPDFTesseractRecognition;

function MakeSearchable(const SourceFile, TargetFile: string;
  Token: THPDFCancellationToken): Boolean;
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  TessOptions: THPDFTesseractOptions;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  TessOptions := THPDFTesseractOptions.Default; // psm 3、oem 3、60 秒、16,777,216 像素
  TessOptions.TimeoutMilliseconds := 120000;    // 作用于每一页
  // 缺可执行文件或缺 tessdata 目录、语言标识非法、
  // 或选项超出范围时抛 EArgumentException
  Engine := HPDFCreateTesseractOCREngine(
    'C:\OCR\Tesseract\tesseract.exe',
    'C:\OCR\Tesseract\tessdata',
    'eng+chi_sim',                              // 多个模型用 '+' 连接
    TessOptions);
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default; // 300 DPI,MinimumConfidence 0.5
    Options.CancellationToken := Token;
    // 空页面列表 = 每一页;已有文本的页面跳过
    Result := Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info);
    if Result then
    begin
      Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
        ' words kept, ', Info.DroppedWordCount, ' below the threshold');
      Doc.SaveLoadedDocument(TargetFile);
    end
    else
      case Info.Status of
        otlsCancelled:      Writeln('Cancelled, document unchanged');
        otlsEngineError:    Writeln('Engine: ', string(Info.Diagnostic));
        otlsBudgetExceeded: Writeln('Budget: ', string(Info.Diagnostic));
      else
        Writeln(string(Info.Diagnostic));
      end;
  finally
    Doc.Free;
  end;
end;
像素算术一次做清。A4 页面在 300 DPI 下约 2,481 × 3,508 像素,合 870 万上下,装得下。同分辨率的 A3 约 3,508 × 4,961,接近 1,740 万,于是带着像素预算诊断失败,运行以 otlsEngineError 收场。只收超时的那个重载完全不设像素上限。接收外部文件的服务请留在选项重载上,预期大格式时有意调高 MaxPixels(至多 67,108,864)或调低 THPDFOCRTextLayerOptions.DPI
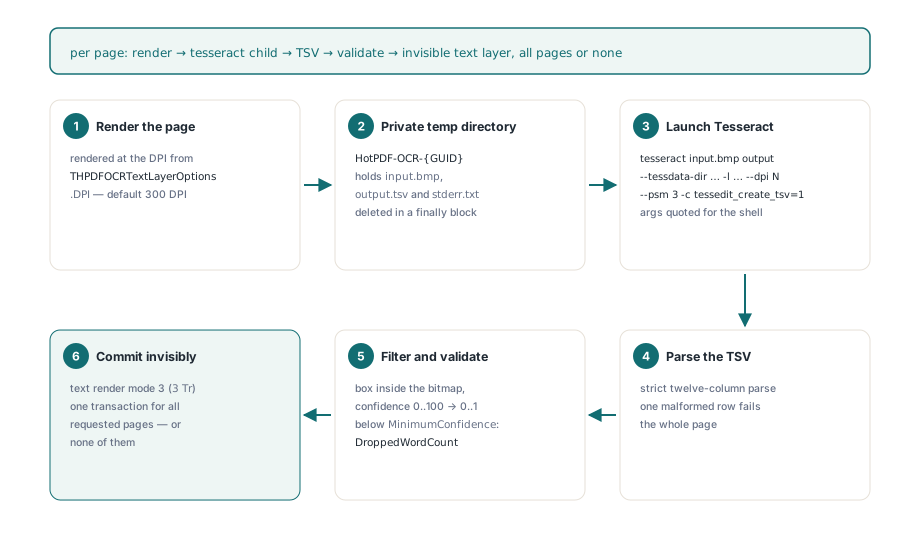
每一页,引擎在临时路径下创建私有的 HotPDF-OCR-{GUID} 目录,把位图存成 input.bmp,运行 tesseract input.bmp output --tessdata-dir … -l … --dpi N --psm 3 -c tessedit_create_tsv=1,设置了引擎模式时再加 --oem。路径按 Windows 的反斜杠与内嵌引号规则加引号,--dpi 带上渲染分辨率,Tesseract 从不必猜。Tesseract 及其 .traineddata 文件不随包发布;准备好它们是应用自己的事。在我们自己的 Linux 测试机上,识别器跑在用户级的二进制加共享库闭包加 tessdata 目录的捆绑包里,因为依赖 /usr/bin/tesseract 只在有人装了系统包的机器上成立
为什么一行坏 TSV 会清空整页
Tesseract 适配器在第一行畸形数据上就让整页失败,因为部分解析出的词表会产生一个与图像不一致的文本层,而保存后的 PDF 里没有任何东西说明哪些词丢了。输出必须按严格 UTF-8 解码、不含内嵌 NUL。剥掉可选字节顺序标记后,第一行必须等于 Tesseract 的十二列表头,从 level 到 text。每行必须恰好拆成十二个字段,拆分在第十一个 tab 之后停止,于是识别文本里的 tab 落进 text 字段,而不是造出第十三列——那里会被下面的控制字符检查拒掉
只有 level 5 行是词;页、块、段落和行的行被跳过,空词和纯空白词同样跳过。含控制字符(U+0020 以下,或 U+007F 到 U+009F)的词让整页失败。其余各列要求整数几何、按不变式格式解析的置信度——德语 locale 的应用照样读得懂 93.5、完全落在位图之内的框、以及 0 到 100 的置信度。一个合法词后跟一行坏数据,得到零个词
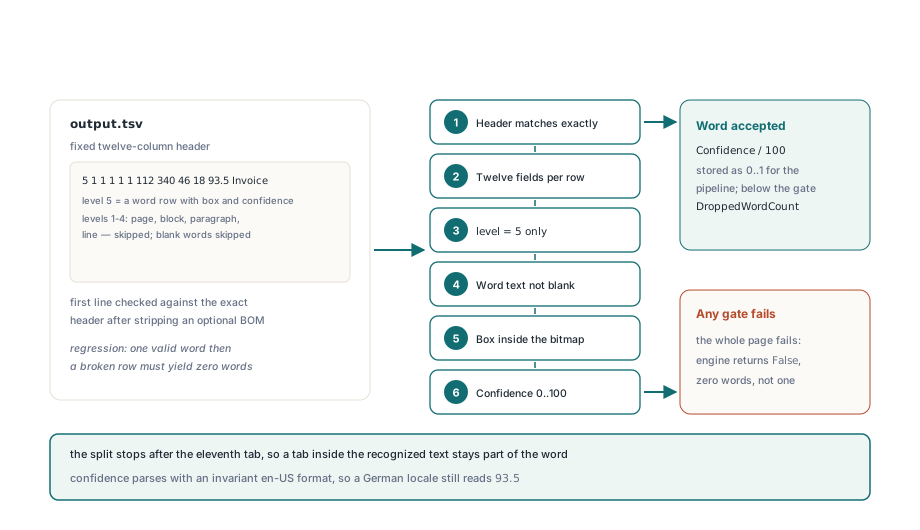
于是一行不寻常的数据让整次运行失败,每一页都原封未动。这是正确的取舍:重跑很便宜;而一份可搜索 PDF 里,发票号偏偏搜不到关键那一页这种事,往往几个月后才发现,还是在别人手里
最后一步还牵出一个你可能想不到的默认值。Tesseract 置信度从 0 到 100,管线除以 100,THPDFOCRTextLayerOptions.MinimumConfidence 默认 0.5,于是低于 50 的词都进了 Info.DroppedWordCount 而不是页面。干净的扫描件上这个地板合理;嘈杂的传真件上它可能吃掉大半文本,所以降阈值之前先对比 Info.ReceivedWordCount 与 Info.AcceptedWordCount
对已有文本的文件再跑一次 OCR
SkipPagesWithText 默认为 True,第二次处理时会咬人。假设一批文件先用 eng 处理过、现在要换 eng+deu:每页都已带不可见文本,Info.SkippedPageCount 于是等于页数。HotPDF 在自己写的内容流上打上 OCR 层标记,ReplaceExistingOCRTextLayer 借这个标记重新识别那些页面,丢弃旧层、保留原页面内容
Options := THPDFOCRTextLayerOptions.Default;
Options.ReplaceExistingOCRTextLayer := True;  // 换掉我们早先写的层
Options.UseOptionalContentGroup := True;      // 层名为 'OCR Text Layer'
Options.CancellationToken := Token;
if Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
  Writeln(Info.ReplacedPageCount, ' replaced, ',
    Info.SkippedPageCount, ' skipped, ',
    Info.RecognizedPageCount, ' recognized')
else
  Writeln(string(Info.Diagnostic));
扫描仪驱动 OCR 过的文件没有这种标记,它的页面仍算有文本的页面。把 SkipPagesWithText 关掉,第一层之上再叠第二层不可见层,每次搜索命中都会出现两次。那些文件别碰
Tesseract 子进程继承了哪些句柄
Tesseract 子进程从 HotPDF 恰好继承两个句柄:一个开在 NUL 上,供标准输入和输出;另一个是私有目录里的 stderr.txt。上面的管道挂死出自 CreateProcess 本身:传标准句柄要求 bInheritHandles = True,而它自己会把宿主里每个可继承句柄都传过去——包括无关代码打开的管道、文件和事件。HotPDF 用 STARTUPINFOEX 加携带 PROC_THREAD_ATTRIBUTE_HANDLE_LIST 的属性列表和 EXTENDED_STARTUPINFO_PRESENT 标志。bInheritHandles 保持 True,但过界的只有列出的句柄
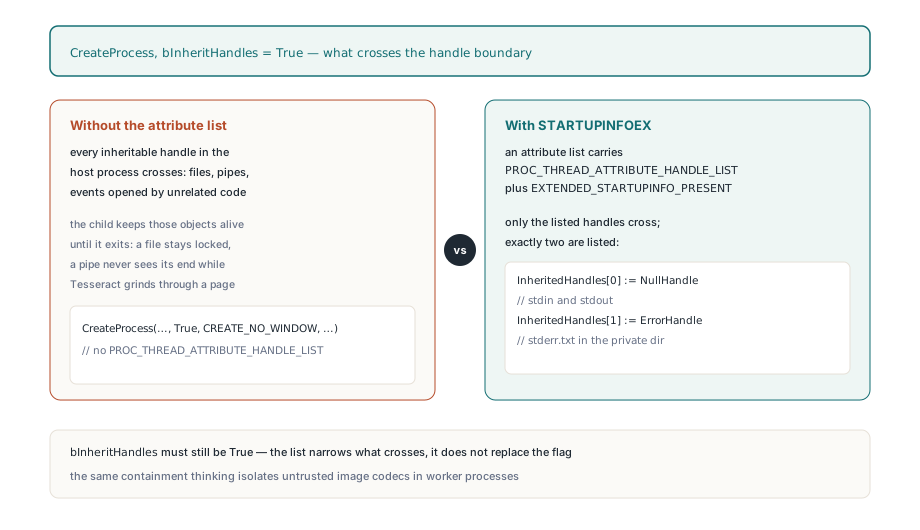
你的应用启动的每个其他子进程也该用同一模式,因为一个什么都继承的启动器,就足以挂死进程里每一个管道读者:
// 你自己的 CreateProcess 调用模式(片段:NullHandle、ErrorHandle、
// Exe、CommandLine、WorkDir 与 ProcessInfo 在别处声明)。
// 旧 Delphi RTL 不声明属性列表函数;编译器找不到时,
// 从 kernel32 自己补 external 声明
// 产品代码里检查每个 BOOL 返回值
type
  TStartupInfoExRec = record
    StartupInfo: TStartupInfo;
    AttributeList: Pointer;
  end;
const
  HANDLE_LIST_ATTRIBUTE = $00020002;   // PROC_THREAD_ATTRIBUTE_HANDLE_LIST
  EXTENDED_STARTUP_FLAG = $00080000;   // EXTENDED_STARTUPINFO_PRESENT
var
  Startup: TStartupInfoExRec;
  HandleList: array[0..1] of THandle;
  Size: NativeUInt;
begin
  FillChar(Startup, SizeOf(Startup), 0);
  HandleList[0] := NullHandle;         // 以 bInheritHandle = True 创建
  HandleList[1] := ErrorHandle;        // 同样
  Size := 0;
  InitializeProcThreadAttributeList(nil, 1, 0, Size);
  GetMem(Startup.AttributeList, Size);
  InitializeProcThreadAttributeList(Startup.AttributeList, 1, 0, Size);
  UpdateProcThreadAttribute(Startup.AttributeList, 0, HANDLE_LIST_ATTRIBUTE,
    @HandleList[0], SizeOf(HandleList), nil, nil);
  Startup.StartupInfo.cb := SizeOf(Startup);
  // ... dwFlags 与 hStdInput / hStdOutput / hStdError 照常设置 ...
  CreateProcess(PChar(Exe), PChar(CommandLine), nil, nil,
    True,                              // 有句柄列表时仍然必须
    CREATE_NO_WINDOW or EXTENDED_STARTUP_FLAG,
    nil, PChar(WorkDir), Startup.StartupInfo, ProcessInfo);
  // 子进程退出后:DeleteProcThreadAttributeList、FreeMem、CloseHandle
end;
桥接脚本还添了一层 Windows 细节。Python 启动器可以再起一个解释器进程,终止你创建的那个,另一个还活着。引擎拿到脚本路径时——比如下文的 RapidOCR 适配器——HotPDF 先挂起子进程,把它放进带 JOB_OBJECT_LIMIT_KILL_ON_JOB_CLOSE 的 job object,再恢复运行,关掉 job 整棵进程树跟着走。同样的围栏思路驱动着 在工作进程里隔离 PDF 图像编解码器——那边子进程不可信;这边子进程可信,但在你的进程里握句柄的并非只有你一家
取消、超时与全有或全无的提交
IHPDFOCREngine.Recognize 只返回一个布尔值,False 同时盖住“Tesseract 失败”和“用户按了取消”。Tesseract 运行期间,适配器每 25 毫秒轮询令牌和超时,取消时清理并返回 False。按字面理解这会读成 otlsEngineError,所以 ApplyLoadedOCRTextLayer 在 Recognize 返回 False 时先查令牌。每个请求页面的识别与内容构建都在文档事务打开之前完成,所以 50 页中的第 40 页被取消时报告 otlsCancelled,50 页全部保持加载时的样子。其余限制遵循同一风格:
- 超时从每次
Recognize调用开始时起算,60,000 ms 默认值是每页上限 - 超时或取消时仍在运行的子进程被终止并至多等待 5 秒;私有目录在
finally块里删除,删除最多重试一秒,因为进程结束后输出文件可能短暂锁定 output.tsv封顶 64 MiB,stderr.txt封顶 1 MiB,子进程运行中和退出后都检查- 每页的词数与 UTF-16 码元按
MaxWordsPerPage、MaxTotalWords和MaxTextCodeUnits的剩余预算封顶;超限让整次运行失败,而不是截断词表 - 非零退出码附
stderr.txt的至多 4,096 字符返回——发现缺了某个.traineddata文件的最快途径
不可见文本层在页面内部长什么样
HotPDF 以文本渲染模式 3 写词(既不填充也不描边,ISO 32000-1 §9.3.6),扫描图像保持可见,搜索与复制作用在词上。内容流以 3 Tr 打开 BT;每个词拿到一个落在其基线上的 Tm 矩阵、一个按“框高像素 × 72 ÷ 渲染 DPI”算出的字号,以及把整串拉伸到框宽的 Tz 缩放。这层拉伸让搜索高亮停在图像里那个词上
TSV 有框没有基线,所以每条基线放在底边上方五分之一框高处。拉丁、西里尔这类空格分隔文字的行内相邻词之间,拉伸的空格填住间隙,复制出来的文本保留分词;中文则没有。字形经共享的未嵌入 Type0 字体、Identity-H 编码和生成的 ToUnicode CMap 输出,每个不同 Unicode 标量一个 CID——中文、带重音拉丁文和增补平面字符因此在复制与搜索中都活下来。一次运行至多 65,535 个不同标量;ISO 19005 要求嵌入字体,所以 PDF/A 输出需要另行嵌入合规字体。验证结果:保存、重载,跑从已加载 PDF 提取文本的普通路径;预期词在预期页面上回来了,层就是真的
同一契约上的 RapidOCR 与原生 DLL
简体中文扫描件,HPDFCreateRapidOCREngine(PythonExecutable, BridgeScript, ModelDirectory, TimeoutMilliseconds) 复用同一个进程运行器和 TSV 解析器。桥接脚本路径跟在 Python 可执行文件之后,语言固定为 chi_sim。HotPDF 以 tools/OCR/rapidocr_tsv.py 随附桥接脚本:它需要 rapidocr 与 onnxruntime 包、本地 ONNX 模型和一个字体文件,拒绝自动下载,写出 Tesseract 形状的 TSV;THPDFRapidOCROptions 重载可设模型文件、线程数和像素上限。两个适配器背后的通用工厂是 HPDFLocalTSVRecognition 里的 HPDFCreateLocalTSVOCREngine,接受任何吃 Tesseract 风格实参、写十二列 TSV 的程序,并继承句柄列表、超时、取消和预算
HPDFCreateTesseractDLLOCREngine(LibraryPath, TessDataDirectory, Language) 改为在进程内加载 Tesseract C API,自报 Tesseract (native DLL),预先检查每个请求的 .traineddata 文件存在,并把取消与超时映射到 Tesseract 自己的进度 monitor 上。它每页省一次进程启动加一趟 BMP 往返;可执行文件版则把识别器的崩溃与内存增长挡在你的地址空间之外。处理用户自己扫描件的桌面工具,DLL 没问题;吞陌生人文档的服务,命令行引擎更稳妥。无论哪个,识别都跑在 Windows、一次一页、渲染出的位图上——难啃的扫描件先去斜、先清理,再送进引擎
OCR 适配器、文本层写入器、喂养它们的渲染器和核验输出的提取,都住在一个面向 Delphi 与 C++Builder 的原生 VCL 组件里。你的采集或归档应用需要可搜索 PDF 输出时,HotPDF Delphi PDF component 包办除你自己安装的 OCR 引擎之外的一切