一份俄语发票交给加载了西里尔模型、却仍在读中文字符字典的识别器,回来的是一行行完全合法的汉字。每一行都是格式良好的 UTF-8,每一行都进了可搜索文本层,可页面上印着的任何词都搜不到。模型没做错什么:CTC 识别器从不输出字符,只输出类编号,把类 1,204 映射到一个字形的,全靠字典文件
旁边还躺着三个同源的失败,拉丁字母的 demo 一个都遇不到:每一行丢掉最后一个字符;英文回来没有词间距;阿拉伯语文本框按从左到右的顺序返回。每一个都能追到一条字典规则、一个循环边界或一种排序——都容易做得「差不多对」。连同开头那个,四个坑的起点是同一处:把语言标签变成模型加字典的那一步
HotPDF 的 RapidOCR 语言预设:一个标签,钉死的一对
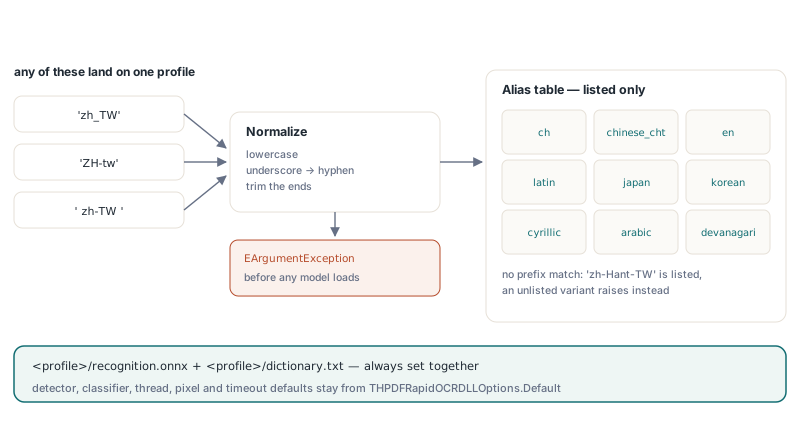
在 HotPDF 里,THPDFRapidOCRDLLOptions.ForLanguage 把语言标签变成一组选项,指向模型目录下的 <profile>/recognition.onnx 和 <profile>/dictionary.txt。其余一切都来自 THPDFRapidOCRDLLOptions.Default:共享的检测器、可选的角度分类器、单线程、每次请求 16,777,216 像素的预算和 60 秒超时。标签会转小写、下划线换成连字符、首尾空白去掉,所以 'zh_TW'、'ZH-tw' 和 ' zh-tw ' 都落在同一个配置上
匹配走显式的别名清单,没有前缀匹配。'zh-Hant-TW' 和 'zh-MO' 被接受,是因为清单里列了它们;'pt-AO' 没列,ForLanguage 在打开任何文件之前就抛 EArgumentException。这份严格是刻意的:前缀规则会悄悄把 'zh-Hant-SG' 或某个未来的标签发给碰巧共享前两个字母的配置,而对中文来说,前两个字母根本说明不了文字种类
| 配置 | 语言 | 示例标签 | 行内框顺序 |
|---|---|---|---|
ch | 简体中文与英文 | zh、zh-CN、zh-Hans、chi_sim | 从左到右 |
chinese_cht | 繁体中文 | zh-TW、zh-HK、zh-Hant、chi_tra | 从左到右 |
en | 英文 | en、en-US、en-GB、eng | 从左到右 |
latin | 法语、德语、西班牙语、葡萄牙语、意大利语、荷兰语、土耳其语 | fr、de、es-419、pt-BR、tr | 从左到右 |
japan | 日语 | ja、ja-JP、jpn | 从左到右 |
korean | 韩语 | ko、ko-KR、kor | 从左到右 |
cyrillic | 俄语、乌克兰语、保加利亚语、白俄罗斯语 | ru、ru-RU、uk、bg | 从左到右 |
arabic | 阿拉伯语、波斯语、乌尔都语 | ar、ar-SA、fa、ur | 从右到左 |
devanagari | 印地语、马拉地语、尼泊尔语 | hi、mr、ne | 从左到右 |
适配器自己从不下载任何东西。模型文件用随附的辅助脚本一次性准备好,比如 tools/Install-RapidOCRModels.ps1 -Destination C:/OCR/models -Language ch,chinese_cht,cyrillic,或用 -Language All 装全部九个配置。脚本会把共享检测器与分类器放到 Default 期望的根文件名上,每个配置各占一个文件夹。引擎创建、DLL 边界与线程模型见进程内 RapidOCR DLL 一文;文件就位后,一份简体中文扫描件这样变得可搜索
uses
  SysUtils, HPDFDoc, HPDFRapidOCRRecognition;

procedure MakeChineseScanSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Models: THPDFRapidOCRDLLOptions;
  Layer: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // ch/recognition.onnx + ch/dictionary.txt,共享检测器与分类器
  Models := THPDFRapidOCRDLLOptions.ForLanguage('zh-CN');
  // 模型在这里加载;引擎应跨文档复用
  Engine := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models', Models);
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Layer := THPDFOCRTextLayerOptions.Default;  // 300 DPI,MinimumConfidence 0.5
    // 空页面列表 = 全部页面;SkipPagesWithText 不动已有文本的页面
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Layer, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' lines, ', Info.UniqueScalarCount, ' distinct characters');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;
那段输出里有两个数字要仔细读。原生流水线每个检测到的文本行报告一个结果,所以这里 AcceptedWordCount 数的是行,MinimumConfidence 对照的是整行的平均字符置信度:平均 0.45 的一行整个被丢。UniqueScalarCount 是文本层映射进字体和 ToUnicode 表的不同 Unicode 标量个数。中文正文页面的这个数字应该远超拉丁页面需要的几十个;中文扫描件上数出拉丁量级,通常说明加载错了配置
为什么只换识别模型会产出垃圾?
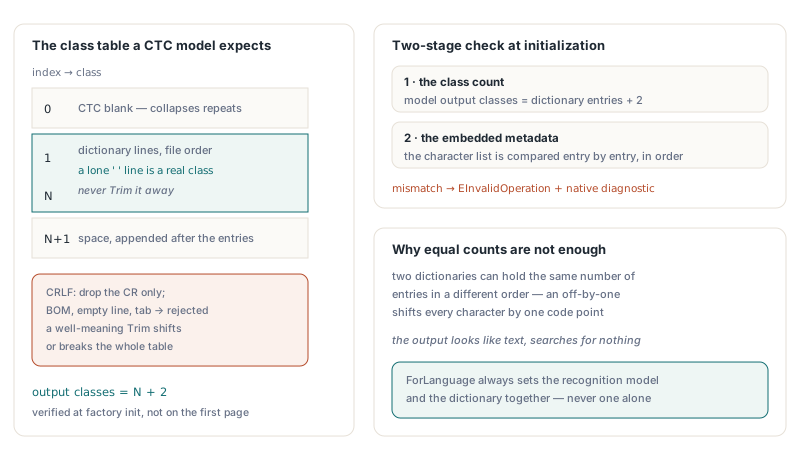
因为模型和字典是同一张查找表的两半,只有字典知道这些索引是什么意思。把 RecognitionModel 指到 cyrillic/recognition.onnx,CharacterDictionary 却还指着中文文件,模型就会发出合法的西里尔索引,旧字典再把它们译成随机的汉字。ForLanguage 总是把两个字段一起设置;手工构建的选项也该遵守同一规则:绝不只改其一
直觉上的防线——拿字典大小与模型输出宽度比对——必要但仍不够。两本字典可以条目数相同而顺序不同,顺序上差一,每个字符就错位一位。所以 HotPDF RapidOCR DLL 在工厂初始化识别器时检查两遍:模型输出类数必须等于字典条目数加二;接着,若 ONNX 文件内嵌 character 元数据列表,每个字典行都与它按序比对。任一不匹配都会让 HPDFCreateRapidOCRDLLOCREngine 带着原生诊断抛出 EInvalidOperation,错误在启动时就浮出来,而不是埋在客户的档案里
「加二」来自类布局:类 0 是 CTC blank,类 1 到 N 是按文件顺序的字典行,最后一个类是空格。有些字典还自带单个空格条目,那一行必须原样保留。好心的 Trim 正是在这里闯祸:它把空格条目变成空字符串,挪动甚至弄坏整张表。DLL 只去掉行尾的回车符,让 CRLF 行尾的文件能加载;UTF-8 字节顺序标记、空行、含制表符或多余回车符的条目一律拒收
如果你自己维护字典,在构建或部署脚本里加一道预检,就能赶在引擎之前抓住这些问题。下面的函数是你自己的代码,按上面的规则写成
// 你自己的辅助函数,不是 HotPDF API:构建 CTC 识别器
// 期望的类表,并拒收 DLL 会拒收的那些字典缺陷
uses
  SysUtils, IOUtils;

function BuildCTCClassTable(const FileName: string): TArray<string>;
var
  Text, Entry: string;
  Lines: TArray<string>;
  I, Last: Integer;
begin
  Text := TEncoding.UTF8.GetString(TFile.ReadAllBytes(FileName));
  if (Text <> '') and (Text[1] = #$FEFF) then
    raise EArgumentException.Create('Dictionary must be UTF-8 without a BOM');
  Lines := Text.Split([#10]);
  Last := High(Lines);
  if (Last >= 0) and (Lines[Last] = '') then
    Dec(Last);                                   // 文件末尾的换行
  if Last < 0 then
    raise EArgumentException.Create('Dictionary is empty');
  SetLength(Result, Last + 3);
  Result[0] := '';                               // 类 0:CTC blank
  for I := 0 to Last do
  begin
    Entry := Lines[I];
    if (Entry <> '') and (Entry[Length(Entry)] = #13) then
      SetLength(Entry, Length(Entry) - 1);       // CRLF:只去掉 CR
    if (Entry = '') or (Pos(#9, Entry) > 0) or (Pos(#13, Entry) > 0) then
      raise EArgumentException.CreateFmt('Invalid dictionary line %d', [I + 1]);
    Result[I + 1] := Entry;                      // 绝不 Trim:' ' 本身是一个类
  end;
  Result[Last + 2] := ' ';                       // 最后一个类:空格
  // Length(Result) 必须等于模型输出类数
end;
贪心 CTC 解码与它的三个边界陷阱
贪心 CTC 解码在每个时间步挑得分最高的类,把连续重复坍缩成一个字符,并丢掉 blank。正是 blank 让真正成双的字母得以幸存。识别模型把一行文本看成一系列窄窄的竖直切片,对每个切片给出每个类的概率。含 AA中 的行可能产出 argmax 序列 A A blank A 中 space:前两个 A 步坍缩成一个,blank 把它与下一个 A 隔开,输出就是尾部空格完好的 AA中 。没有 blank 规则,book 和 bok 会解出同样的结果
写得短小的解码器容易犯差一错误,而且每种错误都有自己可辨认的症状。内层 argmax 循环提前一个类停住,space 类就永远赢不了,英语或拉丁文本每一行都回来成一整个长词,短语搜索就此失灵。外层循环提前一个时间步停住,每行的最后一个字符消失,两字符的标签上那就是一半文本。忘了让 blank 重置重复守卫,成双的字符就坍缩:hello 里的 ll,或者叠词 谢谢。你要是给自己的流水线写解码器,这三个用例就是一套紧凑的测试集。HotPDF 的解码器覆盖最后一个类和最后一个时间步,保留被 blank 分隔的重复,并拒收非有限值、落在 0 到 1 之外的分数,以及与字典不符的类数
// 为你自己的流水线作示意,不是 HotPDF API:边界正确的
// 贪心 CTC 解码。Scores 存 Steps * Classes 个概率,
// 每个时间步一行
function GreedyCTCDecode(const Scores: array of Single;
  Steps, Classes: Integer; const Characters: array of string): string;
var
  Step, C, Best, Previous: Integer;
  BestScore: Single;
begin
  if (Classes < 3) or (Length(Characters) <> Classes) or
    (Length(Scores) <> Steps * Classes) then
    raise EArgumentException.Create('Model output does not match the dictionary');
  Result := '';
  Previous := 0;                            // 类 0 是 CTC blank
  for Step := 0 to Steps - 1 do             // 包含最后一个时间步
  begin
    Best := 0;
    BestScore := Scores[Step * Classes];
    for C := 1 to Classes - 1 do            // 包含最后一个类(空格)
      if Scores[Step * Classes + C] > BestScore then
      begin
        Best := C;
        BestScore := Scores[Step * Classes + C];
      end;
    if (Best <> 0) and (Best <> Previous) then
      Result := Result + Characters[Best];
    Previous := Best;                       // blank 重置重复守卫
  end;
end;
带语言模型的 beam search 能纠正一些贪心解码看走眼的含糊切片,代价是实打实的速度损失,外加第二套要管版本号的文件。对 300 DPI 渲染的印刷文档,贪心解码就是正确的默认选择,而解码器不是补偿模型视而不见之处的地方。字符替换表也一样:模型把带附加符号的字母读成了基础字母,拿替换表去修补输出,修好一门语言,弄坏另一门。可搜索层里一个错字比缺一个字更糟——搜索会找错文档,而不是找不到文档——所以识别出的文本原样进 PDF,模型输出什么就是什么
从右到左的阿拉伯语怎么排文本行?
DLL 把检测到的文本框自上而下排序,垂直重叠不少于较小框高一半的框并成一行,行内从左到右排列——设了 RightToLeft 时则从右到左。识别出行内部的字符永不反转。行分组之所以要紧,是因为检测器常把一个视觉行拆成几个框,比如被宽缝隔开的标签和数值;纯按顶坐标排序,顶点只要差上一两个像素,它们就会与下一行交错
九个配置里只有阿拉伯语会让 ForLanguage 设 RightToLeft := True,效果是 DLL 按框的右边缘给每行排序,从右边距起往里排。仅此而已。模型为一行返回的文本已经是 Unicode 逻辑序——阿拉伯读者阅读和输入的顺序——这也正是 PDF 文本提取与搜索期望的顺序。为了让字符串在 Delphi 调试器里「看着对」而做反转,会弄坏搜索、复制粘贴和读屏器。双向显示与字形整形是 PDF 查看器的职责
一个引擎服务一个语言配置,也没有自动文字种类检测。混合文字种类的文档需要每个配置一个引擎,各自应用在自己的页面上。ApplyLoadedOCRTextLayer 接受显式页面列表,每次调用都是独立的事务,阿拉伯语页面上的失败会回滚那一次调用,不碰已经写好的中文层
uses
  SysUtils, HPDFDoc, HPDFRapidOCRRecognition;

function CreateRapidEngine(const Tag: string): IHPDFOCREngine;
var
  Models: THPDFRapidOCRDLLOptions;
begin
  // 未列出的标签会抛 EArgumentException,在任何模型加载之前
  Models := THPDFRapidOCRDLLOptions.ForLanguage(Tag);
  Models.MaxPixels := 33554432;          // 300 DPI 下 A3 页面的余量
  Result := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models', Models);
end;

procedure OCRMixedArchive(Doc: THotPDF);
var
  Chinese, Arabic: IHPDFOCREngine;
  Layer: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  Chinese := CreateRapidEngine('zh-TW');  // chinese_cht 配置
  Arabic := CreateRapidEngine('ar-SA');   // arabic 配置,RightToLeft = True
  Layer := THPDFOCRTextLayerOptions.Default;
  if not Doc.ApplyLoadedOCRTextLayer([0, 1, 2], Chinese, Layer, Info) then
    raise Exception.Create(string(Info.Diagnostic));
  if not Doc.ApplyLoadedOCRTextLayer([3], Arabic, Layer, Info) then
    raise Exception.Create(string(Info.Diagnostic));
end;
MaxPixels 那一行不是白写的。默认的每次请求 16,777,216 像素预算,A4 和 US Letter 在 300 DPI 下绰绰有余;A3 纸在 300 DPI 下约 3508 × 4961 像素,合 1,740 万上下,请求会被拒,Info.Diagnostic 报告请求无效或超像素预算。大格式要么把 MaxPixels 提到 67,108,864 的上限,要么调低 THPDFOCRTextLayerOptions.DPI。从右到左排序走 DLL 导出 HPDFRapidOCRSetReadingDirection,适配器只在设了 RightToLeft 时才查找它;没有该导出的 DLL 构建照样服务从左到右的配置,而用它创建阿拉伯语引擎会抛 EArgumentException,指名缺失的导出
钉死的模型包,以及自定义一对要通过什么
HotPDF RapidOCR DLL 静态链接了一个 ONNX Runtime,因此它只认这个运行时看得懂的 ONNX 文件格式版本,更新的不认。新的模型导出可能瞄准更新的格式,这类文件会在引擎创建时带着原生诊断被拒。正是这个配对约束,让每个语言包都指向一对能在随附运行时下加载并通过类检查的特定识别器与字典,也让语言包永远不追「最新」
Install-RapidOCRModels.ps1 在磁盘上强制这套配对。清单里每个文件都带 SHA256 哈希:已有文件哈希不同就中止安装,文件原地保留,由你决定挪走还是删除;每个下载先写临时名,哈希匹配后才挪到正式位置。这堵住的是字典问题的安静版本:有人手工往配置文件夹里拷了一个新的 recognition.onnx,类数恰好对上,于是第一个警报是客户说搜不到明明看得见的词。用 -SkipClassifier 安装的话,记得在选项里设 UseAngleClassifier := False,因为 Default 期望分类器文件存在,引擎创建时也会检查它
识别器加载时还检查模型的输入形状:接受固定高度 32 或 48 像素、或动态高度的 NCHW 浮点输入,动态高度按 48 跑。以其他固定高度导出的模型,引擎创建时会以「不支持的识别模型输入或输出形状」失败
九个配置都盖不住的文字,可以把 RecognitionModel 和 CharacterDictionary 指到自己的文件,上面所有检查照样适用——配错的一对在你自己的测试运行里、引擎创建时就失败。RapidOCR 配置都不合适的页面,面向可搜索 PDF 的 Tesseract 适配器接进同一个 ApplyLoadedOCRTextLayer 调用;机器印刷的 ASCII 表单,内置模板匹配 OCR 引擎连模型文件都不需要
语言预设、原生 RapidOCR 适配器和 OCR 文本层都包含在 HotPDF Delphi PDF Component 里,面向 Delphi、C++Builder 和 Windows 上的 FPC/Lazarus 项目